English
 Deutsch
 Polski
Mac Studio M5 jako lokalna stacja AI: porównanie M5 Max, M5 Ultra i Maca mini M6

Spis treści
Mac Studio może działać jako lokalna stacja AI, gdy duże modele, małe stanowisko i właściwy backend Apple są ważniejsze niż wymienna karta graficzna. Decyzja zaczyna się od budżetu pamięci, nie od najnowszej nazwy układu.
Aktualny podział produktów Apple jest jednoznaczny: Mac Studio z M5 Max lub M5 Ultra, a Mac mini z M6 albo M5 Pro. Mac Studio M6 nie jest więc udokumentowanym urządzeniem porównawczym. Poniższe wartości to specyfikacje, bez własnych benchmarków inferencji.
Trzy profile Apple
| Urządzenie | Pamięć zunifikowana | Udokumentowana przepustowość |
|---|---|---|
| Mac mini M6 | 16–32 GB | 153 lub 170 GB/s |
| Mac Studio M5 Max | 36–128 GB | 460 lub 614 GB/s |
| Mac Studio M5 Ultra | 96–512 GB | 1,2 TB/s |
Wartości dotyczą różnych konfiguracji; maksymalna specyfikacja nie jest częścią każdej wersji podstawowej. Nowsza nazwa M6 nie czyni małego mini większą platformą modeli. Pierwszy budżet wag określa faktycznie zamówiona pojemność.
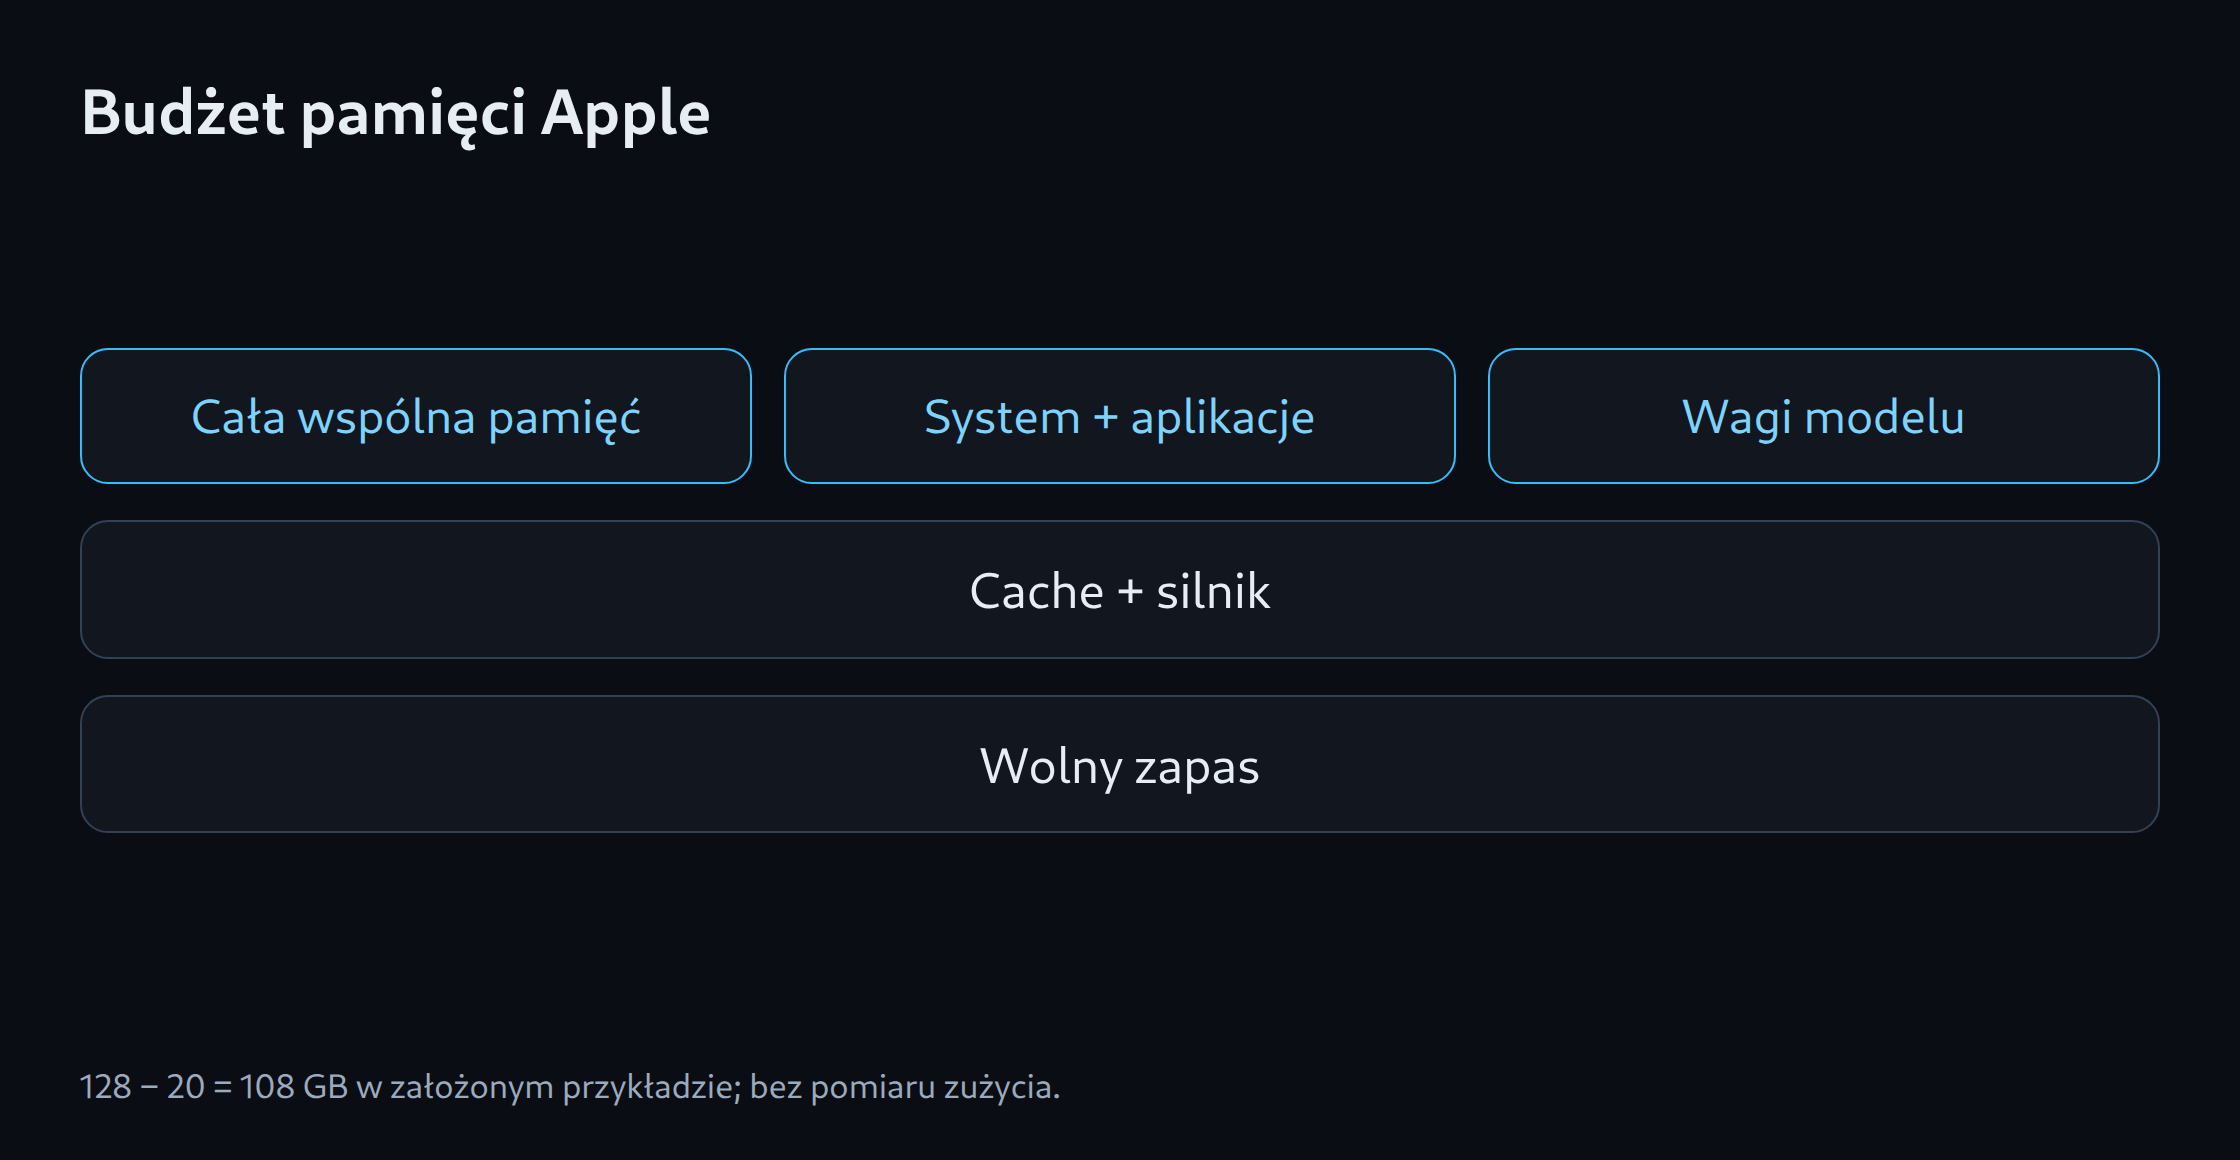
Pamięć zunifikowana to wspólny budżet
CPU, GPU, system i aplikacje współdzielą pamięć. Łączne 512 GB nie oznacza 512 GB swobodnie dostępnych dla wag. Stan modelu, pamięć podręczna i bufory tymczasowe zwiększają zapotrzebowanie. Inne aplikacje także zmieniają zapas.
Założony budżet 128 GB z rezerwą 20 GB dla systemu pozostawia 108 GB na model i środowisko. Wartość 20 GB jest założeniem planowania, nie pomiarem ani wymaganiem Apple. Stała usługa potrzebuje rzeczywistego pomiaru zajętości pod typowym obciążeniem.
MLX, llama.cpp i Ollama
MLX LM zapewnia ścieżkę Apple Silicon. llama.cpp obsługuje Apple Silicon przez Metal i optymalizacje CPU. Ollama także dokumentuje obsługę Apple oraz rozwija backendy. Wersja środowiska określa rzeczywiste formaty i przyspieszenie.
Kwantyzacja MLX i artefakt GGUF pozostają różnymi plikami. Porównanie wymaga tej samej rewizji źródłowej, zgodnych szablonów czatu i zapisanej precyzji. Bez tych danych innej odpowiedzi nie da się wiarygodnie przypisać zmianie backendu.
Neural Engine i przyspieszenie GPU
Apple opisuje Neural Accelerators wewnątrz GPU oraz osobny Neural Engine. Terminy nie są zamienne. Aplikacja LLM korzysta z funkcji sprzętowej przez odpowiednią ścieżkę programową. Sama liczba rdzeni Neural Engine nie potwierdza szybszego generowania.
Przy krótkim czacie liczy się niskie opóźnienie pierwszej odpowiedzi, a przy długim prompcie trzeba dodatkowo sprawdzić przetwarzanie danych wejściowych. Dla równoległych żądań potrzebny jest profil obsługi przez serwer. Duży model, który ledwie mieści się w pamięci, może nadal być zbyt wolny do pracy interaktywnej.
Wybór względem komputera tower i DGX Spark
Komputer z GPU zapewnia więcej wymiennych części i bezpośrednią ścieżkę CUDA przy odpowiedniej NVIDIA. DGX Spark to mała alternatywa CUDA z własną platformą ARM. Mac zapewnia zintegrowane stanowisko, ale wymaga zgodnych artefaktów i środowisk Apple.
Zakup powinien wynikać z zadania: mała lokalna pomoc na mini, większa pamięć i przepustowość na Studio oraz wysoka pojemność odpowiedniej wersji Ultra. Hałas, pobór z gniazdka i opóźnienia potrzebują pomiarów. Kalkulator pamięci wspiera selekcję; typowe zadania określają ostateczny wybór.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy aktualne porównanie obejmuje Maca Studio M6?
Apple obecnie dokumentuje Maca Studio z M5 Max lub M5 Ultra oraz Maca mini z M6. Plan zachowuje ten podział produktów. Późniejszy model Studio wymaga osobnych potwierdzonych danych.
Czy całe 512 GB pamięci zunifikowanej jest dostępne dla modelu LLM?
System, aplikacje i środowisko wykonawcze współdzielą pamięć. Pamięć podręczna lub stan modelu oraz bufory tymczasowe zwiększają zapotrzebowanie ponad same wagi. Dostępna pojemność zależy od konfiguracji, backendu i działających procesów.
Źródła
- Apple: Mac Studio M5 Max / M5 Ultra – technische Daten
- Apple: Mac mini M6 und Mac Studio M5 verfügbar
- MLX LM: Projekt
- llama.cpp: Projekt und Backends
- Ollama: Hardware support
- NVIDIA: DGX Spark Hardware Overview
- Apple: Mac mini – technische Daten
- Ollama: MLX on Apple Silicon
Źródła sprawdzone: 5 października 2026.
Powiązane artykuły