English
 Deutsch
 Polski
Reguły kanałów w GA4: jak kolejność sprawdzania decyduje o kanale

Spis treści
Raport pozyskiwania podaje kanał, a powód zachowuje dla siebie. Sesje pojawiają się jako Paid Other tam, gdzie oczekiwano Paid Search, kampania Performance Max znika całkiem z wyszukiwania, a link partnerski z tym samym medium co reklamy w wyszukiwarce ląduje gdzie indziej. Nic z tego nie jest błędem: to kolejność reguł, widoczna tylko dla tego, kto ją zna.
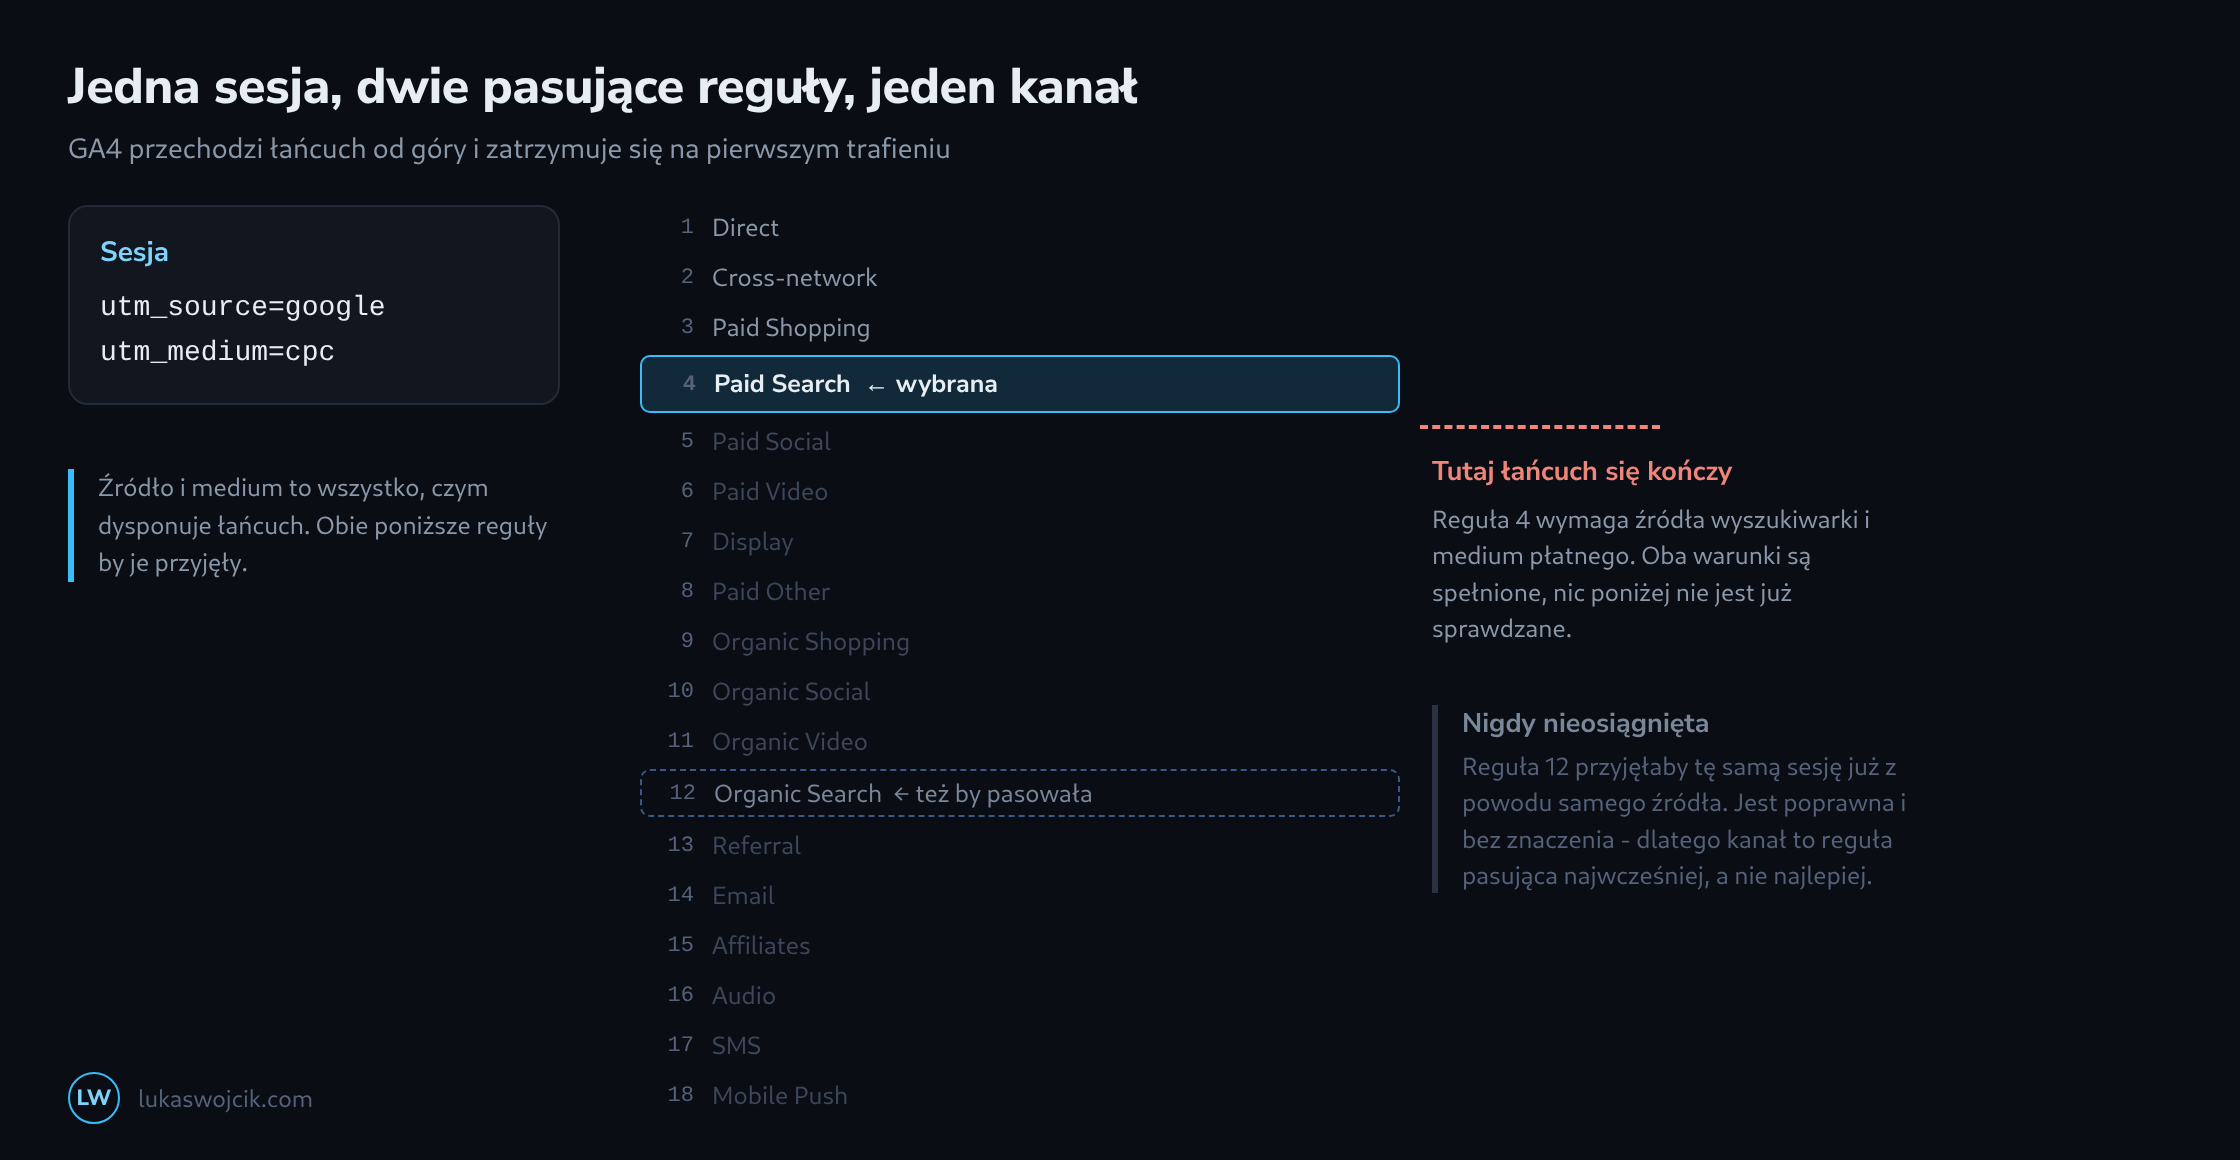
Domyślna grupa kanałów to łańcuch osiemnastu warunków. GA4 przechodzi go od góry, bierze pierwszy pasujący i kończy – reguły poniżej nigdy nie są sprawdzane. Niemal każdy zaskakujący kanał wynika z tego jednego zdania.
Łańcuch kończy się na pierwszym trafieniu
Sesja ze źródłem google i medium cpc spełnia dwa warunki. Reguła 4 pyta, czy źródło jest wyszukiwarką, a medium płatne – zgadza się. Reguła 12 pyta, czy źródło jest wyszukiwarką albo medium to organic – pierwsza połowa również się zgadza.
Oba są prawdziwe, a osiągana jest wyłącznie czwarta, bo łańcuch tam się kończy. To cały mechanizm i warto go zapamiętać dokładnie w tej postaci: kanał to nie reguła najlepiej pasująca, lecz pasująca najwcześniej.
Skutek praktyczny widać, gdy reguła stoi wyżej, niż się oczekuje. Cross-network zajmuje pozycję 2, powyżej każdej reguły płatnej, więc nazwa kampanii zawierająca cross-network wyciąga z Paid Search sesje, które inaczej by tam należały – i dokładnie to dzieje się z Performance Max.
Co uchodzi za medium płatne
Pięć z pierwszych ośmiu reguł zadaje medium to samo pytanie, a wzorzec za nim jest szerszy, niż wygląda: wszystko, co zawiera litery cp, a do tego ppc, retargeting i wszystko zaczynające się od paid.
| Medium | Płatne? | Dlaczego |
|---|---|---|
cpc, cpm, cpv |
tak | Wszystkie zawierają cp. |
paid_social, paidsearch |
tak | Zaczynają się od paid. |
ppc, retargeting |
tak | Stoją we wzorcu dosłownie. |
display, banner |
nie | Żadne nie zawiera cp – łapie je później reguła Display. |
ad, ads, sponsored |
nie | Nic w nich nie pasuje, przelatują aż na koniec łańcucha. |
Na ostatnim wierszu rozpada się większość systematyk budowanych na własną rękę. Medium o nazwie ads dla każdego człowieka czyta się jako płatne, a dla żadnej reguły łańcucha nie; sesja ląduje w Unassigned, o ile przypadkiem nie złapie jej reguła późniejsza. Istnieje też przypadek odwrotny – wymyślone medium cpx-newsletter zawiera cp i już tylko dlatego uchodzi za ruch płatny.
Dlaczego rozstrzyga kategoria źródła
Bycie płatnym to w tych regułach tylko połowa warunku. Druga połowa pyta, jakiego rodzaju witryną jest źródło, a na to pytanie odpowiada lista utrzymywana przez Google: które domeny uchodzą za wyszukiwarki, które za serwisy społecznościowe, które za wideo, a które za zakupowe.
Źródło, którego tam nie ma, nie ma kategorii, reguły szczegółowe nie mogą więc zadziałać. Tak z witryny partnerskiej oznaczonej jako cpc powstaje Paid Other zamiast Paid Search: medium jest płatne, ale nic nie czyni z niego wyszukiwania. Kanał się zgadza, opisuje tylko coś węższego, niż oczekiwano.
Ten sam mechanizm tworzy zaskoczenie odwrotne. Wszystko, co figuruje na liście wyszukiwarek, trafia jako Organic Search nawet zupełnie bez medium, bo reguła 12 pyta wyłącznie o źródło. Odesłanie z zapamiętanej kopii wyszukiwarki jest zatem organicznym ruchem z wyszukiwania, niezależnie od tego, czy ktokolwiek czegoś szukał.
Czym naprawdę jest Unassigned
Unassigned nie jest dziewiętnastą regułą, lecz brakiem pierwszych osiemnastu. Powstaje w dwóch przypadkach, a każdy wymaga innej odpowiedzi.
Pierwszy to wartość, dla której łańcuch nie ma reguły – utm_medium=flyer, utm_medium=ads, literówka w rodzaju referal. Dane dotarły nienaruszone, problemem jest systematyka, zmienić trzeba więc link, a nie raport.
Drugi to sesja ze źródłem i zupełnie bez medium, powstająca wtedy, gdy link niesie utm_source i utm_campaign, a poza tym nic. Reguła 1 wymaga źródła direct, każda następna wymaga medium; sesja przelatuje przez wszystkie osiemnaście. To zdecydowanie najczęstsza przyczyna i pochodzi z kreatorów linków traktujących medium jako opcjonalne.
Czytanie kanału od tyłu
Dla każdego podejrzanego kanału warto przejść reguły ręcznie. Najpierw ustal, która zadziałała, a potem sprawdź, która wcześniejsza zadziałałaby przy innej wartości jednego pola. Pozwala to rozstrzygnąć, co zmienić w oznaczaniu i czy kanał w ogóle był błędny. Często jest poprawny, a oczekiwanie opierało się na regule, do której nigdy nie dochodzi.
Czego żadne czytanie nie zmieni, to sama kolejność. Własne grupy kanałów da się utworzyć z inną kolejnością i działają nawet wstecz, ale sama domyślna grupa kanałów się nie zmienia – przez co domyślny łańcuch pozostaje tym, co warto znać, zamiast go obchodzić.
Pytania i odpowiedzi
Dlaczego ruch z Google Ads bez parametrów UTM i tak trafia do Paid Search?
Z powodu auto-taggingu, czyli automatycznego oznaczania każdego kliknięcia w reklamę. Jeśli to ustawienie jest włączone na koncie Google Ads, a konto jest połączone z GA4, każde kliknięcie niesie gclid, z którego GA4 wyprowadza źródło google i medium cpc. Zadziała wtedy reguła 4, chyba że wcześniej zadziałała już reguła Cross-network na pozycji 2, jak w przypadku Performance Max.
Link w newsletterze ma utm_source=newsletter i utm_medium=newsletter. W którym kanale wyląduje?
W Unassigned, choć nic nie wygląda tu na błąd. Łańcuch nie ma reguły dla newsletter ani jako źródła, ani jako medium: słowo nie zawiera cp, nie figuruje na żadnej liście Google, a reguła dla e-maili wymaga jako źródła lub medium jednej z pisowni email, e-mail, e_mail albo e mail. Sesja przelatuje więc przez wszystkie osiemnaście reguł, tak samo jak przy utm_medium=flyer.
Poprawki wymaga link, a nie raport: utm_medium=email, a nazwa newslettera w utm_source albo utm_campaign. Informacja zostaje zachowana, a reguła dla e-maili zaczyna działać.
Przy zmianie nazw warto spojrzeć także na nazwę kampanii. Reguły zakupowe biorą pod uwagę również ją, a nazwa zawierająca shop albo shopping może wciągnąć sesję do kanału zakupowego, choć pochodzi ona z newslettera. Jednorazowe przejście łańcucha od góry dla nowego linku pokaże to przed wysyłką.
Dlaczego reklamy na Facebooku z utm_source=facebook i utm_medium=ads trafiają do Organic Social?
Bo łapie je późniejsza reguła, zanim zdążą przelecieć do Unassigned. Medium ads nie pasuje do wzorca mediów płatnych, więc Paid Social nie zadziała. Reguła Organic Social wymaga natomiast tylko jednego z dwóch warunków: źródła z prowadzonej przez Google listy serwisów społecznościowych albo medium w rodzaju social. Źródło facebook jest na tej liście, więc samo wystarcza.
Wynik jest bardziej zdradliwy niż Unassigned, bo wygląda wiarygodnie: płatny zasięg pojawia się jako organiczny, a kanał organiczny wydaje się skuteczniejszy, niż jest. Pomaga medium pasujące do wzorca, na przykład paid_social albo cpc; wtedy działa Paid Social, które w łańcuchu stoi daleko przed Organic Social.
Kontrola w praktyce: rzeczywiste wiersze pozyskiwania
Audyt pozyskiwania w testerze kanałów uzupełnia przykłady reguł o kontrolę danych raportowych. Po autoryzacji Google wybierasz usługę i jawny zakres dat, na których opiera się zapytanie. Narzędzie pobiera źródło, medium, kampanię i domyślną grupę kanałów na poziomie sesji wraz z liczbą sesji. Nie miesza danych o pozyskiwaniu pierwszego użytkownika z danymi o pozyskiwaniu sesji.
- Wybór zakończonego okresu raportowania. Najnowsze dane mogą się jeszcze zmieniać.
- Kontrola wierszy Unassigned od największych wartości sesji. Porównanie źródła i medium z opisanymi regułami kanałów.
- Sprawdzenie wariantów takich jak
Emailiemailoraz dodatkowych spacji w kampanii. Kandydat oznacza niespójność nazewnictwa do zbadania, a nie automatyczną poprawkę. - Kontrola metadanych przed interpretacją. Progi, próbkowanie i wiersz
(other)mogą ukrywać szczegóły. - Eksport wskazówek do CSV i poprawienie przyszłych linków kampanii lub konfiguracji tam, gdzie uzasadniają to dane.
Procent Unassigned opiera się na sumie zwróconych wartości sesji, a nie na osobno pobranej sumie usługi. Narzędzie odrzuca niepełną paginację i nie zmienia historycznej atrybucji. Samo (not set) nie rozstrzyga, czy przyczyną braku była zgoda, przekierowanie czy tagowanie.
Źródła techniczne: wymiary i metryki Data API oraz metadane odpowiedzi.
Powiązane artykuły