English
 Deutsch
 Polski
Ładunki Measurement Protocol w GA4: każde pole, każdy limit i dlaczego endpoint odpowiada 204 na uszkodzony JSON

Spis treści
- Co odpowiada endpoint
- Gdzie naprawdę należy ładunek
- Pola identyfikacyjne
- Dwa parametry, od których zależy zgodność raportów
- Zdarzenie i jego nazwa
- Parametry i obowiązujące je limity
- Gdzie oba maksima wchodzą sobie w drogę
- Czas i trzy sposoby na jego pomylenie
- consent i klucze, które tu nie należą
- validation_behavior i dlaczego produkcja nie powinna go ustawiać
- Jak w ogóle znaleźć błąd
- Czym protokół jest dzisiaj
- Pytania i odpowiedzi
- Źródła
Żądanie Measurement Protocol to pojedynczy POST po HTTPS: ciąg zapytania z dwoma danymi dostępowymi i treść JSON ze zdarzeniami. Tą drogą do usługi GA4 trafiają dane, które nie pochodzą z przeglądarki — konwersje offline z CRM, płatność potwierdzona webhookiem, backend aplikacji, nadrobienie trafień połkniętych przez blokadę reklam.
To zarazem jedyna droga dostarczania danych w całej układance, która nigdy nie mówi, czy się powiodła.
Co odpowiada endpoint
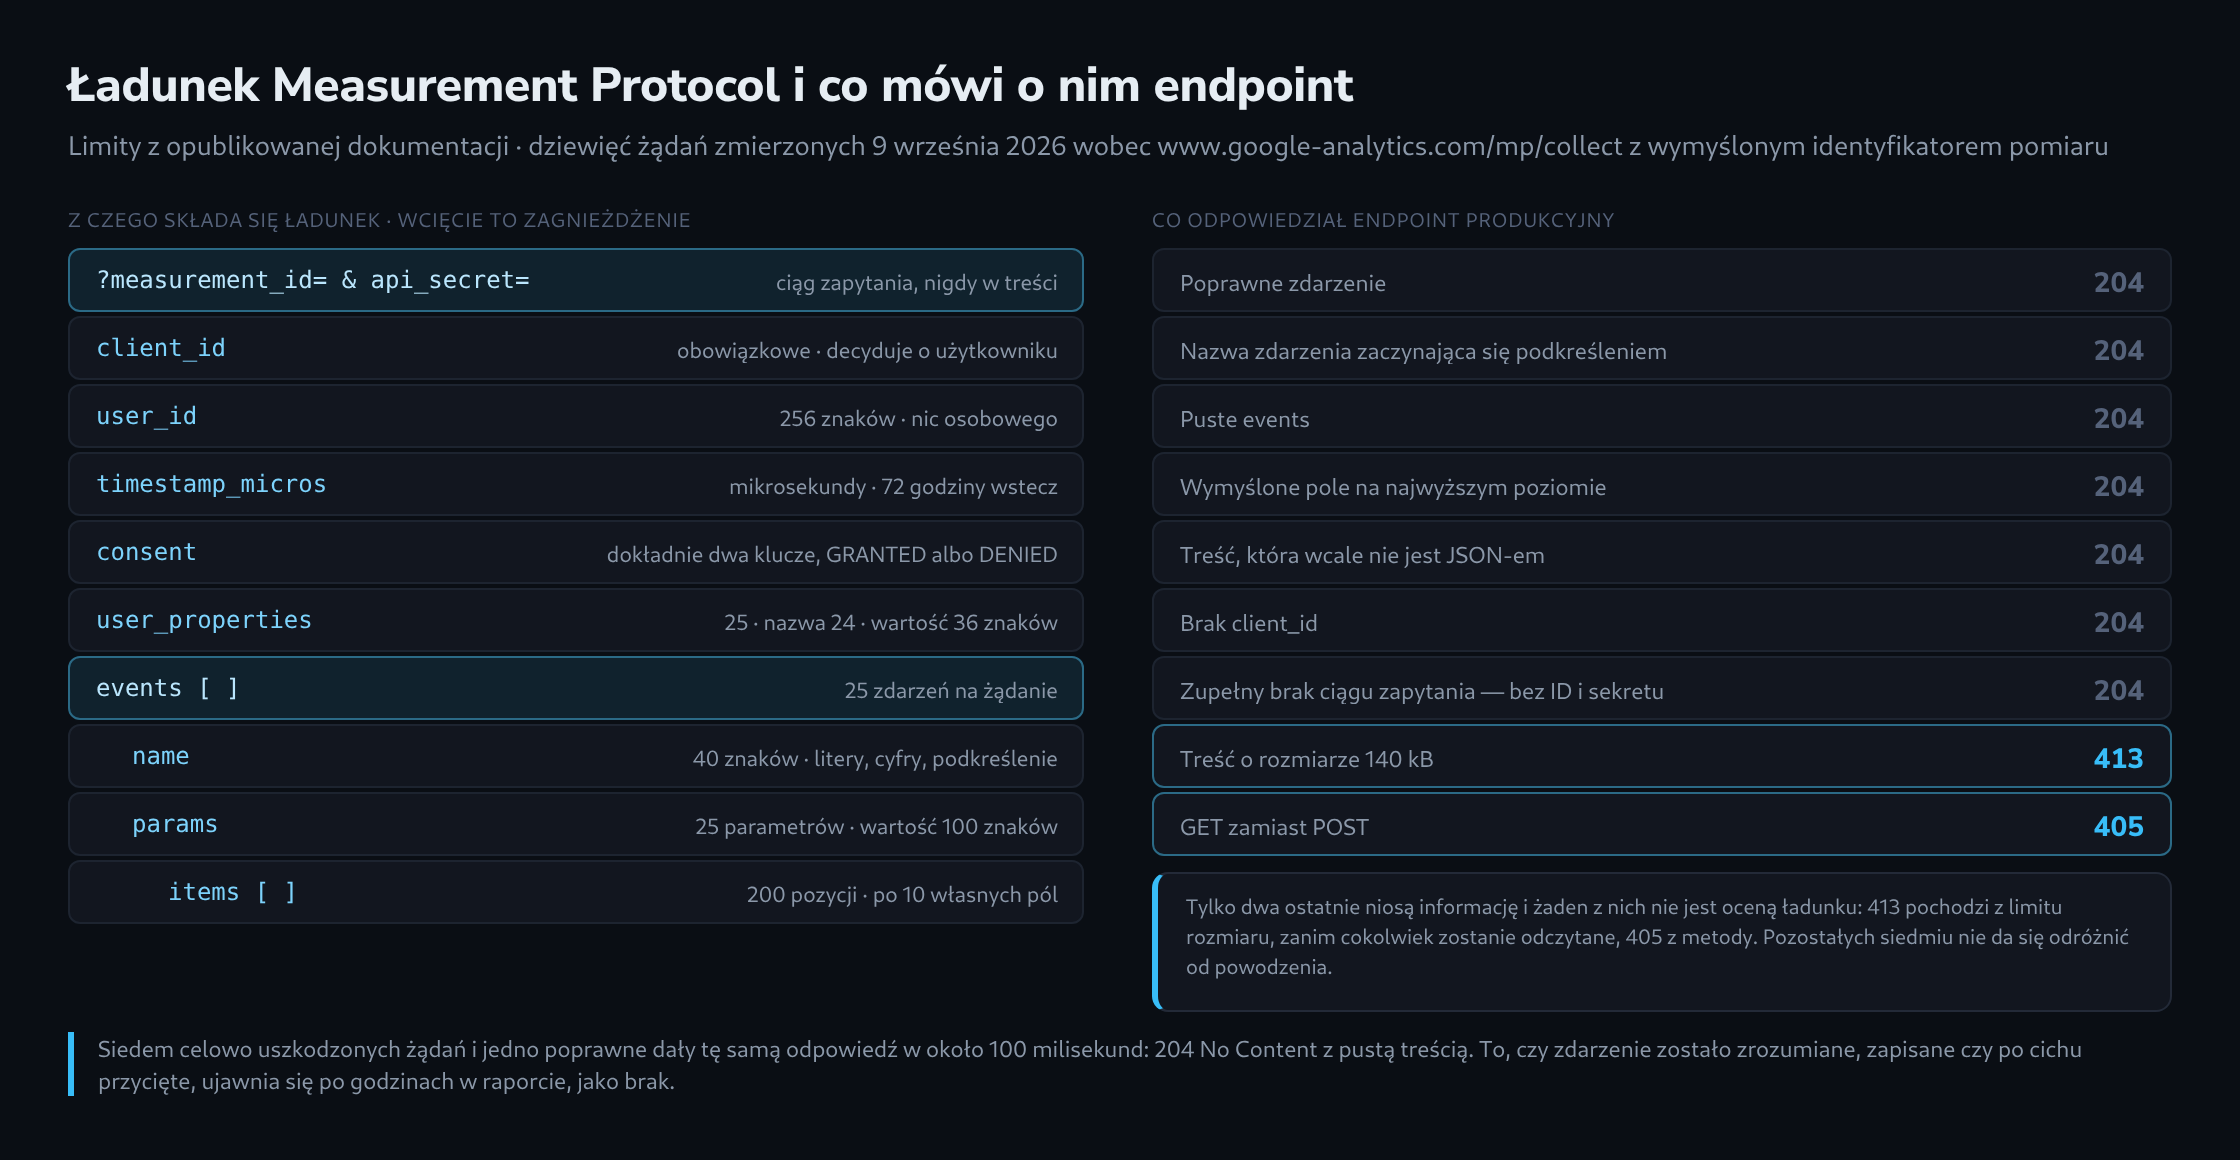
Dziewięć żądań trafiło 9 września 2026 na https://www.google-analytics.com/mp/collect, każde z wymyślonym identyfikatorem pomiaru, aby nigdzie nic nie zostało zapisane. Siedem z nich było celowo uszkodzonych.
Osiem z dziewięciu wróciło jako 204 No Content, w około 100 milisekundach i z pustą treścią. Nie tylko to poprawne: także zdarzenie o nazwie zaczynającej się od podkreślenia, puste events, ładunek z wymyślonym polem na najwyższym poziomie, żądanie bez client_id oraz treść, która wcale nie była JSON-em. Żądanie całkiem bez ciągu zapytania — bez identyfikatora pomiaru, bez sekretu API — również wróciło z kodem 204.
Dokładnie dwie rzeczy wywołały błąd HTTP i żadna z nich nie jest oceną ładunku. Treść o rozmiarze 140 kB została odrzucona kodem 413 i stroną błędu HTML z warstwy wejściowej, ponieważ przekroczyła udokumentowany limit 130 kB, zanim cokolwiek zostało odczytane. Metoda GET została odrzucona kodem 405.
Europejski endpoint region1.google-analytics.com zachowuje się tak samo. Po pięć przebiegów na host: mediana czasu obiegu z tego samego serwera wyniosła w obu przypadkach 90 milisekund.
Kod odpowiedzi potwierdza więc tylko, że żądanie dotarło. Nie mówi, czy zdarzenie zostało zrozumiane i zapisane ani czy pominięto któryś parametr. Przy wysyłce tych problemów nie widać; ujawniają się dopiero kilka godzin później jako brakujące dane w raporcie.
Gdzie naprawdę należy ładunek
Dwie części, a pomylenie ich jest łatwe.
Ciąg zapytania niesie dane dostępowe: measurement_id dla strumienia sieciowego (albo firebase_app_id dla strumienia aplikacji) oraz api_secret, zakładany osobno dla każdego strumienia w administracji GA4. Żadne z nich nie należy do JSON-a. Tam stają się nieznanymi polami, a nieznane pole nie jest pomijane — czyni cały ładunek nieczytelnym.
Treść to obiekt JSON ze stałym zestawem dozwolonych kluczy:
{
  "client_id": "1234567890.1700000000",
  "user_id": "crm-88213",
  "timestamp_micros": 1788000000000000,
  "consent": { "ad_user_data": "GRANTED", "ad_personalization": "DENIED" },
  "user_properties": { "poziom_klienta": { "value": "gold" } },
  "events": [
    {
      "name": "purchase",
      "params": {
        "transaction_id": "T-8891",
        "currency": "EUR",
        "value": 20,
        "session_id": "1700000000",
        "engagement_time_msec": 100,
        "items": [
          { "item_id": "A-1", "item_name": "Koszula", "price": 10, "quantity": 2 }
        ]
      }
    }
  ]
}
Poza tym dokumentacja dopuszcza user_data, user_location, ip_override, device, user_agent, non_personalized_ads i validation_behavior. To jest pełna lista. Wszystko inne — klucz event przeniesiony razem z obiektu dataLayer, otoczka ecommerce, notatka dla koleżanki z zespołu — kosztuje całe żądanie.
Pola identyfikacyjne
client_id jest w strumieniu sieciowym obowiązkowe i to jedno pole decyduje, czy zdarzenie dołączy do istniejącego użytkownika, czy wymyśli nowego. Zalecana postać to dwie dodatnie liczby połączone kropką — dokładnie to, co wydaje gtag('get') i co zwraca wbudowana zmienna Analytics Client ID w Google Tag Managerze. Pełna wartość ciasteczka _ga, czyli GA1.1.1234567890.1700000000, też jest przyjmowana; obie liczby siedzą w środku.
Wartość wymyślona na serwerze również zostanie przyjęta i to jest kosztowna pomyłka. Świeży identyfikator przy każdym żądaniu tworzy za każdym razem nowego użytkownika i nową sesję — usługa wygląda na ruchliwą, a składa się wyłącznie z sesji po jednym zdarzeniu.
Strumienie aplikacji używają zamiast tego app_instance_id: 32 znaki szesnastkowe z SDK Firebase, a nie client_id pod inną nazwą. Wysłanie obu nie szkodzi i nie pomaga; pole należące do drugiego rodzaju strumienia zostaje pominięte.
user_id jest opcjonalne, ma najwyżej 256 znaków i musi być ciągiem znaków. To klucz łączący, nie osoba: adres e-mail albo numer telefonu w tym polu to dana osobowa, czego warunki korzystania z Google Analytics zabraniają i co wystarczy jako powód usunięcia usługi. To samo dotyczy każdego parametru zdarzenia i każdej właściwości użytkownika.
Dwa parametry, od których zależy zgodność raportów
Zdarzenie bez session_id nie należy do żadnej sesji. Nadal zostaje zapisane i policzone, ale sesje, sesje angażujące i wymiary o zakresie sesji się nie zgadzają, a w widoku czasu rzeczywistego zdarzenia może zabraknąć zupełnie.
Zdarzenie bez engagement_time_msec nie wnosi nic do średniego czasu zaangażowania, który dla ruchu dostarczonego tą drogą pokazuje wtedy zero.
Żadne z nich nie jest obowiązkowe, żadne nie wywołuje nigdzie ostrzeżenia i oba są zwykłą odpowiedzią na „zdarzenia docierają, ale raport się nie zgadza”. session_id musi być dodatnią liczbą całkowitą — w typowym przypadku znacznikiem czasu — i może zostać wysłane jako liczba albo jako ciąg cyfr. Litery w środku są odrzucane.
Zdarzenie i jego nazwa
Zdarzenie to obiekt z dokładnie dwoma dozwolonymi kluczami: name i params. Znacznik czasu postawiony obok nich jako trzeci klucz psuje ładunek; znacznik dla pojedynczego zdarzenia należy do params jako timestamp_micros.
Nazwy muszą zaczynać się od litery i mogą zawierać wyłącznie litery, cyfry i podkreślenia. Myślniki, kropki i spacje są odrzucane wprost. Nazwy rozróżniają wielkość liter i to jest przypadek najcichszy: Purchase zostanie przyjęte, zostanie zapisane i jest innym zdarzeniem niż purchase — w raportach e-commerce nie pojawi się nigdy, bo te są podpięte pod nazwę pisaną małymi literami.
Trzydzieści jeden nazw Google zachowuje dla siebie, wśród nich session_start, first_visit, user_engagement, app_remove i error. Trzy kolejne — screen_view, ad_impression i in_app_purchase — istnieją, ale są dozwolone tylko w strumieniach aplikacji. W strumieniu sieciowym po prostu nie zostaną zebrane i nikt nigdzie o tym nie wspomina.
Parametry i obowiązujące je limity
Wszystkie limity protokołu w jednym miejscu:
| Co | Limit |
|---|---|
| Treść JSON | poniżej 130 kB |
| Zdarzenia na żądanie | 25 |
| Nazwa zdarzenia | 40 znaków |
| Parametry na zdarzenie | 25 |
| Nazwa parametru | 40 znaków |
| Wartość parametru | 100 znaków, 500 w usłudze Analytics 360 |
| Właściwości użytkownika na żądanie | 25 |
| Nazwa właściwości użytkownika | 24 znaki |
| Wartość właściwości użytkownika | 36 znaków |
user_id |
256 znaków |
| Pozycje na zdarzenie | 200 |
| Własne parametry na pozycję | 10 |
| Datowanie wstecz | 72 godziny |
Nazwy parametrów nie mogą zaczynać się od _, firebase_, ga_, google_ ani gtag., a firebase_conversion jest zastrzeżone wprost. Nazwy właściwości użytkownika podlegają tym samym regułom przedrostków plus pięciu nazwom zastrzeżonym, spośród których po user_id sięga się przez pomyłkę najczęściej — identyfikator użytkownika należy na najwyższy poziom, a nie do user_properties.
Tablicą może być wyłącznie items. Każdy inny parametr przyjmuje pojedynczą wartość; obiekt zagnieżdżony odpada, a w raporcie parametr pojawia się jako brakujący, nie jako błędny.
Gdzie oba maksima wchodzą sobie w drogę
Dwadzieścia pięć zdarzeń na żądanie i dwieście pozycji na zdarzenie są udokumentowane oba, a razem się nie mieszczą. Zmierzone na wygenerowanych ładunkach z realistycznymi polami pozycji — identyfikator, nazwa, marka, kategoria, wariant, cena, ilość:
purchasez jedną pozycją, wraz z consent i właściwościami użytkownika, ma 558 bajtów.- Dwadzieścia pięć takich zdarzeń daje około 14 kB, czyli 10,7 % limitu.
- Dwadzieścia pięć zdarzeń po 29 pozycji przekracza 130 kB. Przy 28 pozycjach jest to wciąż 126 kB.
- Dwadzieścia pięć zdarzeń po dozwolone 200 pozycji dałoby 879 kB — 6,8 raza więcej niż limit.
Pojedyncze zdarzenie z 200 pozycjami ma 35 kB i mieści się swobodnie. Przy zwyczajnym ruchu wiąże więc liczba zdarzeń, a gdy koszyki się wydłużają, przejmuje limit rozmiaru. Przejście leży przy około 29 pozycjach na zdarzenie i jest to jedyny limit, który odpowiada błędem HTTP zamiast milczeniem.
Czas i trzy sposoby na jego pomylenie
timestamp_micros to uniksowy znacznik czasu w mikrosekundach. Przy jego braku zdarzenie zostaje ostemplowane w chwili dotarcia, co jest słuszne dla wszystkiego bieżącego i błędne dla wszystkiego nadrabianego.
Pułapką jest jednostka. time() w PHP i time.time() w Pythonie zwracają sekundy, Date.now() w JavaScripcie zwraca milisekundy. Oba zostaną przyjęte jako liczba i oba umieszczą zdarzenie gdzieś w roku 1970. Serwer walidacyjny Google owszem to zgłasza — jako „timestamp too far in the past”, czyli komunikat kierujący poszukiwania ku problemowi z datowaniem wstecz, podczas gdy faktycznym błędem jest mnożnik tysiąc albo milion.
Okno wynosi 72 godziny. Starsze zdarzenia są odrzucane, a te wysłane z validation_behavior ustawionym na ENFORCE_RECOMMENDATIONS zostają odrzucone wprost, zamiast po cichu przepaść. Znacznik w przyszłości oznacza zwykle rozstrojony zegar albo dwukrotnie doliczoną strefę czasową.
consent i klucze, które tu nie należą
Obiekt consent przyjmuje dokładnie dwa klucze, ad_user_data i ad_personalization, każdy o wartości GRANTED albo DENIED. Nie analytics_storage, nie ad_storage — to Consent Mode w przeglądarce, inny mechanizm o innym słownictwie.
Wstawienie któregoś z nich tutaj nie jest awarią częściową. Nieznany klucz w consent albo wartość inna niż dwie dozwolone czyni ładunek nieczytelnym, a całe żądanie bezcelowym. Pominięty zupełnie, obiekt ten każe GA4 sięgnąć po stan zgody z interakcji przeglądarkowych tego samego klienta, co dla integracji serwerowej jest zwykle dokładnie tym, o co chodzi.
non_personalized_ads nadal działa i jest wycofywane; zastępuje je ad_personalization wewnątrz consent.
validation_behavior i dlaczego produkcja nie powinna go ustawiać
validation_behavior ma dwie wartości. RELAXED jest domyślne: żądania zniekształcone są odrzucane, ale parametry ponad limitami zostają pominięte zamiast zgłoszone, a dane niewłaściwego typu mogą i tak przejść. ENFORCE_RECOMMENDATIONS odrzuca właśnie to.
Rygorystyczna walidacja sprawdza się w testach, gdzie odrzucenie pomaga znaleźć błąd. W działającym systemie lepiej całkowicie pominąć to pole, ponieważ odrzucenie oznacza utratę danych. Przy łagodnej walidacji zdarzenie ze zbyt długim parametrem dociera bez tego parametru. Przy rygorystycznej nie dociera wcale.
Jak w ogóle znaleźć błąd
Skoro endpoint produkcyjny nic nie mówi, błędy trzeba znaleźć przed wysyłką. Serwer walidacyjny Google przyjmuje to samo żądanie pod adresem /debug/mp/collect i odpowiada tablicą validationMessages; wysłane tam zdarzenia nigdy nie zostają zapisane.
Zanim oprzesz kontrolę na serwerze walidacyjnym, poznaj jego dwa ograniczenia. Zgłasza tylko pierwszy znaleziony błąd: jeśli zdarzenie ma trzy problemy, najpierw zwróci jeden komunikat, a następny pojawi się dopiero po naprawieniu pierwszego błędu. Nie sprawdza też ani measurement_id, ani api_secret. Żądanie ze zmyślonymi danymi dostępowymi otrzyma więc dokładnie taką samą ocenę jak żądanie z prawdziwymi. Jest to udokumentowane i pozwala sprawdzić ładunek bez wysyłania prawdziwego sekretu poza firmę.
Warto też poznać to, czego nie sprawdza wcale. W pomiarze przeciwko niemu, z ustawionym ENFORCE_RECOMMENDATIONS, bez słowa przeszło wszystko poniższe: trzydzieści zdarzeń w jednym żądaniu, puste events, ładunek zupełnie bez klucza events, dwa zdarzenia o tej samej nazwie, screen_view w strumieniu sieciowym oraz purchase bez value i bez currency. Bez validation_behavior — czyli tak, jak ten sam tekst traktuje produkcja — czysto wróciła również wartość parametru o długości 120 znaków.
Czym protokół jest dzisiaj
Google wprowadził Measurement Protocol w czerwcu 2026 w stan zamknięty: bez wycofania, bez nowych funkcji. Dokumentacja poleca dziś dla nowych integracji serwer–serwer interfejs Data Manager API, z OAuth zamiast sekretu API, wieloma miejscami docelowymi na żądanie i szyfrowanymi identyfikatorami.
Dla istniejącej integracji nie jest to stan wyjątkowy. Measurement Protocol działa dalej, jego limity obowiązują dalej, a jego endpoint dalej odpowiada 204 na wszystko — co czyni kontrolę przed wysyłką tym samym zadaniem, którym była zawsze.
Pytania i odpowiedzi
Jak w działającym systemie stwierdzić, czy zdarzenia Measurement Protocol naprawdę docierają?
Nie po kodzie odpowiedzi, bo ten prawie zawsze wynosi 204. Skuteczne jest połączenie kontroli przed wysyłką i uzgadniania po niej:
- Każdy nowy lub zmieniony ładunek trafia najpierw na
/debug/mp/collect. Ponieważ serwer walidacyjny zgłasza tylko pierwszy błąd, przebieg należy powtarzać, dopóki nie przestaną wracać komunikaty. - To, czego serwer walidacyjny nie sprawdza, sprawdza własny kod: najwyżej 25 zdarzeń na żądanie, niepuste events, zalecane nazwy zdarzeń, takie jak purchase, pisane małymi literami, brak zdarzeń przeznaczonych tylko dla aplikacji w strumieniu sieciowym, value i currency przy purchase.
- Nadawca zapisuje, co wysłał, na przykład dzienną liczbę zdarzeń purchase i ich transaction_id. Gdy kilka godzin później raport jest gotowy, porównanie pokazuje, czy zdarzeń brakuje.
Tylko trzeci krok wykrywa także straty w bieżącym działaniu, na przykład po wymianie sekretu API albo przy znaczniku czasu w złej jednostce.
Co się dzieje, gdy sekret API zostanie usunięty albo wymieniony w administracji GA4?
Przy wysyłce nic widocznego: w pomiarze endpoint odpowiedział kodem 204 nawet na żądanie całkiem bez danych dostępowych, a serwer walidacyjny nie sprawdza measurement_id ani api_secret. Nadawca z nieaktualnym sekretem traci więc zdarzenia niepostrzeżenie. Przy wymianie należy najpierw przestawić wszystkich nadawców, a dopiero potem usunąć stary sekret.
Jak zdarzenia wysyłane z serwera mają się do zgody zebranej w przeglądarce przez Consent Mode?
Wyłącznie przez własny kod. Obiekt consent w Measurement Protocol zna tylko ad_user_data i ad_personalization; klucza dla analytics_storage nie ma, a wysłanie go mimo to czyni ładunek nieczytelnym. Odmowy zgody na analitykę nie da się więc przekazać endpointowi przez obiekt consent. Decyzja, czy dla tego klienta w ogóle wysłać zdarzenie, musi zapaść wcześniej, we własnym systemie.
Dochodzi do tego identyfikator. Przy odrzuconym analytics_storage tag Google w przeglądarce nie ustawia ciasteczka _ga, więc serwer odczytujący z niego client_id niczego nie znajdzie. Zastępczy identyfikator wymyślony na serwerze byłby dokładnie tą kosztowną pomyłką: nowym użytkownikiem z sesją złożoną z jednego zdarzenia.
Czy znacznik czasu w milisekundach trafia do roku 1970, czy w ogóle nie dociera do raportów?
Nie dociera, bo nie mieści się w oknie 72 godzin. Dla chwili z przykładowego ładunku Date.now() zwraca wartość 1 788 000 000 000. Odczytana jako mikrosekundy daje 1 788 000 sekund, około 20,7 dnia od początku czasu uniksowego, czyli 21 stycznia 1970. Wartość w sekundach ląduje niecałe pół godziny po północy 1 stycznia 1970. Oba znaczniki są starsze niż 72 godziny i zostają odrzucone, a endpoint produkcyjny nadal odpowiada kodem 204.
Powiązane artykuły