English
 Deutsch
 Polski
Częstotliwość pobierania robots.txt: co potwierdzają historyczne logi

Spis treści
Zmiana robots.txt publikuje instrukcję, lecz nie zastępuje kontroli dostępu. Żądanie w logu potwierdza kontakt z serwerem, a nie samo w sobie odebranie, zrozumienie i zastosowanie nowych reguł. Zachowana analiza jest przydatna, ale jej metoda ogranicza wnioski.
Zachowane dowody
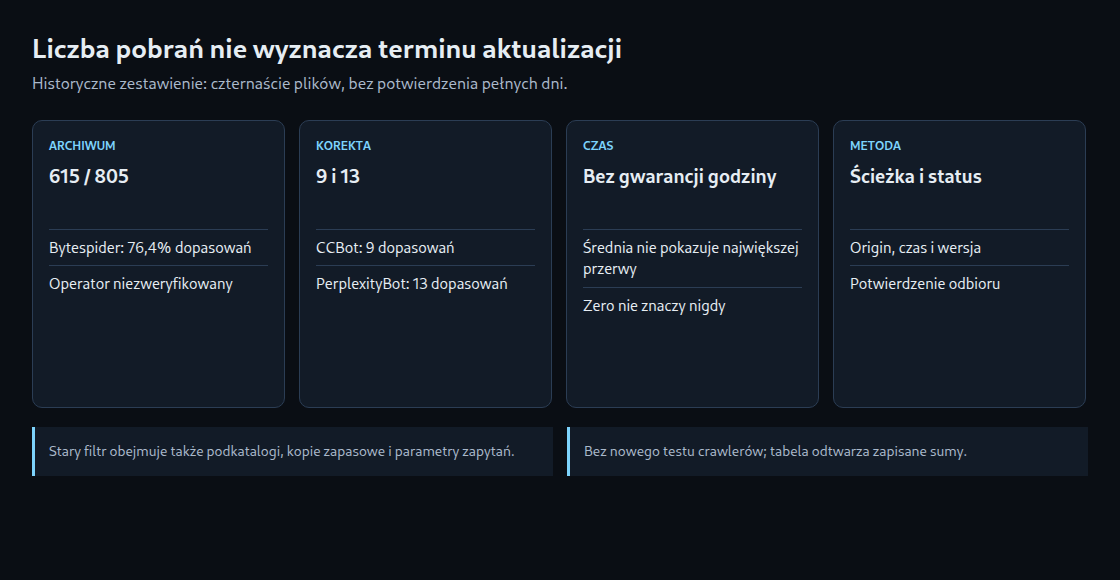
Pierwotny artykuł wskazuje okres od 22 sierpnia do 4 września 2026. Wynik zawiera czternaście grup plików, a skrypt wybiera bieżący log Apache i trzynaście plików po rotacji. Nie filtruje czasu. Czternaście plików nie dowodzi więc czternastu pełnych dni ani niezależnie wskazanego zakresu dat.
Poprawiony historyczny skrypt uwzględnia domenę główną i prefiks www. Grupuje tekst User-Agent bez weryfikacji źródłowego IP. Są to deklarowane oznaczenia, nie potwierdzeni operatorzy. Liczy też każdy wiersz żądania zawierający robots.txt, w tym podkatalog, nazwę kopii zapasowej lub parametr zapytania. Metoda i status odpowiedzi pozostają niesprawdzone.
Co mówią zapisane liczby
Tabela odtwarza zachowane zestawienie. Ostatnia kolumna dzieli wynik przez czternaście, aby umożliwić porównanie z pierwotnym rachunkiem; nie stanowi ponownie potwierdzonej częstości dziennej. Pozostałe żądania nie muszą dotyczyć stron: mogą obejmować pliki, błędy i przekierowania.
CCBot ma dziewięć dopasowań, a nie liczbę wynikającą z trzech dziennie. PerplexityBot ma trzynaście: około 0,9 zamiast 1,9 na umowny dzień. Dla Bytespider 615 z 805 oznacza 76,4%, a dla OAI-SearchBot 152 z 477 daje 31,9%. To udziały żądań, nie dowód skutecznego pobrania reguł.
| Deklarowana nazwa | Żądania | Dopasowania robots.txt | Wynik / 14 |
|---|---|---|---|
| Bytespider | 805 | 615 | 43,9 |
| ClaudeBot | 10 227 745 | 601 | 42,9 |
| OAI-SearchBot | 477 | 152 | 10,9 |
| Applebot | 958 | 147 | 10,5 |
| Googlebot | 875 | 124 | 8,9 |
| bingbot | 4 357 | 69 | 4,9 |
| PerplexityBot | 607 | 13 | 0,9 |
| CCBot | 167 | 9 | 0,6 |
| Amazonbot | 10 700 | 9 | 0,6 |
| ChatGPT-User | 1 047 | 1 | 0,1 |
| meta-externalagent | 1 851 | 0 | 0,0 |
| GPTBot | 1 464 | 0 | 0,0 |
Średnia nie wyznacza terminu
Nawet gdyby 615 żądań obejmowało dokładnie czternaście dni, dzielenie czasu przez liczbę nie pokazałoby najdłuższej przerwy, kolejnego pobrania ani chwili zastosowania reguły. Wiele procesów, różne kombinacje protokołu, hosta i portu, skupiska ruchu i ponowienia mogą dać tę samą średnią.
Zero oznacza jedynie brak dopasowania w tym zestawieniu. Wspólna pamięć podręczna, inne oznaczenia, brakujące logi i błędna klasyfikacja pozostają możliwe. Jednocześnie czternastodniowa kopia nie jest automatycznie uzasadniona: RFC 9309 zaleca odświeżenie w ciągu 24 godzin, z wyjątkiem nieosiągalnego robots.txt. W sprawdzonym pakiecie brak zapisu przed i po zmianie ze znacznikami czasu, który potwierdzałby wcześniejsze twierdzenie o skutku po siedmiu minutach.
Rodzaj usługi i błędy
ChatGPT-User jest udokumentowany jako agent działań inicjowanych przez użytkowników, a nie automatyczny crawler. Reguły robots.txt mogą nie dotyczyć takich żądań. Ranking zakładający identyczny obowiązek regularnego odświeżania byłby mylący. Google opisuje również współdzielenie kopii robots.txt między crawlerami.
RFC 9309 dopuszcza dostęp przy niedostępnym robots.txt, na przykład po 4xx, a przy błędach serwera lub sieci wymaga początkowego założenia blokady, z wyjątkiem długiej awarii. Google uznaje zwykłe 4xx za brak ograniczeń, ale traktuje 429 inaczej. Przy błędzie serwera najpierw wstrzymuje pobieranie na dwanaście godzin, a następnie może używać ostatniej poprawnej kopii. Bez kopii pobieranie może być nieograniczone. Kod 503 nie jest więc niezawodną stałą blokadą.
403 na robots.txt nie znosi logowania ani zapory chroniącej pozostałe adresy. 304 może prawidłowo potwierdzić ważność zapisanej kopii. Jasna odpowiedź 200 z aktualnym tekstem jest użyteczna, lecz wymaganie zawsze wyłącznie 200 byłoby błędne.
Dokładniejszy pomiar
Kolejna analiza wymaga jawnego przedziału i strefy czasowej, kombinacji protokołu, hosta i portu, dokładnej ścieżki, metody, statusu i wersji reguł. Tożsamość operatora wymaga osobnej kontroli. Potrzebne są także logi CDN i znaczniki czasu do wyznaczenia przerw. Skrót treści lub numer wersji łączy skuteczne pobranie ze zmienionymi regułami.
Google Search Console umożliwia prośbę o ponowne pobranie robots.txt przy ważnej zmianie. Nie gwarantuje to natychmiastowego pobrania odblokowanych stron. Dla innych operatorów potrzebna jest aktualna dokumentacja. Pilna ochrona wymaga kontroli dostępu lub odpowiednich limitów żądań o określonym zakresie. robots.txt sam nie usuwa adresów z indeksu; czytelne noindex, usunięcie treści i ograniczony dostęp realizują różne cele.
Źródła
Powiązane artykuły