

 English
 Deutsch
Crawler-Adressen prüfen: Rückwärtsauflösung, veröffentlichte Bereiche und wo beide enden

Management Summary
Crawler sind automatische Programme, die Websites etwa für Suchmaschinen oder KI-Dienste besuchen. Der angegebene Name lässt sich nachahmen und reicht deshalb nicht für eine verlässliche Zuordnung. Ein Abgleich der Verbindungsadresse mit offiziellen Anbieterangaben hilft, die Herkunft einer Anfrage einzuordnen. Der Beitrag erklärt diese Nachweise und ihre Grenzen: Eine fehlgeschlagene Prüfung beweist keine Täuschung, und ein bestätigter Betreiber bedeutet noch keine uneingeschränkte Zugriffsberechtigung.
Inhalt
Der User-Agent ist eine vom Client gesendete Kennzeichnung des Browsers oder automatisierten Programms. Ein User-Agent wie Googlebot ist zunächst eine Behauptung des Clients. Auch der angeforderte Pfad stammt aus der Anfrage. Verlässlicher ist die vom Server ermittelte Verbindungsadresse – sofern ein vorgeschalteter Proxy korrekt berücksichtigt wurde. Erst danach lässt sich prüfen, ob die Adresse zur dokumentierten Infrastruktur des genannten Dienstes passt.
Zwei übliche Nachweise sind ein dokumentiertes DNS-Namensmuster mit Vorwärtsbestätigung und der Abgleich mit offiziellen IP-Bereichen. Ein Registereintrag wie „Google LLC“ oder „Microsoft Corporation“ ergänzt die Einordnung, bestätigt aber keinen bestimmten Crawler.
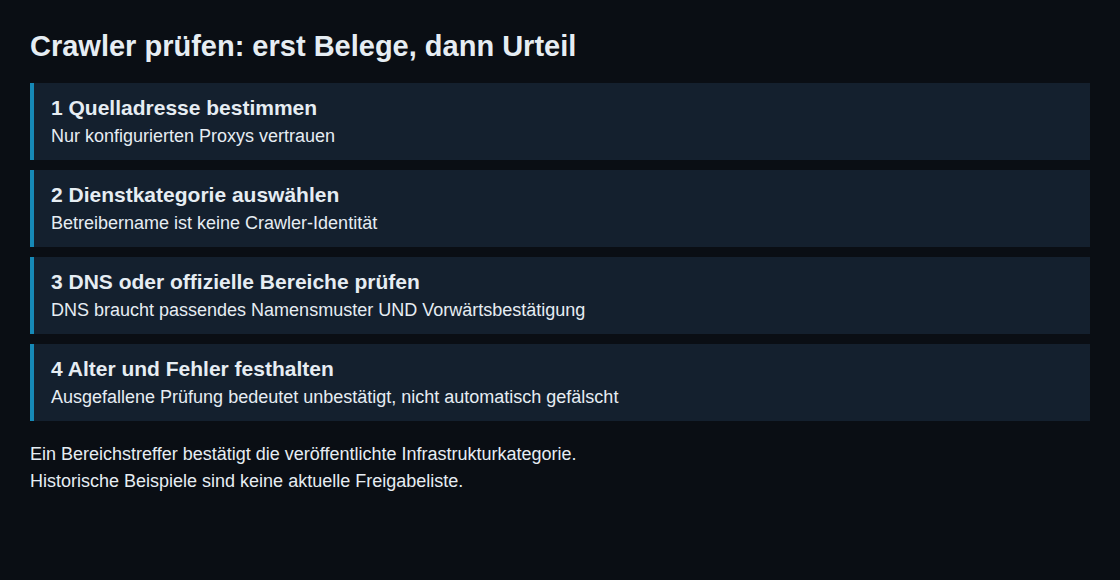
DNS-Prüfung: Name, Grenze und Gegenprobe
Die Rückwärtsauflösung liefert zu einer IP-Adresse einen PTR-Namen. Ein solcher Name allein genügt nicht: Die Verwaltung des Adressbereichs kann einen PTR setzen, ohne die darin genannte Domain zu kontrollieren. Zur Prüfung gehören deshalb drei Schritte:
- PTR zur tatsächlichen Quelladresse abfragen.
- Den Namen mit dem aktuell dokumentierten Muster der passenden Crawler-Kategorie vergleichen. Bei Google sind gewöhnliche Crawler, Sondercrawler und nutzerinitiierte Abrufe zu unterscheiden.
- Den akzeptierten Namen vorwärts per A beziehungsweise AAAA auflösen. Die ursprüngliche Adresse muss in der Antwort enthalten sein.
Die Domain-Grenze ist wichtig: crawl.example.googlebot.com liegt unter googlebot.com, googlebot.com.example.org dagegen nicht. Ein beliebiger passender DNS-Rundlauf beweist lediglich die Verbindung zwischen Adresse und Name, nicht die Zugehörigkeit zu Googlebot. Auch google.com allein reicht für diese konkrete Zuordnung nicht aus.
Dieses Verfahren benötigt keine heruntergeladene Bereichsliste. Pflegefrei ist die Prüfung trotzdem nicht: Namensmuster können sich ändern, DNS-Antworten altern, und Auflösungsfehler müssen von negativen Antworten getrennt bleiben.
Bereichslisten: die richtige Kategorie zählt
Offizielle JSON-Dateien enthalten IPv4- und teilweise IPv6-Präfixe im CIDR-Format, beispielsweise 66.249.66.0/27. Die Prüfung testet, ob eine Adresse innerhalb eines solchen Netzes liegt. Ein einfacher Textvergleich genügt nicht.
Google verlinkt inzwischen common-crawlers.json für gewöhnliche Crawler, eine eigene Liste für Sondercrawler sowie mehrere Listen für nutzerinitiierte Abrufe und Agenten. Ein Treffer bestätigt zunächst die veröffentlichte Infrastrukturkategorie. Eine gemeinsam genutzte Liste unterscheidet nicht zwangsläufig jeden einzelnen User-Agent.
OpenAI veröffentlicht getrennte Listen für GPTBot, OAI-SearchBot und ChatGPT-User. Die Aufgaben unterscheiden sich: Modelltraining, Suche und bestimmte Nutzeraktionen. Ein fehlender PTR ist deshalb nicht automatisch verdächtig; für Dienste ohne dokumentiertes DNS-Prüfverfahren ist die passende offizielle Liste entscheidend.
Was die historische Stichprobe belegt
Der gespeicherte Datensatz vom 5. September 2026 enthält zwölf abgefragte Listen mit zusammen 2560 Präfixeinträgen; 2143 entfielen auf vier damalige Google-Listen. Diese Summen wurden bei der Überarbeitung aus den gespeicherten Zählwerten erneut berechnet. Präfixeinträge sind weder eindeutige IP-Adressen noch zwingend überschneidungsfreie Netze. Aus der Anzahl folgen keine zuverlässigen Aussagen über Verkehrsmenge, Architektur oder Änderungshäufigkeit.
Für 20.171.207.1 und 52.230.152.1 dokumentiert die damalige Ausgabe GPTBot-Bereichstreffer ohne ermittelten PTR. Das gespeicherte Feld unterscheidet jedoch nicht zwischen tatsächlich fehlendem PTR und einem Auflösungsfehler. Der Microsoft-Registereintrag bestätigt außerdem keinen konkreten Cloud-Mietvertrag. Alle Adressbefunde bleiben historische Beobachtungen, keine aktuelle Freigabeliste.
8.8.8.8 verdeutlicht den Unterschied zwischen Organisation und Funktion: Google dokumentiert diese Adresse als öffentlichen DNS-Resolver. Ein passender DNS-Rundlauf und ein Google-Registereintrag machen daraus keinen Googlebot. Die Auswahl „Googlebot“ im damaligen Prüflauf war eine Testbehauptung, kein Nachweis einer echten HTTP-Anfrage von diesem Resolver.
64.233.173.1 stand damals in der Liste nutzerinitiierter Google-Abrufe und hatte einen passenden google-proxy-Namen. Daraus lässt sich weder eine konkrete Besucheraktion noch automatisch Googlebot ableiten. Genau hier war die Werkzeugauswertung zu großzügig.
Identität und Zugriffsregeln getrennt entscheiden
robots.txt steuert kooperative Crawler und bleibt dafür sinnvoll. Die Datei ist keine Zugriffssperre. Ein bestätigter Betreiber bedeutet auch nicht, dass jeder Dienst dieselben robots.txt-Regeln beachtet: Google unterscheidet gewöhnliche Crawler, Sonderfälle und nutzerinitiierte Abrufe. Googlebot unterstützt crawl-delay nicht; das unterscheidet daher keinen Googlebot von einem nutzerinitiierten Abruf.
Ein unbekannter oder widersprüchlicher Nachweis ist nicht gleichbedeutend mit bösartigem Verhalten. Für unerwünschte Zugriffe kommen je nach Zweck Authentifizierung, Ratenbegrenzung oder Regeln am Webserver beziehungsweise an der vorgeschalteten Schutzschicht infrage. Eine IP-Sperre ist eine Möglichkeit, aber kein vollständiges Schutzkonzept. Ein allgemeines gemeinsames Crawl-Budget für alle Betreiber gibt es nicht.
Manuelle Prüfung als nachvollziehbare Gegenprobe
Das Beispiel zeigt eine in Googles Dokumentation verwendete IPv4-Adresse. Der PTR-Name muss aus der tatsächlichen Antwort stammen; erst nach Prüfung der Kategorie und Namensgrenze folgt die Vorwärtsauflösung. Die JSON-Datei herunterzuladen ist noch kein CIDR-Abgleich.
dig +short -x 66.249.66.1
dig +short A crawl-66-249-66-1.googlebot.com
dig +short AAAA crawl-66-249-66-1.googlebot.com
curl --fail --show-error --silent --location --max-time 20 \
  https://developers.google.com/static/crawling/ipranges/common-crawlers.json
Der Crawler-IP-Prüfer sammelt DNS-, Bereichs- und Registerbefunde. Bei der Überarbeitung wurden jedoch zwei Grenzen reproduziert: Ein bestätigter Google-Proxyname konnte zu pauschal als Googlebot gelten; ein fehlgeschlagener Listenabruf konnte trotzdem zum Urteil „gefälscht“ führen. Deshalb zählen die einzelnen Nachweise und deren Aktualität stärker als ein zusammenfassendes Urteil. Der Cache wird bei Bedarf nach ungefähr 24 Stunden neu geladen; das ist keine Garantie einer täglichen erfolgreichen Aktualisierung.
Fragen und Antworten
Welche Adresse gilt hinter mehreren Proxys?
Zuerst muss die direkte Gegenstelle ein ausdrücklich vertrauenswürdiger Proxy sein. Anschließend wird die weitergereichte Adresskette von rechts nach links ausgewertet, solange jeweils der aktuelle Absender die vorherige Adresse glaubwürdig melden darf. Das Ergebnis ist weder pauschal der rechte noch pauschal der linke Eintrag. Ein frei eingesandter X-Forwarded-For-Header darf die Quelladresse nicht ersetzen.
Apache bietet dafür mod_remoteip. Die Vertrauensgrenzen müssen mit RemoteIPTrustedProxy beziehungsweise RemoteIPInternalProxy passend gesetzt werden; RemoteIPHeader allein ist keine sichere Konfiguration. Das Modul kann dann die geprüfte Client-Adresse für Protokollierung und Zugriffskontrolle verwenden.
Muss DNS bei jeder Anfrage geprüft werden?
Bei synchronen DNS-Prüfungen wartet die Anfrage auf die DNS-Antwort. Das verlängert die Antwortzeit und kann bei Ausfällen zu langen Wartezeiten führen. Geeigneter sind ein lokaler Bereichsabgleich, zeitlich begrenzte DNS-Caches und eine nachgelagerte Protokollauswertung. Die Arbeit ist nicht kostenlos; Timeouts, Cache-Alter und Fehlerzustände gehören zur Planung. Apache deaktiviert allgemeine HostnameLookups standardmäßig.
Was ist bei IPv6 erforderlich?
IPv6-Präfixe und die Rückwärtszone ip6.arpa müssen unterstützt werden. Beim Adressvergleich sind gleichwertige Schreibweisen zu normalisieren: 2001:db8::1 und 2001:0db8:0:0:0:0:0:1 bezeichnen dieselbe Adresse. Ein reiner Zeichenkettenvergleich kann fälschlich scheitern.
Was bedeutet ein fehlender Bereichstreffer?
Zunächst nur, dass die verwendete Liste keinen Treffer liefert. Für eine belastbare Bewertung zählen passende Kategorie, erfolgreicher Abruf, Herkunft und Alter der Kopie. Veröffentlichungszeit des Anbieters, lokaler Abrufzeitpunkt und letzter erfolgreicher Abruf sind unterschiedliche Angaben. Bei einem Dienst mit dokumentierter DNS-Prüfung kann diese ergänzend helfen; ein Ausfall bleibt ansonsten „nicht bestätigt“ statt automatisch „gefälscht“.
Passend dazu


