English
 Deutsch
Klassische Skripte und DOM: Elemente zum richtigen Zeitpunkt finden

Management Summary
Skripte sind kleine Programme, die Webseiten um Funktionen wie den Wechsel zwischen hellem und dunklem Design ergänzen. Im Browser wird eine Seite jedoch Schritt für Schritt aufgebaut. Startet ein Programm zu früh, kann es Bilder weiter unten noch nicht berücksichtigen. Dann passen diese Bilder trotz gewähltem Design nicht zur Seite. Der Artikel erklärt diesen Ablauf und zeigt, warum der richtige Startzeitpunkt wichtig ist: Texte, Bilder und Bedienung sollen bereits beim ersten Öffnen zusammenpassen.
Inhalt
Der HTML-Parser liest den Seitenquelltext und baut daraus die Struktur der Seitenelemente auf. Ein von diesem Parser verarbeitetes klassisches Skript ohne async und ohne wirksames defer unterbricht den weiteren HTML-Aufbau während der Ausführung. Später im Quelltext stehende Elemente sind dann normalerweise noch nicht im Dokumentbaum (DOM) vorhanden. Für Module, asynchrone oder dynamisch eingefügte Skripte gelten andere Regeln.
Das erklärt einen typischen Fehler beim Theme-Wechsel: Der Schalter im Seitenkopf funktioniert, aber beim ersten Laden werden die Bilder im später folgenden Artikel nicht gefunden. Die Bilddateien können vollständig vorhanden sein; die Abfrage erfolgt lediglich zu früh.
Quelltextposition ist kein Laufzeitnachweis
Eine Byteposition zeigt die Reihenfolge im ausgelieferten HTML. Eine Zählung öffnender Tags entspricht jedoch nicht automatisch der Zahl vorhandener DOM-Elemente: Kommentare, Skripttexte, implizit erzeugte Elemente und nachträgliche Änderungen können das Ergebnis verändern. Auch früher ausgeführte Skripte können bereits zusätzliche Elemente angelegt haben.
Ein geeigneter Nachweis erfasst deshalb document.readyState und die tatsächlich gefundenen Elemente direkt bei der Ausführung. Die früher genannten Seitenumfänge und Dateizahlen werden hier nicht als reproduzierte Messung fortgeschrieben. Stattdessen zeigt ein kleines isoliertes Browserbeispiel den Mechanismus.
Was der Browsertest zeigt
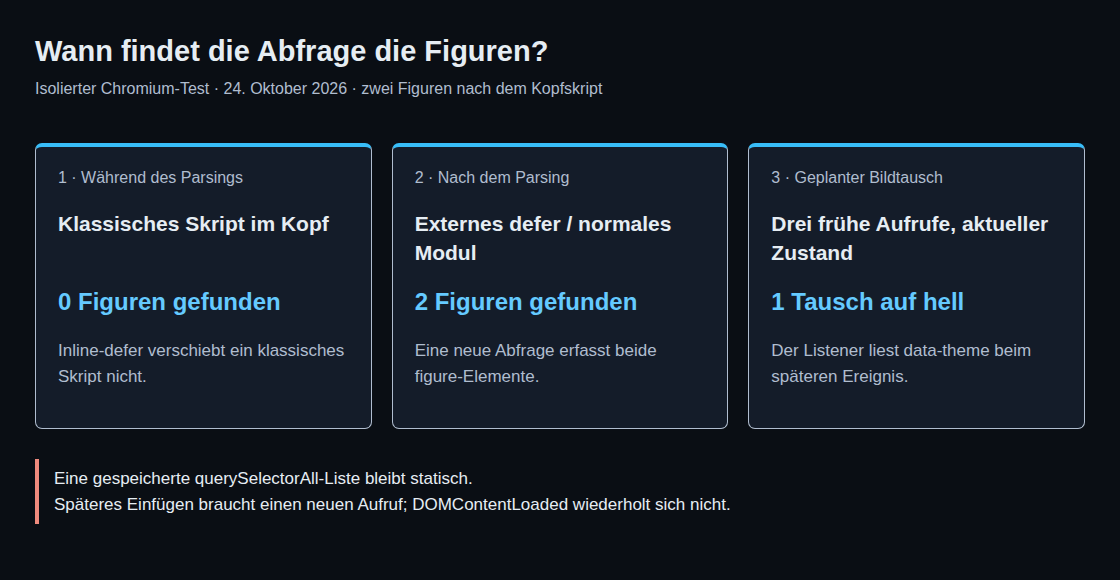
Im Test vom 24. Oktober 2026 stehen zwei figure-Elemente nach einem klassischen Skript im Kopf. Die frühe Abfrage findet null Figuren. Ein externes klassisches Skript mit defer und ein normales Modul finden später beide Figuren. Ein defer-Attribut am eingebetteten klassischen Skript ändert die frühe Ausführung nicht.
querySelectorAll() liefert zudem eine statische Liste. Die früh gespeicherte leere Liste bleibt leer, auch nachdem die beiden Figuren existieren. Nach dem HTML-Aufbau ist deshalb eine neue Abfrage erforderlich. Geprüft wurde ein isoliertes Chromium-Beispiel, keine Browsermatrix und keine historische Netzwerkaufzeichnung der Website.
Warum ein späterer Klick nicht genügt
Ein Klick nach dem Aufbau prüft den Zustandswechsel bei bereits vorhandenen Elementen. Daraus folgt nicht, dass dieselbe Funktion beim ersten Laden funktioniert. Ein Klick kann außerdem schon während des Ladens erfolgen, sobald der Schalter angezeigt wird und eine Funktion für die Klickverarbeitung vorhanden ist.
Eine gespeicherte helle Auswahl, ein Neuladen in dunkler Ansicht und ein Wechsel während des Ladens sind daher getrennte Testfälle. Für das Bildtauschen zählt jeweils der aktuelle Theme-Zustand. Bereits vorhandene Kopfzeilenelemente sagen nichts darüber aus, ob die später folgenden Artikelfiguren schon existieren.
Bildtausch erst nach dem HTML-Aufbau
Das folgende Integrationsbeispiel setzt eine vorhandene Funktion bilderJetztTauschen(hell) voraus. Diese Funktion muss bei jedem Aufruf die aktuellen Bildelemente erneut abfragen und die passenden Adressen setzen. Der Ausschnitt organisiert ausschließlich den Ausführungszeitpunkt.
const wurzel = document.documentElement;
let bildtauschGeplant = false;

function bilderTauschen(hell) {
    if (document.readyState === 'loading') {
        if (bildtauschGeplant) return;
        bildtauschGeplant = true;
        document.addEventListener('DOMContentLoaded', function () {
            bildtauschGeplant = false;
            bilderJetztTauschen(wurzel.getAttribute('data-theme') === 'light');
        }, { once: true });
        return;
    }
    bilderJetztTauschen(hell);
}
Solange readyState den Wert loading hat, wird höchstens ein Listener registriert. Beim späteren Ereignis wird die aktuelle Auswahl aus data-theme gelesen. Nach dem HTML-Aufbau erfolgt der Aufruf sofort mit dem übergebenen Wert. Die Auswahl muss vor dem Aufruf im Wurzelelement aktualisiert werden.
Im isolierten Test führten drei frühe Aufrufe zu genau einem späteren Tausch mit der zuletzt gesetzten hellen Auswahl. Ein anschließender Aufruf mit dunkler Auswahl wirkte unmittelbar. Der Ausschnitt ist eine optimierte Variante; eine Änderung am produktiven Theme ist damit nicht verbunden.
Fragen und Antworten
Wann helfen defer und Module?
Bei externen klassischen Skripten verschiebt defer die Ausführung hinter das HTML-Parsing und erhält die Dokumentreihenfolge. Normale Module werden ebenfalls nach dem Parsing ausgeführt. async bietet diese Zusage nicht; die Ausführung hängt von der Verfügbarkeit des Skripts ab. Bei Modulen kann async auch ohne eigenes src relevant sein. Für eingebettete klassische Skripte bleiben defer und async wirkungslos.
Warum DOMContentLoaded statt load?
DOMContentLoaded folgt auf das HTML-Parsing und die zugehörigen verzögerten Skripte. Das Ereignis wartet nicht auf alle Bilder oder asynchronen Skripte; Stylesheets können indirekt über wartende Skripte verzögern. load wartet zusätzlich auf weitere Seitenressourcen, nimmt aber verzögert geladene Bilder aus. Für benötigte Webfonts ist document.fonts.ready der gezielte Prüfpunkt. Zum Auffinden der Figuren genügt der aufgebaute Dokumentbaum.
Verhindert der Tausch doppelte Bildübertragungen?
Nein. Vorablader oder der Bildlader können die ursprüngliche Adresse schon angefordert haben. Cache, Ladeabstand, Verbindung und Browser bestimmen den tatsächlichen Aufwand; loading="lazy" garantiert keine vermiedene Anfrage. Netzwerkprotokolle sind dafür aussagekräftiger als die Skriptposition.
<picture> mit prefers-color-scheme kann die Systemauswahl berücksichtigen. Eine allein in localStorage gespeicherte Auswahl ist weder für CSS-Medienabfragen lesbar noch automatisch dem Server bekannt. Eine serverseitige Auswahl benötigt einen gesondert übermittelten Zustand.
Was gilt bei später nachgeladenen Artikeln?
DOMContentLoaded wird für dasselbe Dokument nicht erneut ausgelöst. Nach einem Inhaltswechsel ohne vollständige Navigation ist ein eigener Aufruf nach dem Einfügen erforderlich. Im Test erzeugte eine später eingefügte dritte Figur keinen automatischen weiteren Tausch.
Passend dazu