English
 Deutsch
 Polski
Wenn KI Inhalte liest: Pay per Crawl, Datenlizenz oder bezahlte API?

Management Summary
Inhalte lassen sich gegenüber KI-Diensten auf drei Arten anbieten: gegen Bezahlung pro Abruf, über vereinbarte Nutzungsrechte oder als regelmäßig aufbereitete Datenlieferung. Bezahlt wird jeweils eine andere Leistung. Technischer Zugang allein erlaubt keine beliebige Weiterverwendung und erzeugt noch keine Einnahmen. Ein kleiner Versuch mit konkreten Käufern klärt Nachfrage, verfügbare Rechte, Betriebskosten und Auswirkungen auf Suchbesuche. Entscheidend ist der tatsächlich verbleibende Erlös.
Inhalt
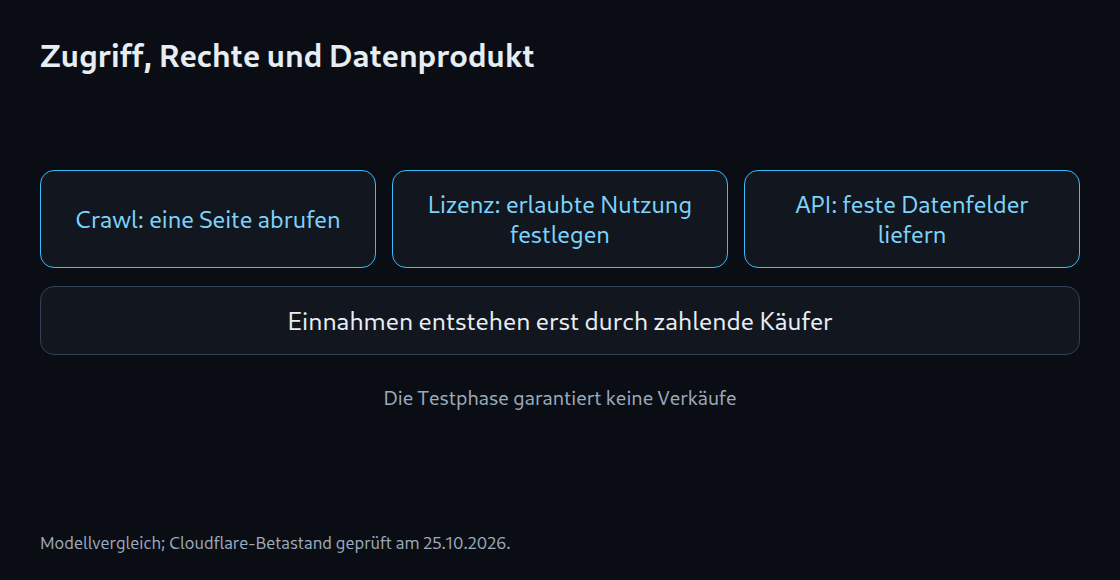
Ein KI-Crawler ist ein Programm, das Webseiten automatisch abruft, etwa um Inhalte für eine KI-Anwendung zu sammeln. Solche Abrufe erzeugen nicht zwangsläufig menschliche Besuche oder Werbeumsatz. Für Inhalte kommen unterschiedliche Angebote infrage: Bezahlung pro Abruf, eine Lizenz zur vereinbarten Nutzung oder eine bezahlte Datenschnittstelle. Die Modelle können kombiniert werden; bezahlt wird jeweils für einen anderen Teil der Leistung.
Drei Ebenen auseinanderhalten
| Modell | Verkaufte Leistung | Voraussetzung |
|---|---|---|
| Pay per Crawl | Bezahlter technischer Zugriff | Teilnehmender, zahlungsbereiter Crawler |
| Datenlizenz | Vereinbarter Nutzungsumfang | Passende Rechte und ein konkreter Käufer |
| Bezahlte API | Strukturierte, verlässliche Datenlieferung | Datenqualität, Betrieb und Integration |
Was Cloudflare beschreibt
Cloudflares beschriebenes Pay-per-Crawl-Verfahren verlangt teilnehmende, registrierte Crawler. Bei einem kostenpflichtigen Abruf kann zunächst die Antwort HTTP 402 Payment Required mit einer Preisangabe zurückkommen: Der Inhalt ist zu diesem Preis erhältlich. Der Crawler kann den Preis akzeptieren oder abbrechen. Eine bestätigte kostenpflichtige Auslieferung wird für die Abrechnung erfasst; Cloudflare sammelt die Ereignisse und rechnet später ab. Eine 402-Antwort allein löst keine Zahlung aus. [1]
Die öffentliche Anmeldeseite bezeichnet Pay per Crawl am 25. Oktober 2026 weiterhin als private Beta, also als Testphase mit begrenztem Zugang. AI Crawl Control zeigt und steuert Crawler-Zugriffe; Pay per Crawl ergänzt kostenpflichtigen Zugriff. Eine Bewerbung um Zugang bedeutet noch keine Freischaltung. Selbst nach Freischaltung entstehen nur Einnahmen, wenn teilnehmende Betreiber tatsächlich zahlen. [2]
Technischer Zugriff ist kein vollständiges Nutzungsrecht
Ein erfolgreicher Abruf bedeutet zunächst nur, dass Daten übertragen wurden. Welche weitere Verwendung erlaubt ist, muss aus den passenden Bedingungen hervorgehen. Eine Lizenz kann beispielsweise die Nutzung für eine interne Suche erlauben und die Weitergabe an Dritte ausschließen. Auch Laufzeit, Speicherung und Verarbeitung lassen sich festlegen. Die Preisangabe in einer Serverantwort ersetzt keine vollständige Beschreibung dieser Rechte.
Ein Artikel kann neben eigenem Text ein fremdes Foto enthalten. Die Erlaubnis, das Foto im Blog zu zeigen, muss dessen Weitergabe als Teil eines Datenpakets nicht abdecken. Deshalb braucht ein Angebot eine Liste der enthaltenen Materialien und der dazugehörigen Rechte. Nur tatsächlich verfügbare Nutzungsrechte können zugesagt werden.
Wann eine API mehr Wert bietet
Eine API ist eine Schnittstelle, über die Programme Daten gezielt abfragen. Ein Beispiel wäre ein Produktkatalog mit festen Feldern für Artikelnummer, Preis, Währung und Änderungsdatum. Ein anderes Programm kann diese Angaben direkt übernehmen, statt Werte aus einer Webseite herauszusuchen. Zusätzlichen Nutzen schaffen geprüfte Quellen, aktuelle Einträge und angekündigte Formatänderungen.
Der Betrieb einer solchen Schnittstelle verursacht laufende Arbeit. Zugangsschlüssel müssen geprüft, die Zahl der Anfragen begrenzt und Ausfälle behoben werden. Datenfehler und Kundenfragen benötigen ebenfalls Zeit. Für beendete Verträge muss klar sein, ob Daten exportiert oder gelöscht werden und welche Kopien weiter genutzt werden dürfen. Eine technisch fertige API beweist noch nicht, dass dafür ein zahlender Kunde existiert.
Ein vorsichtiger Geschäftsversuch
Ein erster Versuch beginnt mit einem kleinen Beispieldatensatz und einer klaren Zielgruppe. Gespräche klären, welche Felder gebraucht werden, wie häufig Änderungen nötig sind und wofür bezahlt würde. Bei einem bezahlten Abrufversuch zählen bestätigte Abrechnungsereignisse, tatsächlich eingegangene Zahlungen und Betriebskosten getrennt. Auch Veränderungen von Suchzugriffen oder anderen Besuchen gehören zur Auswertung. Für diesen Vergleich liegen keine Einnahmen aus einem eigenen bezahlten Crawl-Versuch vor.
Die Datei robots.txt enthält Regeln für Crawler, die diese Regeln beachten. Eine Sperre verhindert keine Zugriffe durch Programme, die die Datei ignorieren, und ersetzt keinen Passwortschutz. Eine gesperrte Seitenadresse kann außerdem weiterhin in Google erscheinen, wenn andere Seiten darauf verweisen. Regeln für Suchmaschinen und KI-Dienste müssen deshalb zum jeweiligen Ziel passen; eine pauschale Sperre kann auch erwünschte Zugriffe treffen. [3]
Eine sinnvolle Entscheidung beginnt mit einer konkreten Frage: Welche Daten benötigt ein Käufer, und welche Leistung spart dabei Arbeit? Ein Abrufpreis bezahlt Zugang. Eine Lizenz beschreibt erlaubte Nutzung. Eine API kann zusätzlich regelmäßig aufbereitete Daten liefern. Nachfrage und verbleibender Erlös müssen für das jeweilige Angebot geprüft werden; die vorhandene Technik allein beantwortet beides nicht.
Passende Werkzeuge
Fragen und Antworten
Bezahlt jeder KI-Crawler automatisch?
Nein. Das beschriebene Cloudflare-Verfahren setzt Registrierung und Zahlungsbereitschaft voraus. Ein Crawler kann ein kostenpflichtiges Angebot ablehnen. Eine Preisantwort erzeugt deshalb nicht automatisch Einnahmen.
Enthält der Vergleich eigene Einnahmemessungen?
Nein. Der Beitrag vergleicht dokumentierte Angebote und Abläufe. Ein eigener bezahlter Crawl-Versuch und daraus gemessene Einnahmen werden nicht behauptet.
Quellen
- Cloudflare: Introducing pay per crawl
- Cloudflare: Pay per crawl private beta
- Google: Robots.txt limitations
- data.europa.eu: Rechte an fremden Daten und Abbildungen
Quellen erneut geprüft: 25. Oktober 2026.
Passend dazu