English
 Deutsch
 Polski
gzip, Brotli und zstd: HTTP-Kompression gemessen

Management Summary
HTTP-Kompression verkleinert übertragene Webantworten, bedeutet aber keine entsprechend vielfach schnellere Seite. Eine Stichprobe von zwanzig Domains ergab siebzehn reguläre Seiten: elf mit gzip, fünf mit Brotli und eine ohne Kompression. Drei Zugriffssperren blieben außerhalb der Auswertung. Daraus entstehen weder Marktanteile noch eine Rangliste der Verfahren. Für die Auswahl zählen identische Inhalte, Rechenzeit und Übertragungsgröße. Statische Dateien können vorab komprimiert werden; dynamische Seiten brauchen eine passende Abwägung.
Inhalt
HTTP-Kompression verringert die für einen Antwortkörper übertragenen Bytes. Das Ergebnis hängt vom Inhalt, den Kompressionseinstellungen und der tatsächlich gelieferten Antwort ab. Ein erfolgreicher HTTP-Status allein beweist noch keinen Abruf der gewünschten Startseite.
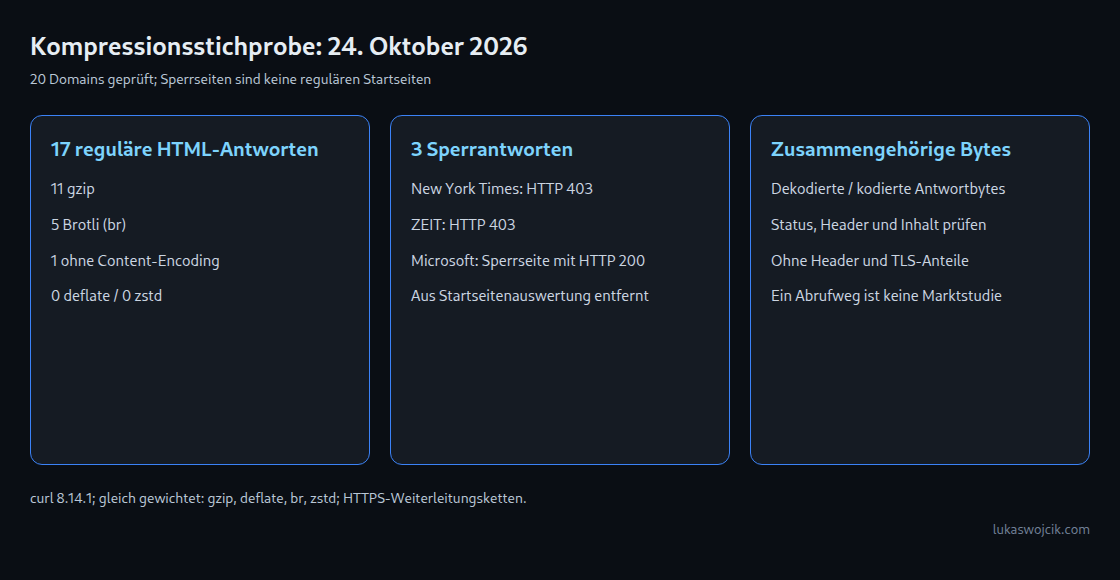
Eine Prüfung von zwanzig Domains am 24. Oktober 2026 ergab siebzehn reguläre HTML-Antworten und drei Sperrantworten. Von den siebzehn regulären Antworten nutzten elf gzip, fünf Brotli und eine kein Content-Encoding. Keine Antwort wählte zstd. Das sind Beobachtungen einer Abrufkonfiguration, keine Marktanteile oder dauerhaften Websiteeinstellungen.
Wie die Antwortkodierung gewählt wird
Accept-Encoding nennt akzeptierte Antwortkodierungen. Die Stichprobe bot gzip, deflate, br, zstd mit gleichen Standardgewichten an. Serverfähigkeiten, Konfiguration und Ressourcenart beeinflussen die Auswahl; die Reihenfolge dieser Liste garantiert keine bevorzugte Kodierung. Eine unkodierte Antwort ist normalerweise ebenfalls zulässig, sofern nicht ausdrücklich ausgeschlossen.
Content-Encoding nennt die tatsächlich angewendete Kodierung. Ein fehlendes Feld bedeutet keine deklarierte Inhaltskodierung, aber keinen Nachweis einer unveränderten Datei auf der Festplatte. HTML kann dynamisch entstehen. Mehrere Kodierungen sind ebenfalls möglich; das Dekodieren erfolgt dann in umgekehrter Reihenfolge der Anwendung.
Wenn die Darstellung von diesem Anfragefeld abhängt, hilft Vary: Accept-Encoding regelkonformen Caches bei der Trennung der Varianten. Der Header beweist keine korrekte Konfiguration aller Zwischenstationen. Gespeicherte oder vorkomprimierte Antworten können ohne erneutes Komprimieren bei jeder Anfrage ausgewählt werden.
gzip, Brotli, zstd und deflate
- gzip: weit verbreitet, aber nicht für jedes Programm oder jeden Werkzeugbuild garantiert. Die angekündigten Fähigkeiten bleiben entscheidend.
- Brotli (
br): häufig wirksam für Text. Höhere Qualitätsstufen können kleinere Dateien erzeugen, brauchen dafür aber mehr Rechenzeit; ein fester Tempo- oder Größenvorteil gilt nicht für jeden Inhalt. - Zstandard (
zstd): zielt auf ein günstiges Verhältnis zwischen Tempo und Kompressionswirkung. Stufe, Implementierung, Hardware und Daten beeinflussen das Ergebnis. Null Auswahlen in dieser Stichprobe belegen weder fehlende Browserunterstützung noch allgemeine Nichtunterstützung auf Servern. - deflate: die HTTP-Kodierung verwendet eine zlib-Hülle um DEFLATE. Auch gzip nutzt üblicherweise DEFLATE, aber eine andere Hülle. Die Formate sind nicht austauschbar.
Das tatsächliche Browserangebot hängt von Version und Kontext ab. Eine von Hand zusammengestellte curl-Anfrage prüft keine Browserkompatibilität.
Die gemessenen Antworten
Die Messung lief am 24. Oktober 2026 zwischen 04:45:33 und 04:45:37 UTC von einem Raspberry Pi aus. curl 8.14.1 unterstützte alle vier angebotenen Decoder. Je Domain erfolgte eine Abrufkette mit verfolgten HTTPS-Weiterleitungen, ohne Anmeldung oder Browser-JavaScript und mit der üblichen curl-Programmkennung. Die Tabelle beschreibt die letzte Antwort. Header, dekodierte Antwortkörper und curl-Metadaten wurden zur Nachprüfung aufbewahrt.
| Domain | HTTP | Content-Encoding | Kodierte Bytes | Dekodierte Bytes | Einordnung |
|---|---|---|---|---|---|
| wikipedia.org | 200 | gzip | 28883 | 122421 | reguläres HTML |
| github.com | 200 | gzip | 118918 | 580257 | reguläres HTML |
| bbc.com | 200 | gzip | 92972 | 649846 | reguläres HTML |
| nytimes.com | 403 | fehlt | 771 | 771 | Zugriffssperre |
| cloudflare.com | 200 | br | 109639 | 1333885 | reguläres HTML |
| mozilla.org | 200 | br | 8032 | 47807 | reguläres HTML |
| apple.com | 200 | gzip | 47325 | 326751 | reguläres HTML |
| microsoft.com | 200 | fehlt | 201253 | 201253 | Zugriffssperre |
| spiegel.de | 200 | gzip | 272825 | 1958177 | reguläres HTML |
| heise.de | 200 | gzip | 135977 | 936097 | reguläres HTML |
| python.org | 200 | fehlt | 52766 | 52766 | reguläres HTML |
| debian.org | 200 | gzip | 4279 | 15864 | reguläres HTML |
| kernel.org | 200 | gzip | 3438 | 19152 | reguläres HTML |
| gnu.org | 200 | gzip | 9806 | 31463 | reguläres HTML |
| w3.org | 200 | br | 8996 | 49520 | reguläres HTML |
| nginx.org | 200 | gzip | 2206 | 6461 | reguläres HTML |
| postgresql.org | 200 | gzip | 5914 | 25040 | reguläres HTML |
| zeit.de | 403 | fehlt | 5439 | 5439 | Zugriffssperre |
| tagesschau.de | 200 | br | 128481 | 1613994 | reguläres HTML |
| php.net | 200 | br | 11789 | 60308 | reguläres HTML |
New York Times und ZEIT antworteten mit HTTP 403. Microsoft lieferte HTTP 200, jedoch ausdrücklich eine Zugriffssperrseite. Diese drei Antworten zählen nicht zur Auswertung regulärer Startseiten. Der Microsoft-Antwortkörper umfasste 201.253 Bytes ohne deklarierte Inhaltskodierung; daraus folgt keine Kompressionsregel der eigentlichen Microsoft-Startseite.
Python.org lieferte in diesem Lauf reguläres Startseiten-HTML ohne Content-Encoding. Ein Hinweis auf fehlendes JavaScript steht innerhalb dieser Startseite; der Hinweis allein bildet keine separate Sperrseite. Frühere oder anders konfigurierte Abrufe können andere Darstellungen erhalten.
Faktor und Ersparnis sind verschiedene Zahlen
Der Faktor ergibt sich aus dekodierten Antwortbytes geteilt durch kodierte Antwortbytes. Faktor 4 bedeutet ein Viertel der ursprünglichen Körpergröße, also 75 Prozent weniger Bytes. Daraus folgt keine vierfach schnellere Darstellung der Webseite.
Unter den komprimierten regulären Antworten reichten die Faktoren von 2,93 bei nginx.org bis 12,56 bei tagesschau.de. Bei tagesschau.de standen 1.613.994 dekodierten Bytes 128.481 kodierte Bytes gegenüber, rund 92,0 Prozent weniger Antwortkörperdaten. Nicht enthalten sind Antwortheader, TLS- und Transportanteile, weitere Seitenressourcen und Darstellungsarbeit.
Verschiedene Websites liefern verschiedene Ausgangsdaten. Diese Faktoren erlauben deshalb keine Rangliste der Verfahren. Ein fairer Vergleich komprimiert identische Bytes mit dokumentierten Einstellungen und misst neben der Größe auch Rechenzeit. Entscheidend ist Wiederholung, nicht allein Dateilänge oder der Einsatz eines Frameworks.
Eine Messung braucht zusammengehörige Antwortkörper
Zwei getrennte Anfragen können unterschiedliche Inhalte, Weiterleitungen, Fehlerseiten oder Cachevarianten vermischen. Auch eine Identity-Anfrage erfordert die Prüfung des tatsächlichen Content-Encoding. Der Vergleich der übertragenen und entpackten Größe derselben Antwort verhindert, dass unterschiedliche Inhalte verglichen werden, verlangt aber weiterhin einen vollständigen erfolgreichen Transfer, korrektes Dekodieren und eine Inhaltsprüfung.
Bei dieser Messung nutzte curl --compressed: Die gespeicherte Datei war dekodiert, während size_download die übertragenen Antwortkörperbytes erfasste. Gespeicherte Antwortheader beschreiben weiterhin die Kodierung der Übertragung. Ein gzip-Header rechtfertigt deshalb kein erneutes Entpacken der bereits dekodierten Datei.
Fragen und Antworten
Lohnt zusätzliche Kompression für Bilder und Schriften?
Bereits komprimierte JPEG-, PNG-, WebP-, AVIF- und WOFF2-Dateien gewinnen häufig wenig oder werden größer. SVG ist Text und profitiert oft. Die Dateiendung allein reicht nicht zur Entscheidung; tatsächliche Bytes und MIME-Typ zählen.
Sollte Brotli immer auf der höchsten Stufe laufen?
Nein. Brotli unterstützt Qualitätsstufen von 0 bis 11. Hohe Einstellungen können deutlich mehr Rechenzeit benötigen. Statische Dateien lassen sich beim Build vorkomprimieren; bei dynamischen Antworten muss der Kompressionsaufwand zur verfügbaren Rechenleistung und zulässigen Antwortzeit passen. Auch gzip und zstd erlauben Vorkompression. Eine allgemein beste Stufe folgt aus dieser Stichprobe nicht.
Macht HTTPS Kompression unbedenklich?
Nein. Beim BREACH-Prinzip liefern Unterschiede in der Länge komprimierter Antworten Hinweise auf geheime Werte. Dieses Risiko besteht, wenn Geheimnisse und angreiferkontrollierte Inhalte eine komprimierte Antwort teilen und wiederholte Antwortlängen beobachtbar sind. Gewöhnliches HTML-Escaping beseitigt diese Voraussetzung allein nicht. Je nach Anwendung helfen das Abschalten der Kompression für betroffene Antworten, die Trennung von Geheimnissen und zurückgesendeten Eingaben oder korrekt maskierte Tokens. TLS 1.3 entfernt TLS-Kompression, aber keine HTTP-Inhaltskodierung und deren Seitenkanalrisiken.
Wie lässt sich eine einzelne gzip-Antwort prüfen?
Der folgende curl-Befehl ist für ein neues leeres Arbeitsverzeichnis und eine kleine vertrauenswürdige HTTPS-Ressource gedacht. Das Laden einer curlrc ist abgeschaltet; automatische Dekodierung und Weiterleitungen sind nicht aktiviert:
curl -q --fail --silent --show-error --max-time 30 --max-filesize 10000000 --proto "=https" -H "Accept-Encoding: gzip" -D headers.txt -o body.bin -w "%{http_code}\n" https://example.com/Vor dem Entpacken muss der ausgegebene Status 200 lauten und der endgültige Header genau Content-Encoding: gzip nennen. Vor der Auswertung der Größen muss anschließend der dekodierte Inhalt mit der erwarteten Ressource abgeglichen werden. Eine Weiterleitung, Sperrseite, fehlende Kodierung oder ein fehlerhafter curl-Abschluss ist keine gzip-Messung. Erst nach diesen Prüfungen:
gzip -t body.bin &&
gzip -dc body.bin > decoded.html &&
wc -c body.bin decoded.html
Der erste Befehl prüft die gzip-Integrität; die weiteren Befehle laufen nur bei Erfolg. Beide Bytezahlen gehören zur selben Antwort. Beim Entpacken können Daten stark wachsen; freier Speicherplatz und vertrauenswürdige Eingaben sind daher relevant. Fehlendes Content-Encoding ist ein Befund einer unkodierten Antwort und kein Anlass zum erzwungenen gzip-Entpacken. Andere Kodierungen benötigen den passenden Decoder.
Passend dazu