

 English
 Deutsch
 Polski
Was eine Sitemap verspricht und was die Adressen darin halten

Management Summary
Eine Sitemap ist ein Verzeichnis von Website-Adressen, das Suchmaschinen beim Entdecken veröffentlichter Inhalte hilft. Besonders große oder schlecht verlinkte Bestände profitieren von dieser Orientierung. Der Beitrag erklärt, warum die eingetragenen Adressen zu den vorgesehenen Seiten führen sollten und wenige geprüfte Einträge kein Urteil über die ganze Website erlauben. Eine Sitemap unterstützt die Suche, garantiert aber keine Aufnahme in Suchergebnisse. Richtige Adressen und begründete Änderungsdaten machen die Angaben brauchbar.
Inhalt
Eine Sitemap nennt URLs, die eine Website Suchmaschinen zur Entdeckung anbietet. Das erleichtert besonders bei großen oder schlecht verlinkten Beständen die Arbeit. Eine Garantie für Abruf oder Indexierung entsteht daraus nicht. Umgekehrt können Suchmaschinen Seiten auch über Links finden, ohne dass eine Sitemap vorliegt.
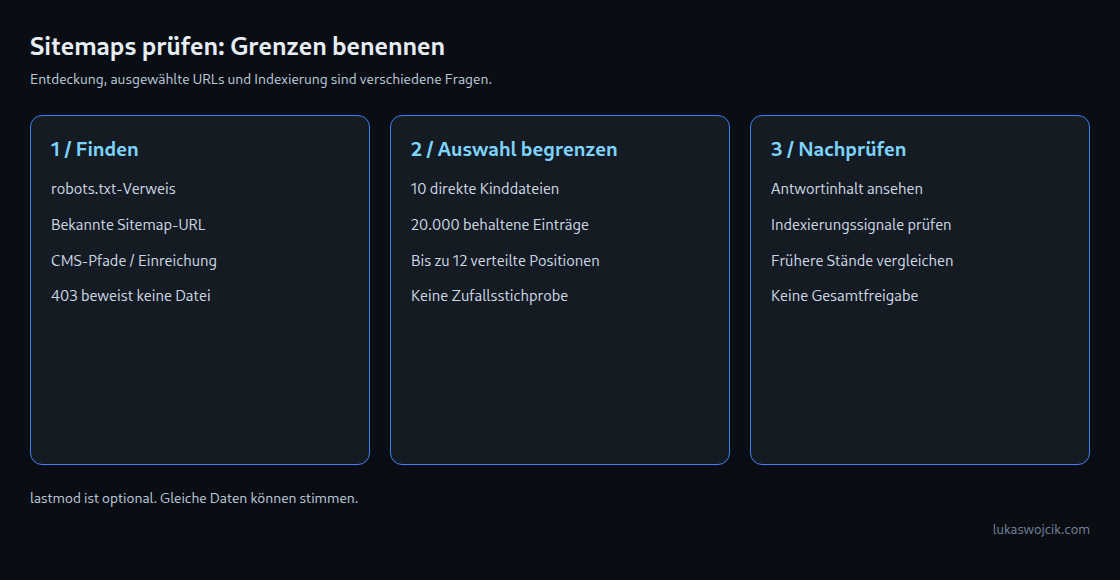
Für eine Prüfung sind drei Fragen zu trennen: Ist die Sitemap erreichbar und lesbar? Welche URLs enthält der tatsächlich gelesene Ausschnitt? Was liefern einzelne dieser URLs beim Abruf? Erst diese Trennung verhindert, dass eine begrenzte Stichprobe als Urteil über die ganze Website erscheint.
Eine Sitemap finden
Ein Eintrag Sitemap: in robots.txt nennt eine ausdrücklich veröffentlichte Adresse. Daneben können bekannte CMS-Pfade wie /sitemap.xml oder /wp-sitemap.xml, ein Sitemap-Index und eine direkt bekannte URL weiterhelfen. Bei Google ist auch die Einreichung über Search Console möglich. Es gibt somit mehr als zwei Wege; ein erfolgloser Abruf des üblichen Pfads beweist keine fehlende Sitemap.
Bei einer Antwort mit Status 403 steht zunächst nur fest, dass dieser Abruf abgewiesen wurde. Ob dahinter eine gültige Datei liegt und ob Googlebot Zugriff erhält, lässt sich daraus nicht ableiten. Dafür wären gesonderte Nachweise erforderlich.
Index und Umfang unterscheiden
Ein XML-URL-Verzeichnis enthält Seiteneinträge; ein Sitemap-Index verweist auf Sitemap-Dateien. Die Grenzen des Protokolls liegen bei 50.000 URLs beziehungsweise 50.000 Sitemap-Verweisen und jeweils 50 MB unkomprimierter Dateigröße. Ein Index innerhalb eines weiteren Index ist für Google keine unterstützte Verschachtelung.
Ein Werkzeug mit zehn gelesenen, im Index verlinkten Sitemap-Dateien hat damit keinen Bestand aus beispielsweise 22 Dateien vollständig geprüft. Ebenso müssen die Zahl erkannter Einträge, die Zahl gespeicherter Einträge und die Zahl tatsächlich abgerufener Seiten getrennt bleiben. Eine Begrenzung ist eine Eigenschaft des Tests, kein Größenlimit der Website.
Was eine Stichprobe belegt
Ein konstruiertes Beispiel: Von zwölf geprüften URLs liefern sieben eine Umleitung und fünf Status 404. Das sind zwölf auffällige Abrufe in genau dieser Auswahl. Daraus folgt weder eine Fehlerquote für die gesamte Website noch ein Nachweis über alle Suchmaschinenzugriffe. Bei einem 403 kommen Zugriffsregeln als Ursache infrage; eine endgültige Diagnose benötigt weitere Daten.
Für dauerhaft veröffentlichte Inhalte sollten Sitemaps grundsätzlich die gewünschten kanonischen Zieladressen enthalten. Gemeint sind die bevorzugten Adressen, wenn mehrere URLs gleiche oder sehr ähnliche Inhalte zeigen. Umleitungen und veraltete URLs sind Anlass zur Prüfung. Ein fehlender Canonical-Verweis auf die eigene Seitenadresse ist allein jedoch kein Indexierungsverbot; ein vorhandenes Canonical ist umgekehrt nur ein Signal. Auch Status 200 kann eine Fehler- oder Sperrseite begleiten. Antwortinhalt und gegebenenfalls Search Console liefern zusätzliche Hinweise.
lastmod: optional und inhaltlich begründet
lastmod ist optional. Ein unbekanntes Änderungsdatum darf fehlen; ein erfundenes aktuelles Datum wäre schlechter. Für Google zählt die letzte wesentliche Änderung, etwa am Hauptinhalt, an strukturierten Daten oder an relevanten Links. Ein Cache-Neubau oder ein bloß geändertes Copyright-Jahr rechtfertigt kein neues Inhaltsdatum.
Viele gleiche Daten können eine echte gemeinsame Überarbeitung abbilden. Viele verschiedene Daten beweisen keine Richtigkeit. Die Prüfung braucht einen Vergleich mit früheren Inhaltsständen oder verlässlichen Änderungsprotokollen. Ein einzelner aktueller Abruf zeigt nicht, wann sich eine Seite zuletzt verändert hat.
Der verlinkte Auditor und seine Grenzen
Der XML-Sitemap-Auditor liefert eine begrenzte Bestandsaufnahme. Der geprüfte Implementierungsstand vom 25. Oktober 2026 verwendet bei mehreren robots.txt-Angaben zunächst die erste Adresse; eine ausdrücklich eingegebene URL hat Vorrang. Ohne solche Angaben werden mehrere Standardpfade versucht. Eine Antwort mit Status 200 kann diese Suche allerdings beenden, auch wenn anschließend kein Sitemap-XML erkannt wird.
- Höchstens zehn direkt im Index verlinkte Sitemap-Dateien werden gelesen; weitere Index-Ebenen werden nicht durchlaufen.
- Für die weitere Auswertung bleiben höchstens 20.000 erkannte URL-Einträge erhalten.
- Bis zu zwölf Positionen werden gleichmäßig aus diesem Ausschnitt ausgewählt. Das ist keine Zufallsstichprobe und keine repräsentative Hochrechnung.
- Für jede Seitenprobe werden höchstens 65.536 Bytes ausgewertet. JavaScript wird nicht ausgeführt.
- Die Erkennung von Robots-Metatags und HTML-Canonical verwendet eingeschränkte Textmuster. Andere Attributreihenfolgen können unentdeckt bleiben;
X-Robots-Tag, botspezifische Metatags und HTTP-Link-Canonical werden nicht vollständig geprüft.
Das Ergebnis „sauber“ bedeutet daher nur: Unter diesen Prüfregeln wurde kein entsprechender Befund erkannt. Es bedeutet weder „vollständig validiertes XML“ noch „sicher indexierbar“. Auffällige und unauffällige Stichproben benötigen bei wichtigen URLs eine gezielte Nachprüfung.
Fragen und Antworten
Darf die Sitemap auf einem anderen Host liegen?
Das Protokoll beschreibt eine Freigabe über einen Sitemap-Verweis in der robots.txt des betroffenen Website-Hosts. Google unterstützt außerdem eine bestätigte domainübergreifende Einreichung. Ein beliebiger Verweis allein ersetzt nicht alle dafür geltenden Eigentums- und Zuordnungsregeln.
Welche Nachweise gehören zu einem Ergebnis?
Zeitpunkt, genaue Startadresse, Client, Auswahlverfahren, Abrufgrenzen, Status, Weiterleitungen und Antwortinhalt. Für Aussagen über Änderungen zusätzlich ein früherer Vergleichsstand. Ein paar erfolgreiche Abrufe dürfen nicht zur Freigabe des gesamten Bestands werden.
Passend dazu


