English
 Deutsch
 Polski
Matomo vs. GA4 w środowisku Enterprise: Kiedy warto postawić na self-hosted analytics?

Spis treści
GA4 i Matomo On-Premise odpowiadają na różne potrzeby operacyjne. GA4 zapewnia zarządzaną analitykę z bliską integracją z reklamami Google. Matomo umożliwia kontrolę instalacji i bazy danych, ale wymaga utrzymania, zabezpieczeń i planowania wydajności. Samodzielny hosting nie gwarantuje zgodności z prawem ani kompletności pomiaru.
Dostęp do danych i lokalizacja
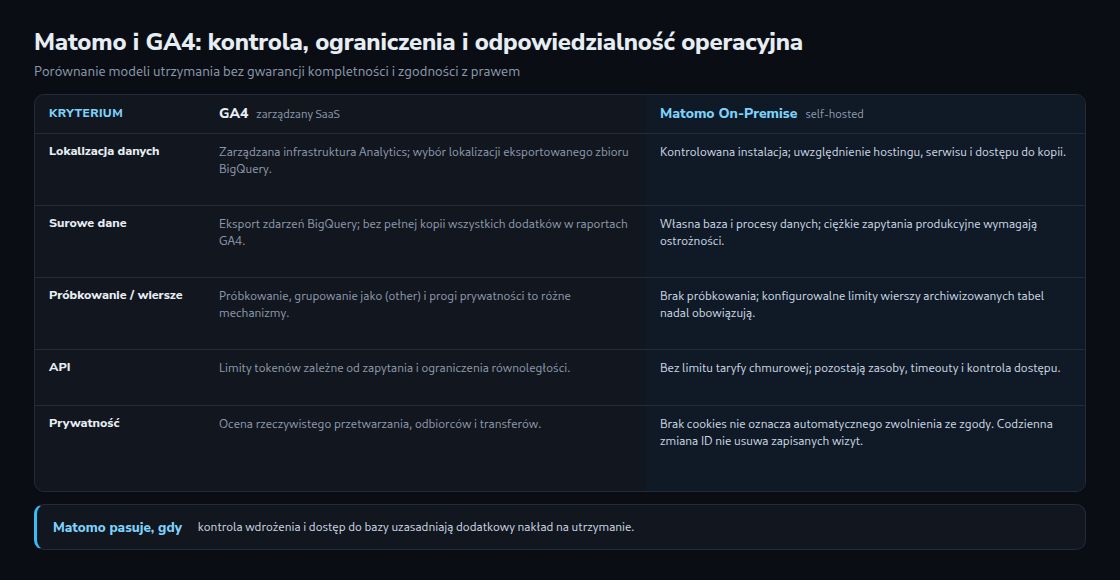
Eksport GA4 do BigQuery udostępnia niepróbkowane rekordy zdarzeń do własnych analiz SQL. Nie obejmuje wszystkich dodatków dostępnych w interfejsie GA4, takich jak modelowanie zachowań. Dzienny eksport z usługi Standard jest ograniczony do miliona zdarzeń; eksport strumieniowy ma inne właściwości dotyczące kompletności.
Lokalizację zbioru BigQuery można wybrać podczas konfiguracji, a termin usunięcia tabel ustawić oddzielnie. Kontrola dotyczy wyeksportowanych danych, nie każdego etapu przetwarzania w GA4. Schemat eksportu, uprawnienia, koszty i procedury usuwania wymagają planu utrzymania.
Matomo On-Premise zapisuje dane w kontrolowanym środowisku MySQL/MariaDB. Dostęp do bazy umożliwia własne procesy przetwarzania. Zmiany schematu produkcyjnego i ciężkie zapytania mogą jednak zakłócać aktualizacje lub zbieranie danych. Replika do odczytu albo osobna kopia analityczna często stanowi lepsze rozwiązanie. Dostawcy hostingu, dostęp serwisowy i zewnętrzne kopie zapasowe nadal należą do mapy przepływu danych.
Cztery różne rodzaje ograniczeń
- Próbkowanie: obliczenie wykorzystuje część dostępnych rekordów. W GA4 zależy to od zapytania i ograniczeń przetwarzania.
- Kardynalność: duża liczba różnych wartości wymiaru może przekroczyć limit wierszy tabeli raportu. GA4 grupuje wtedy rzadsze wartości jako
(other). To nie jest definicja próbkowania. - Progi prywatności: niektóre małe grupy są ukrywane w celu ograniczenia ryzyka identyfikacji. Jest to mechanizm odrębny od dwóch poprzednich.
- Limity API: zapytania GA4 Data API zużywają tokeny zależnie od żądania i podlegają ograniczeniom równoległości. Pamięć podręczna, krótsze zakresy dat i kontrola limitów ograniczają awarie dashboardów.
Matomo nie stosuje próbkowania, ale ma konfigurowalne limity wierszy w archiwizowanych tabelach. Zwiększenie limitów podnosi zapotrzebowanie na obliczenia i miejsce. Brak próbkowania nie oznacza zatem widoczności każdej wartości z osobna ani odzyskania utraconych żądań śledzących. On-Premise eliminuje limit narzucony przez taryfę chmurową; timeouty, zasoby serwera i kontrola dostępu nadal ograniczają rzeczywiste obciążenie API.
Brak cookies nie oznacza automatycznego zwolnienia ze zgody
Wyłączenie śledzących cookies nie usuwa automatycznie obowiązku uzyskania zgody. Dostęp do urządzenia i późniejsze przetwarzanie danych osobowych wymagają odrębnej oceny. Francuska CNIL opisuje wąski wyjątek dla pomiaru oglądalności. Warunków nie można po prostu przenieść na całą Europę. Hosting w UE i skrócenie IP nie wystarczają.
Tymczasowy config_id Matomo wspiera rozpoznawanie wizyty w krótkim oknie i zmienia się codziennie. Nie oznacza to usuwania zapisanych wizyt lub raportów po 24 godzinach. Retencja wymaga osobnej konfiguracji, a dodatkowe identyfikatory mogą zmienić ocenę prywatności.
Dokumentacja techniczna powinna obejmować żądania śledzące, pamięć przeglądarki przypisaną do trackera, identyfikatory w zapisanych wizytach, obsługę IP, ustawienia User ID i cross-domain, retencję oraz dostęp podmiotów trzecich. Pusty panel cookies potwierdza tylko część tych faktów. Dane funkcjonalne innych elementów strony nie muszą być nieobecne.
Koszt utrzymania i wybór
Porównanie powinno uwzględniać infrastrukturę, aktualizacje, odtwarzanie kopii, obsługę awarii, przeliczanie raportów i ewentualne płatne rozszerzenia. Reprezentatywny test obciążenia obejmuje szczyty zbierania danych oraz rzeczywiście używane raporty. Matomo pasuje do wymagań kontrolowanego wdrożenia i bezpośredniego dostępu do danych przy dostępnych zasobach operacyjnych. GA4 może pasować do istniejącego środowiska reklamowego Google z mniejszym nakładem na własne serwery analityczne. Oba rozwiązania wymagają specyfikacji pomiaru i kontroli jakości danych.
Pytania i odpowiedzi
Kiedy archiwizacja staje się wąskim gardłem?
Czas obliczeń zależy od ruchu, segmentów, okresów, wtyczek i wydajności bazy. Zaplanowana archiwizacja zwykle ogranicza kosztowne przetwarzanie podczas otwierania raportów. Monitoring powinien obejmować aktualność raportów, zaległości, błędy zbierania i opóźnienia pamięci masowej. Przebieg dłuższy niż interwał harmonogramu jest sygnałem ostrzegawczym, a nie uniwersalną granicą wydajności. Wyłączenie zwykłej archiwizacji uruchamianej z przeglądarki nie blokuje automatycznie każdego wywołania przez segment niestandardowy.
Czy można importować historyczne raporty GA4?
Tak. Google Analytics Importer Matomo obsługuje raporty GA4. Import tworzy nowy wpis witryny w Matomo. Zaplanowanie importu przed rozpoczęciem bieżącego śledzenia pozwala uniknąć późniejszego, nieobsługiwanego łączenia. Data końca importu i początku śledzenia zapobiegają nakładaniu danych.
Import obejmuje agregaty, a nie odtworzone surowe ścieżki odwiedzających. Brakuje dzienników wizyt, segmentacji importowanych rekordów i niektórych wskaźników. Krótki okres równoległego zbierania pomaga wyjaśnić różnice. Dane historyczne z importu i nowo zebrane dane muszą pozostać rozpoznawalne jako wynik różnych systemów pomiaru.
Czy serwer w UE zastępuje zgodę?
Nie. Lokalizacja serwera jest tylko częścią oceny. Nadal znaczenie mają cel, dostęp do urządzenia, identyfikatory, odbiorcy i przepisy krajowe. Udokumentowana, ograniczona konfiguracja jest bardziej wiarygodna niż ogólna deklaracja zgodności.
Źródła
- Matomo Developer documentation
- Matomo and GDPR
- GA4 BigQuery Export
- BigQuery Export setup
- BigQuery table lifecycle
- GA4 storage and reporting limits
- GA4 data thresholds
- GA4 Data API quotas
- Matomo sampling and table truncation
- Matomo config_id
- Matomo data retention
- Matomo capacity planning
- Matomo scheduled archiving
- Google Analytics report import
- Import limitations
- CNIL audience measurement exemption
- EDPB: technical scope of ePrivacy Article 5(3)
Powiązane artykuły