English
 Deutsch
 Polski
robots.txt für Such-, Trainings- und Assistenten-Crawler: Was jede Sperre bewirkt

Inhalt
robots.txt formuliert Vorgaben für automatische Abrufe. Suchindexierung, Modelltraining und nutzergesteuertes Nachschlagen sind verschiedene Zwecke; ein Anbieter kann denselben Abruf aber für mehrere erlaubte Zwecke verwenden. Ein User-Agent-Name beschreibt eine behauptete Rolle und bestätigt nicht die Herkunft.
Eine brauchbare Regel beginnt beim gewünschten Ergebnis: Suchsichtbarkeit erhalten, bestimmte Trainingsnutzungen ausschließen oder direkte Abrufe begrenzen. Die passenden Produktkennungen und technischen Maßnahmen unterscheiden sich.
Zwecke und Crawler-Kennungen
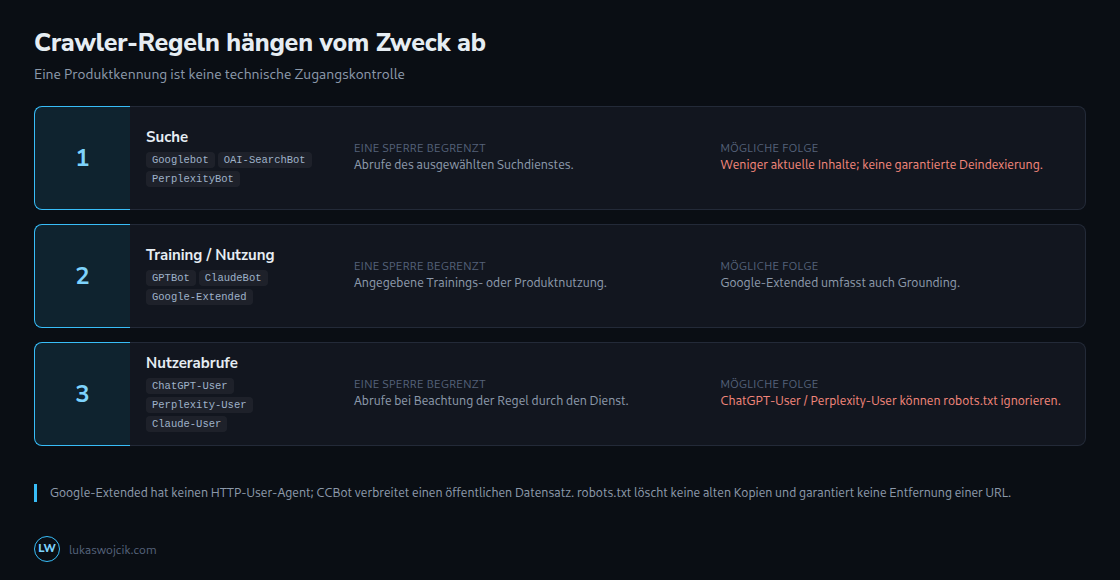
Googlebot und Bingbot erfassen Inhalte für die Suche. Eine Sperre kann die Verarbeitung neuer Inhalte verhindern und die Sichtbarkeit beeinträchtigen, garantiert aber keine Entfernung aus Suchergebnissen innerhalb weniger Wochen. Bekannte URLs können im Index bleiben. Unnütze Crawl-Pfade gezielt zu begrenzen kann sinnvoll sein; ein pauschales Disallow: / auf der Produktionswebsite benötigt eine sorgfältige Prüfung.
GPTBot und ClaudeBot unterstützen die Modellentwicklung. CCBot erstellt den öffentlichen Datensatz von Common Crawl, auch für Zwecke außerhalb des Trainings. Google-Extended ist eine Steuerungskennung für bestimmte Trainings- und Grounding-Nutzungen, kein eigener Crawler. Diese Dienste erfassen weder zwangsläufig jede Seite noch grundsätzlich nur einmal.
OAI-SearchBot, PerplexityBot und Claude-SearchBot unterstützen Suchdienste. ChatGPT-User, Perplexity-User und Claude-User dienen nutzergesteuerten Abrufen. Laut OpenAI gelten robots.txt-Regeln für ChatGPT-User möglicherweise nicht; laut Perplexity ignoriert der eigene Nutzer-Fetcher diese Regeln gewöhnlich. Anthropic erklärt dagegen die Beachtung von robots.txt für die eigenen Bots. Das Verhalten hängt somit vom Anbieter ab.
Was eine Sperre ändern kann
| Zweck | Was die Regel steuert | Grenzen und mögliche Folgen |
|---|---|---|
| Suche einschließlich KI-Suche | Begrenzt Abrufe des ausgewählten kooperierenden Suchdienstes. | Aktualität und Sichtbarkeit können leiden; keine garantierte Entfernung aus dem Index. |
| Training oder Produktnutzung | Signalisiert die Trainings- oder Nutzungsvorgabe für den betreffenden Anbieter. | Folgen hängen von der Kennung ab; Google-Extended umfasst auch Grounding. |
| Nutzergesteuerte Abrufe | Kann direkte Abrufe begrenzen, wenn der Dienst die Regel beachtet. | Anbieterabhängig: robots.txt ist keine allgemeingültige Zugangssperre. |
Eine reine Trainingskennung zu sperren muss die Suche nicht sperren. Die Aussage „ohne Folgen für die Sichtbarkeit“ geht jedoch zu weit: Google-Extended steuert auch Grounding. Außerdem garantiert eine Sperre nicht, dass keinerlei Kopie über andere Quellen in irgendeinen Trainingsdatensatz gelangt.
Google-Extended ist nicht Googlebot
Google-Extended steuert die Nutzung erfasster Inhalte für zukünftige Gemini-Generationen hinter Gemini Apps und der Vertex AI API for Gemini sowie für Grounding in Gemini Apps und Grounding with Google Search auf Vertex AI. Grounding ergänzt eine Antwort um abgerufene Informationen. Laut Google beeinflusst diese Kennung weder Aufnahme noch Platzierung in Google Search; die Aussage gilt nicht pauschal für jedes Google-KI-Produkt.
OpenAI trennt die Trainingsvorgabe für GPTBot von der Suchvorgabe für OAI-SearchBot. Ein Ausschluss von OAI-SearchBot verhindert laut OpenAI die Darstellung in ChatGPT-Suchantworten; Navigationslinks können weiterhin erscheinen. ChatGPT-User steuert die Suchaufnahme nicht. Ein erlaubter Abruf garantiert weder eine Quellenangabe noch einen Besuch.
Grenzen rückwirkender Kontrolle
Neue Regeln wirken nach Abruf und Verarbeitung der Datei durch den Dienst. Zwischengespeicherte Fassungen können die Änderung verzögern. Ein neues Disallow ist kein Befehl zum Löschen bereits gesammelter Archive oder zum Entfernen von Informationen aus einem bereits trainierten Modell.
Löschanfragen und Zugangskontrollen sind eigenständige Maßnahmen. robots.txt allein garantiert keine rückwirkende Löschung, auch nicht für Kopien aus Drittquellen.
llms.txt als Inhaltswegweiser
llms.txt bietet einen redaktionell ausgewählten Markdown-Wegweiser zu hilfreichen Inhalten. Die Überarbeitung des Vorschlags vom August 2026 unterstützt auch Dateien unterhalb der Website-Wurzel, etwa /docs/llms.txt für diesen Pfad.
Der Vorschlag verpflichtet nicht jeden Crawler zur Nutzung und legt keine Zugangsberechtigung fest. Eine aufgeführte URL erteilt weder eine Lizenz noch überstimmt der Eintrag robots.txt, Anmeldung oder andere Zugangskontrollen. Der Wegweiser braucht korrekte Links und Pflege; die Erstellung garantiert keine bessere Suchplatzierung.
Grenzen von robots.txt
robots.txt ist ein Protokoll für kooperierende automatische Clients, keine Zugangskontrolle. Regelwidrig handelnde Clients und manche nutzergesteuerten Abrufdienste können öffentliche Inhalte weiterhin anfordern. Vertrauliche Inhalte benötigen echte Berechtigungsprüfungen.
Eine gesperrte URL kann weiterhin in Suchergebnissen erscheinen, ohne eine aus der Seite abgerufene Beschreibung. Bei unterstützenden Suchmaschinen verlangt noindex den Ausschluss von der Indexierung; dafür muss der Crawler diese Anweisung abrufen können. Eine gleichzeitige Crawl-Sperre kann das Entdecken einer neu gesetzten noindex-Anweisung verhindern.
Entscheidende technische Einzelheiten
Google-Extended ist keine HTTP-Kennung
Google-Extended hat keinen eigenen HTTP-User-Agent. Google verwendet vorhandene Crawler-Kennungen und wertet das Token als Vorgabe zur Produktnutzung aus. Eine Serverregel allein gegen den Namen „Google-Extended“ setzt diese Vorgabe daher nicht um. Eine Sperre des tatsächlich abrufenden Crawlers kann zugleich die Suche treffen und ist kein gleichwertiger Ersatz.
CCBot speist ein öffentliches Archiv
Common Crawl meldet den Crawler als CCBot/2.0 und dokumentiert die Beachtung von robots.txt. Die Daten sind unter den Common-Crawl-Bedingungen über Amazon S3 verfügbar. Der Datensatz bildet eine Auswahl des Webs, kein garantiert vollständiges Archiv jeder Website. Sperren einzelner Modellanbieter lassen diesen gesonderten Verbreitungsweg offen, solange keine eigene Regel dafür besteht.
Doppelte Gruppen führen Regeln zusammen
RFC 9309 führt Gruppen mit derselben passenden Produktkennung ohne Rücksicht auf Groß- und Kleinschreibung zusammen. Innerhalb der zusammengeführten Regeln gewinnt der spezifischste passende Pfad. Zwei GPTBot-Gruppen mit Disallow: / und Allow: /blog/ erlauben deshalb /blog/. Doppelte Gruppen gehören gemeinsam geprüft.
Fragen und Antworten
Gilt eine Regel unter User-agent: * auch für einen Crawler, der in der Datei eine eigene Gruppe hat?
Eine passende benannte Gruppe hat Vorrang vor der Auffanggruppe User-agent: *; die Regeln werden nicht miteinander verschmolzen. Eine OAI-SearchBot-Gruppe mit ausschließlich Allow: / übernimmt deshalb keine Ausschlüsse aus der Sternchengruppe.
Gemeinsame Ausschlüsse müssen auch in den zutreffenden benannten Gruppen stehen. Die längste passende Regel gewinnt; bei gleichwertigen Regeln soll laut RFC Allow gewinnen. Bei Pfaden empfiehlt das RFC die Beachtung der Groß- und Kleinschreibung, anders als beim Vergleich der Produktkennungen.
Woran lässt sich erkennen, ob ein Abruf wirklich von Googlebot oder ChatGPT-User stammt und nicht nur so heißt?
Der HTTP-User-Agent ist frei wählbar. Die Herkunftsprüfung sollte dem dokumentierten Verfahren des Anbieters folgen und die betreffende Crawler-Kategorie unterscheiden:
- Bei Google die Quell-IP rückwärts auflösen, das dokumentierte Hostnamenmuster der betreffenden Crawler-Kategorie prüfen und den Hostnamen vorwärts auf die ursprüngliche IP zurückführen. Der Domainvergleich braucht eine echte Namensgrenze: evilgooglebot.com ist nicht googlebot.com. Eine fehlgeschlagene Prüfung lässt die Herkunft unbestätigt und beweist noch keine Fälschung.
- Alternativ die Quell-IP mit den aktuellen offiziellen Bereichen des jeweiligen Crawlers abgleichen. Google und OpenAI veröffentlichen maschinenlesbare Listen. Ein Treffer in einem allgemeinen Cloud-Adressbereich reicht nicht aus.
Für serverseitige Ausnahmen muss die Prüfung vor einer Vertrauensentscheidung anhand des Namens stehen. Die Zugehörigkeit zu einer gemeinsamen Cloud belegt noch keinen Googlebot-Abruf. Hinter Proxys muss auch die Quelladresse über einen vertrauenswürdigen Netzwerkpfad ermittelt werden.
Was geschieht, wenn die robots.txt selbst nicht erreichbar ist oder einen Fehler liefert?
RFC 9309 erlaubt Abrufe bei nicht verfügbarer robots.txt, beispielsweise mit einer 4xx-Antwort. Bei Netzwerk- oder Serverfehlern verlangt das RFC eine vollständige Sperre, soweit keine nutzbare zwischengespeicherte Regel gilt. Nach längerer Störung, beispielsweise 30 Tagen, darf die Datei als nicht verfügbar behandelt werden. Zwischengespeicherte Regeln sollten gewöhnlich höchstens 24 Stunden verwendet werden; eine Ausnahme gilt bei unerreichbarer robots.txt.
Google dokumentiert konkrete Abweichungen: 4xx-Antworten außer 429 bedeuten keine Crawl-Beschränkung. Nach einem Serverfehler beim Abruf der robots.txt pausiert Google zunächst zwölf Stunden und verwendet anschließend bis zu 30 Tage die letzte gültige Datei bei fortgesetzten Abrufversuchen. Ohne zwischengespeicherte Datei nimmt Google keine Beschränkung an. Bei anhaltender Störung zählt zusätzlich die allgemeine Erreichbarkeit der Website. Eine 403-Antwort für robots.txt ist daher keine verlässliche Crawl-Sperre.
Wirkt eine Sperre für Google-Extended auch auf die KI-Übersichten in der Google-Suche?
Google-Extended steuert weder AI Overviews noch AI Mode in der Suche. Dafür gelten Googlebot-Zugriff und Suchsteuerungen. nosnippet, max-snippet und data-nosnippet begrenzen nutzbare angezeigte Inhalte; noindex verlangt den Ausschluss von der Indexierung. Diese Vorgaben können auch die gewöhnliche Suchdarstellung verändern. Änderungen benötigen erneuten Abruf und Verarbeitung.
Quellen
- RFC 9309: Robots Exclusion Protocol
- Google Search Central: crawlers
- RFC 8615: Well-Known URIs
- Google Search Central: Google’s common crawlers
- Common Crawl: FAQ
- OpenAI: Crawlers
- Perplexity: Crawlers
- Anthropic: Crawlers
- Google: robots.txt
- Google: AI features in Search
- Google: Crawler verification
- llms.txt proposal, v2
Passend dazu