English
 Deutsch
 Polski
robots.txt dla crawlerów wyszukiwarek, treningowych i asystentów: co daje każda blokada

Spis treści
Jeden plik, trzy grupy czytelników niemające ze sobą nic wspólnego. Crawler wyszukiwarki pobiera stronę, aby dało się ją znaleźć; crawler trenujący pobiera ją, aby powstał z niej model; asystent pobiera ją, bo minutę temu ktoś zadał pytanie. Rozróżnić tę trójkę da się wyłącznie po nazwie, którą się przedstawia, a blokada jednego nic nie mówi o pozostałych.
Dlatego zwyczajowe polecenie – zablokować crawlery AI – nie jest jedną decyzją, lecz trzema, a dwie z nich kosztują coś, czego przy dopisywaniu wiersza rzadko się dopowiada.
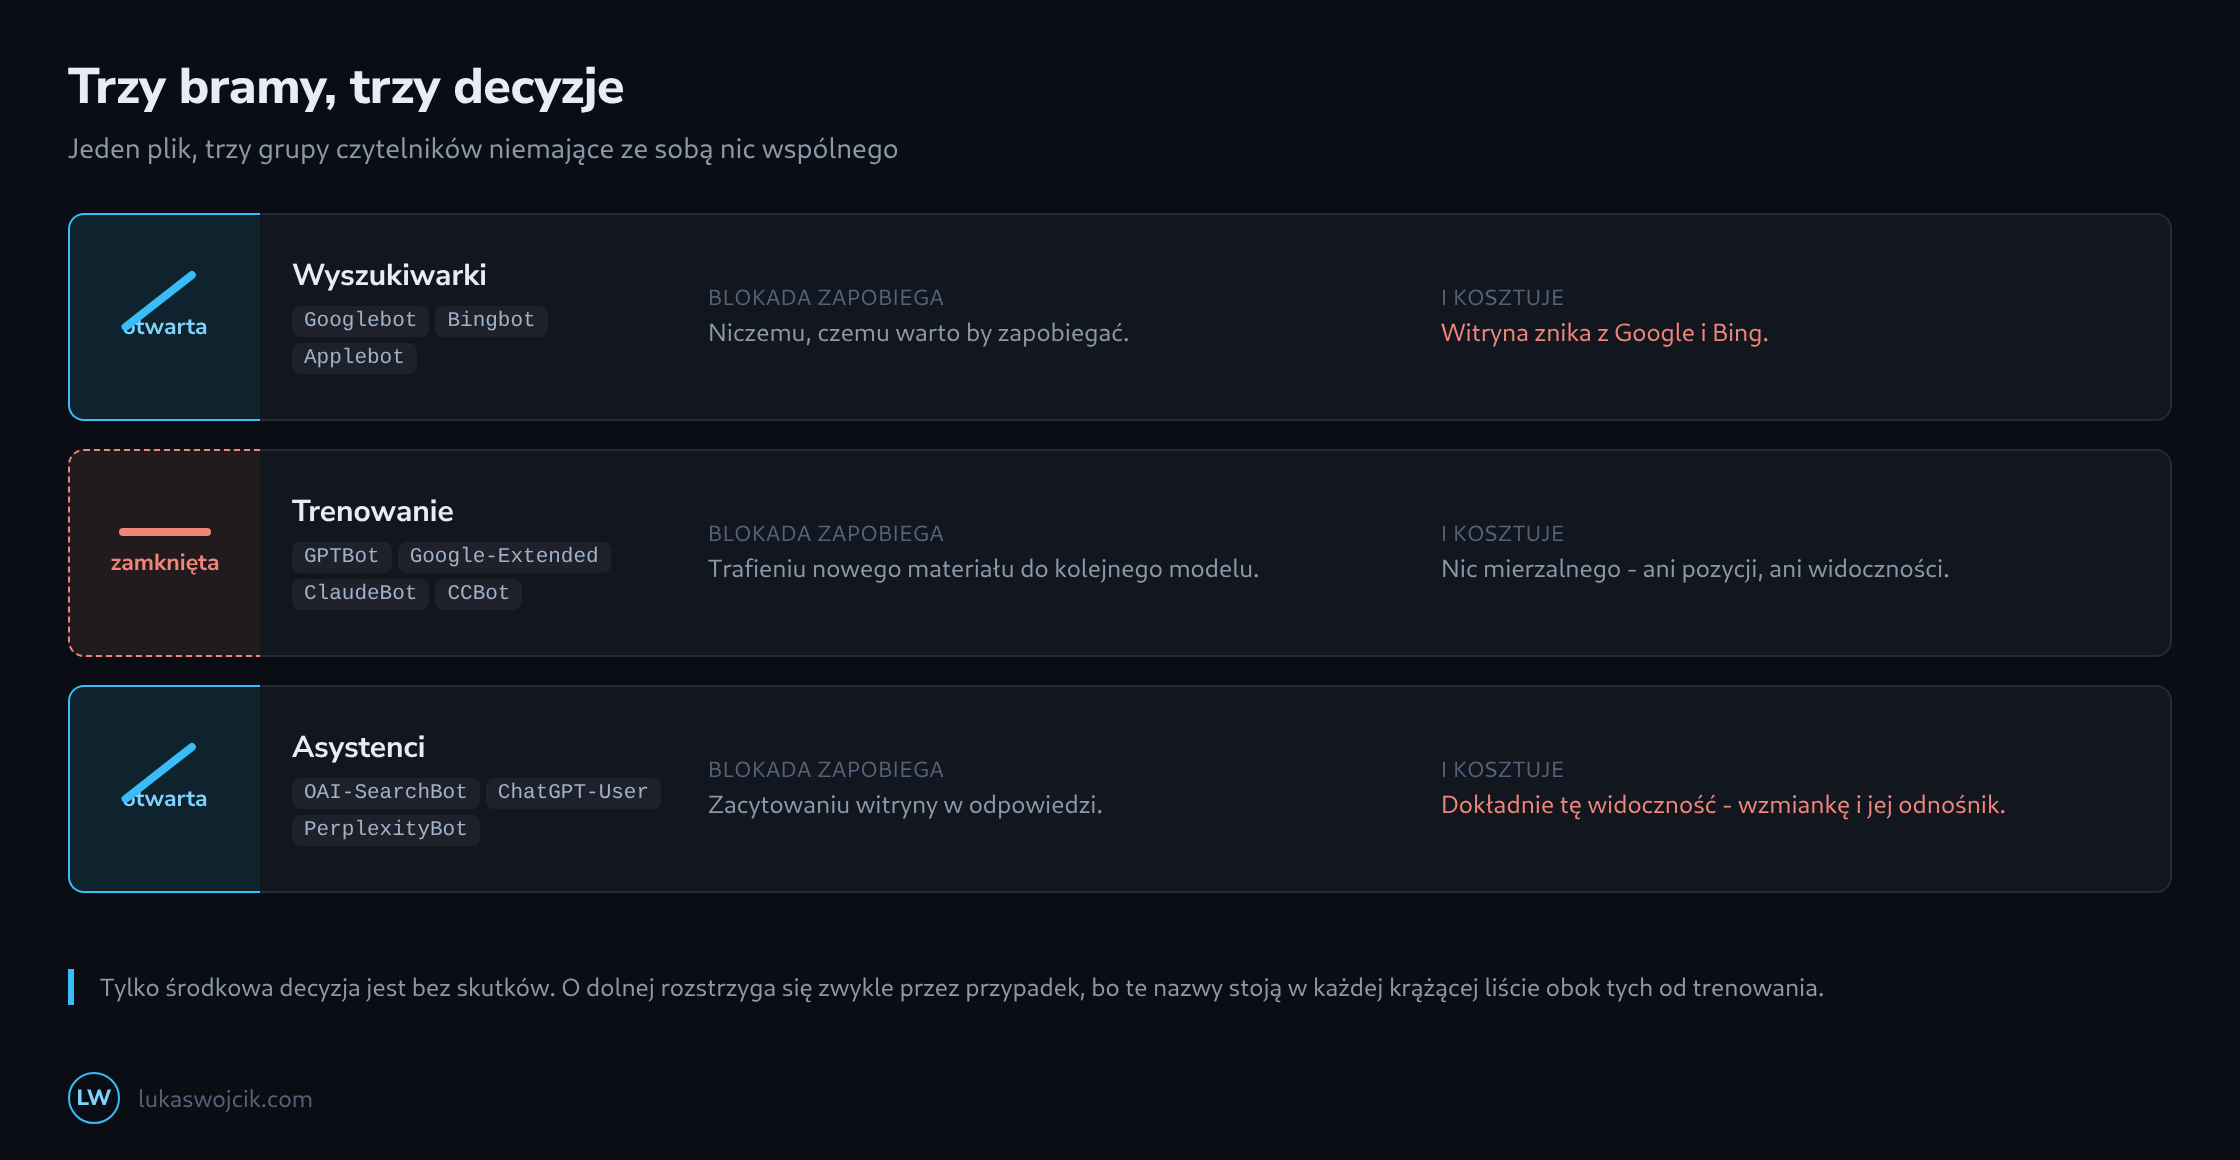
Trzy rodzaje wykonujące różną pracę
Crawlery wyszukiwarek – Googlebot, Bingbot i reszta – budują indeks, z którego pochodzą zwykłe wyniki. Blokada usuwa witrynę z wyszukiwarki w ciągu tygodni, dlatego nikt nie robi tego celowo i dlatego zdarza się przez przypadek: Disallow: / ze środowiska testowego, które przetrwało przeprowadzkę.
Crawlery trenujące – GPTBot, Google-Extended, ClaudeBot, CCBot i inne – zbierają materiał, z którego powstają modele. Pobierają raz i czytają wszystko; nic z tego nie wraca jako odwiedziny.
Crawlery asystentów – OAI-SearchBot, ChatGPT-User, PerplexityBot – pobierają stronę, bo właśnie teraz odpowiadają na pytanie. To, co pobiorą, często wraca: jako źródło, jako odnośnik, jako to zdanie, które ktoś czyta zamiast wyniku wyszukiwania.
Czemu zapobiega i ile kosztuje każda blokada
| Blokowane | Zapobiega | Kosztuje |
|---|---|---|
| Wyszukiwarki | Niczemu, czemu warto by zapobiegać. | Witryna znika z Google i Bing. |
| Trenowanie | Trafieniu nowego materiału do kolejnego modelu. | Nic mierzalnego – ani pozycji, ani widoczności. |
| Asystenci | Zacytowaniu witryny w odpowiedzi. | Dokładnie tę widoczność – wzmiankę i odnośnik przy niej. |
Środkowy wiersz to ten, o którym da się rozstrzygnąć z zasady i nic za to nie zapłacić. Dolny to ten, o którym rozstrzyga się przez przypadek, bo nazwy stoją w każdej krążącej liście tuż obok tych od trenowania.
Google-Extended to nie Googlebot
Rozróżnienie budzące najwięcej wahania: Google-Extended reguluje, czy treści służą do trenowania Gemini i modeli Vertex oraz do ugruntowania odpowiedzi (grounding) w aplikacjach Gemini i w Grounding with Google Search na Vertex AI. Na pobieranie dla wyszukiwarki, na indeksowanie i na pozycję nie wpływa. Blokada niczego nie zmienia w tym, jak strona radzi sobie w Google, i nie jest to twierdzenie, któremu trzeba zaufać – po to ta nazwa istnieje.
Ten sam podział przebiega przez pozostałych dostawców. GPTBot to trenowanie; OAI-SearchBot zasila indeks wyszukiwania za asystentem; ChatGPT-User to pobranie następujące, gdy pyta człowiek. Zablokowanie wszystkich trzech, bo nazwy wyglądają podobnie, to najczęstsza droga, którą witryna po cichu znika z odpowiedzi, w których chciała się znaleźć.
Wstecz nic nie działa
Blokada obowiązuje od chwili odczytania. To, co już pobrano, siedzi w zbiorach z tego zbudowanych, a te nie zaglądają ponownie do robots.txt. Witryna działająca od lat, która dziś dopisuje te wiersze, rozstrzygnęła o przyszłych pobraniach, a nie o minionych.
Warto to powiedzieć wprost, bo decyzję przedstawia się często jako usunięcie. Nie jest usunięciem, lecz płotem wokół tego, czego jeszcze nie pobrano.
llms.txt: mapa, a nie reguła
Plik pod /llms.txt jest w zamyśle przeciwieństwem robots.txt: nie zabrania, tylko wskazuje. Krótki dokument Markdown nazywający, o co w witrynie chodzi i które strony niosą treść – spis rzeczy dla czegoś, co czyta się bez nawigacji.
Dwie rzeczy trzeba przy tym wyjaśnić. To propozycja, a nie standard, i żaden crawler nie ma obowiązku go szukać. I niczego nie ogranicza: strona tam wymieniona nie staje się przez to dozwolona, a brakująca nie staje się chroniona. Napisanie kosztuje dziesięć minut i jest warte dokładnie tyle, co dobry spis treści – czyli zupełnie nic, jeśli strony za nim są ubogie.
Czego robots.txt nie potrafi
To prośba, a nie zamek. Każdy crawler sam decyduje, czy się do niej stosuje, a ci, którzy to robią, są dokładnie tymi, którzy publikują nazwę, pod którą da się ich zablokować. Tego, co plik ignoruje, nic w nim nie dotyczy.
I nie trzyma strony poza wynikami wyszukiwania. Zablokowana strona, do której inni odsyłają, i tak może się pojawić, tyle że bez opisu, bo crawlerowi nie wolno było odczytać jej treści. Trzymanie czegoś poza indeksem wymaga noindex – do czego crawler musi mieć wstęp, aby to odczytać – a trzymanie czegoś w prywatności wymaga logowania. robots.txt stoi poniżej obu i dobrze nadaje się dokładnie do tego, czym jest: do kierowania ruchem tych crawlerów, które dają się kierować.
Trzy szczegóły kryjące się za nazwami
Google-Extended nie da się zablokować na serwerze
Google-Extended nie ma własnego ciągu user agent. Dokumentacja crawlerów Google podaje, że pobieranie odbywa się z użyciem istniejących user agentów Google, a nazwa w robots.txt pełni wyłącznie funkcję sterującą. Pod tą nazwą nie dociera więc żadne żądanie. Reguła zapory lub serwera oparta na niej niczego nie łapie, a reguła wymierzona w tego, kto faktycznie pobiera, czyli w Googlebota, usuwa witrynę z wyszukiwarki. W kwestii trenowania i groundingu po stronie Google jedyną dźwignią pozostaje wpis w robots.txt.
CCBot zasila publiczne archiwum
CCBot to crawler Common Crawl. Przedstawia się jako CCBot/2.0 i przestrzega robots.txt. Zebrane dane leżą w Amazon S3 i są publikowane jako otwarty zbiór danych z możliwie najmniejszymi ograniczeniami. To, co pobierze CCBot, nie zostaje więc u jednego dostawcy modeli, lecz jest dostępne dla każdego, kto pobierze archiwum. Blokada crawlerów trenujących poszczególnych dostawców przy otwartym CCBot zostawia tę okrężną drogę otwartą.
Nazwa podana dwa razy jest scalana, a nie losowana
Pliki rozrastające się latami czasem wymieniają ten sam crawler w dwóch grupach. RFC 9309 rozstrzyga ten przypadek: crawlery dopasowują nazwę bez względu na wielkość liter, a jeśli pasuje więcej niż jedna grupa, ich reguły zostają połączone w jedną grupę. W tej scalonej grupie, jak w każdej innej, decyduje najdłuższa pasująca reguła. Dwie grupy dla GPTBot, jedna z Disallow: /, druga z Allow: /blog/, zostawiają zatem /blog/ otwarte. Przy dopisywaniu grupy blokującej zamiar mógł być inny. Wyszukanie w pliku każdej nazwy crawlera pokazuje takie powtórzenia w kilka sekund.
Pytania i odpowiedzi
Czy reguła pod User-agent: * obowiązuje także crawlera, który ma w pliku własną grupę?
Nie, i właśnie na tym łatwo potyka się dopisywanie nazw crawlerów AI. Zgodnie z RFC 9309 crawler stosuje się do grupy noszącej jego nazwę, a do grupy pod User-agent: * tylko wtedy, gdy takiej grupy nie ma. Obie grupy nie są łączone. Osobna grupa dla OAI-SearchBot z Allow: /, która ma wprost dopuścić asystentów, znosi więc dla tego crawlera także wszystkie blokady z grupy *, na przykład tę dla panelu administracyjnego.
Reguły, które mają dotyczyć wszystkich, trzeba zatem powtórzyć w każdej nazwanej grupie. W obrębie grupy rozstrzyga potem najdłuższa pasująca reguła, a przy remisie według RFC powinna wygrać Allow. Dzięki temu da się zablokować witrynę z wyjątkiem jednego katalogu bez wyliczania każdej ścieżki z osobna.
Po czym poznać, że pobranie naprawdę pochodzi od Googlebota lub ChatGPT-User, a nie tylko używa tej nazwy?
Po samej nazwie nie, bo nazwę w nagłówku User-Agent każdy nadawca może wpisać dowolnie. Wiarygodne jest dopiero pochodzenie żądania, a da się je ustalić na dwa sposoby:
- Odwrotne zapytanie DNS i zapytanie kontrolne w przód. Dla adresu IP sprawdza się nazwę hosta; w przypadku crawlerów Google kończy się ona na googlebot.com, google.com lub googleusercontent.com. Następnie ta sama nazwa hosta musi wskazywać z powrotem na ten sam adres, w przeciwnym razie wpis jest sfałszowany. Tę procedurę opisuje samo Google.
- Opublikowane zakresy adresów. Kilku dostawców, w tym Google i OpenAI, publikuje zakresy IP swoich crawlerów jako listy do odczytu maszynowego, z podziałem na rodzaje crawlerów. Porównanie z nimi da się zautomatyzować i nie wymaga zapytania DNS przy każdym żądaniu.
Dla robots.txt nie ma to znaczenia: pobranie, które podaje się za Googlebota i ignoruje plik, i tak nie podlega niczemu, co w nim stoi. Sprawdzenie zyskuje wagę, gdy blokada ma być egzekwowana na serwerze, na przykład w firewallu. Powinno wtedy stać przed każdą regułą rozstrzygającą po nazwie, żeby wyjątek dla prawdziwych crawlerów wyszukiwarek nie stał otworem przed każdym, kto tak się nazwie.
Co się dzieje, gdy sam plik robots.txt jest nieosiągalny albo zwraca błąd?
To zależy od kodu stanu, a oba przypadki działają w przeciwnych kierunkach. Według RFC 9309 odpowiedź z zakresu od 400 do 499 oznacza brak pliku: crawler może pobierać wszystko. Błąd serwera z zakresu od 500 do 599 lub awaria sieci oznacza natomiast pełną blokadę; dopiero gdy taki stan trwa długo, a RFC podaje jako przykład 30 dni, crawler może sięgnąć po kopię z pamięci podręcznej albo potraktować plik jako nieistniejący.
Wynikają z tego dwie pułapki w pozostałej konfiguracji. Reguła w konfiguracji serwera, która przez przypadek obejmuje także robots.txt i odpowiada tam kodem 403, 404 albo 410, znosi wszystkie blokady z pliku. Przeciążony serwer, który na zapytanie o robots.txt odpowiada kodem 503, trzyma z kolei z dala także crawlery wyszukiwarek. Poza tym każda zmiana działa dopiero wtedy, gdy crawler pobierze plik na nowo; RFC zaleca, by nie korzystać z kopii z pamięci podręcznej dłużej niż 24 godziny.
Czy blokada Google-Extended działa także na AI Overviews w wyszukiwarce Google?
Nie. AI Overviews są częścią wyszukiwarki i opierają się na tym, co pobrał Googlebot, a na to Google-Extended nie wpływa. To, ile ze strony się tam pojawi, da się ograniczyć tylko ustawieniami fragmentów, takimi jak nosnippet czy max-snippet, albo całkiem wykluczyć przez noindex, a oba sposoby obowiązują wtedy także w zwykłym wyniku wyszukiwania.
Powiązane artykuły