English
 Deutsch
 Polski
Prometheus auf dem Raspberry Pi: Wie Labels die Zeitreihen vervielfachen und wie sich der Verursacher findet

Inhalt
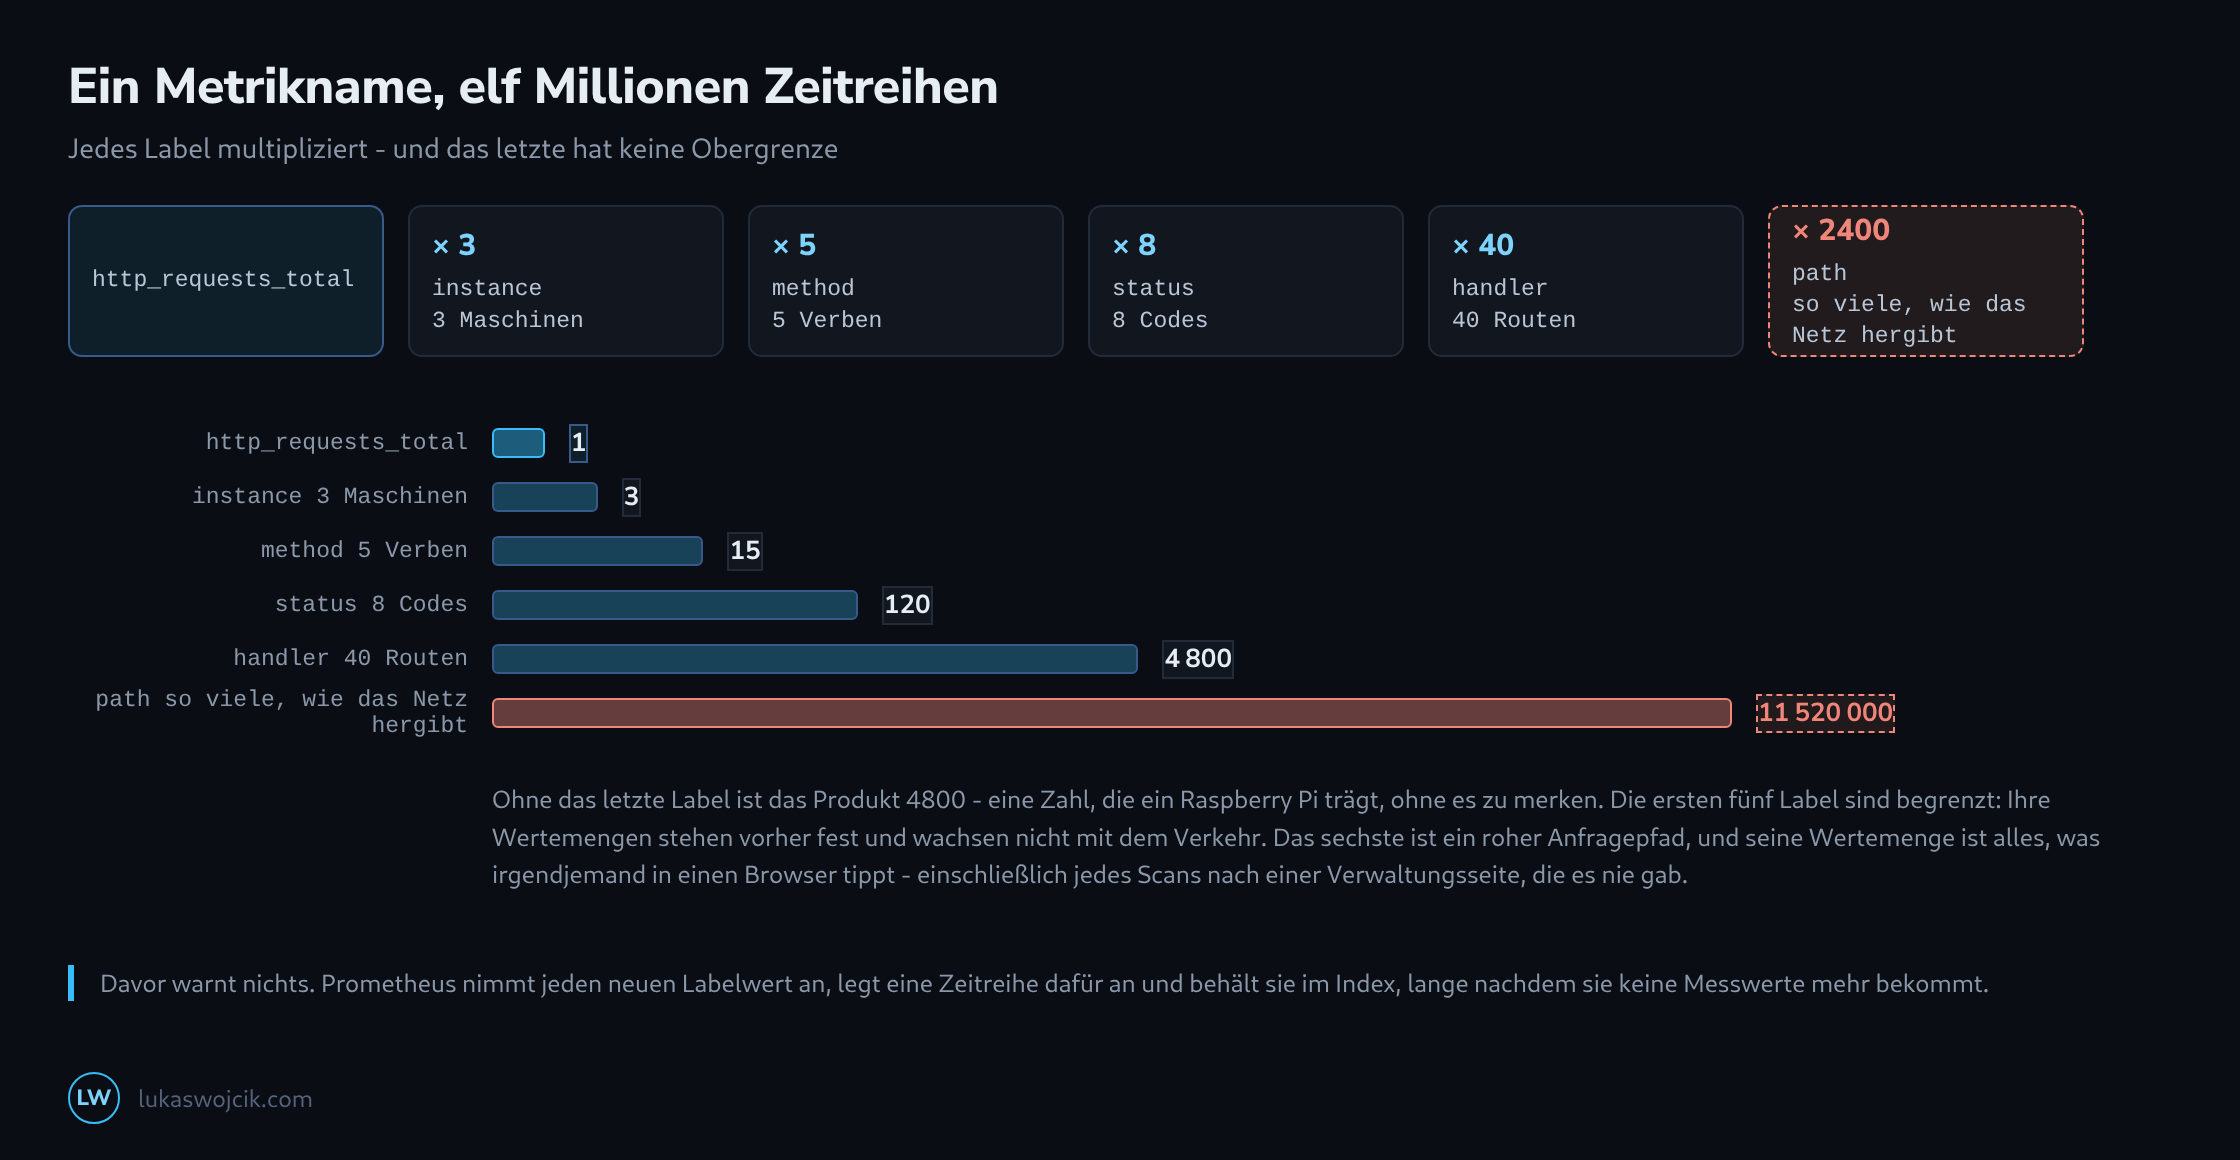
Ein Raspberry Pi mit Prometheus wird meist über die Zahl der Exporter ausgelegt, und das ist die falsche Einheit. Prometheus speichert keine Metriken; es speichert je unterschiedlicher Kombination von Labelwerten eine Zeitreihe, und die Zahl dieser Kombinationen ist ein Produkt.
Ein Produkt verhält sich anders als eine Summe. Ein sechster Exporter bringt ein paar hundert Zeitreihen hinzu. Ein sechstes Label an einer vorhandenen Metrik vervielfacht alles, was schon da war.
Begrenzte und unbegrenzte Label
Die brauchbare Unterscheidung ist nicht, wie viele Werte ein Label heute hat, sondern ob seine Wertemenge vorher feststeht. method hat fünf Werte und wird auch nächstes Jahr fünf haben. status hat ein Dutzend. instance wächst, wenn eine Maschine dazukommt – und das entscheidet jemand.
Ein roher Anfragepfad hat so viele Werte, wie es Zeichenketten gibt, und er wächst am schnellsten, während die Seite angegriffen wird: Jeder Scan nach /wp-admin, /.env und /phpmyadmin legt eine dauerhafte Zeitreihe an – in einer Überwachung, die eine Seite beobachtet, die diese Seiten gar nicht hat.
| Label | Werte | Begrenzt durch |
|---|---|---|
job, instance |
eine Handvoll | die vorhandenen Maschinen |
method, status |
5 bis 12 | die HTTP-Spezifikation |
handler, route |
Dutzende | die Routen im Programm |
path (roh) |
unbegrenzt | nichts – es wächst mit den Scannern |
user_id, email |
unbegrenzt | nichts, und es gehört in keine Überwachung |
container_id, pod |
über die Zeit unbegrenzt | nichts – ein neuer Wert bei jeder Auslieferung |
Die letzte Zeile ist die hinterhältige, denn die Zahl der zu einem Zeitpunkt lebenden Zeitreihen bleibt klein. Unbegrenzt wächst der Index, der sich jede Zeitreihe merken muss, die es innerhalb der Aufbewahrung je gab. Eine Auslieferung je Stunde mit frischer Containerkennung ergibt eine Überwachung, die jede Woche langsamer wird, während die Übersichtsseite nichts Auffälliges zeigt.
Was das in der Praxis kostet
Der Arbeitsspeicher ist die bindende Grenze, lange bevor es die Platte ist. Der Kopfblock hält jede aktive Zeitreihe samt Index im Arbeitsspeicher, in der Größenordnung einiger Kilobyte je Reihe, und eine Abfrage über viele Reihen braucht obendrein Platz.
Der Ausfall kommt nicht allmählich. Prometheus wächst, bis der Kern es abräumt, startet neu, spielt das Schreibprotokoll ein, wächst wieder und wird wieder abgeräumt – meist binnen Minuten nach der ersten größeren Abfrage einer Übersichtsseite. Was wie ein kaputter Exporter aussieht, ist eine Metrik, die vor drei Auslieferungen ein Label bekommen hat.
Die drei Abfragen, die es finden
# welche Metriknamen tragen die meisten Zeitreihen
topk(10, count by (__name__)({__name__=~".+"}))

# wie viele verschiedene Werte hat ein Label, für eine Metrik
count(count by (path) (http_requests_total))

# Zeitreihen im Kopfblock insgesamt, und wie schnell sie wachsen
prometheus_tsdb_head_series
delta(prometheus_tsdb_head_series[1h])
Die erste Abfrage nennt die Metrik, die zweite das Label, und die dritte sagt, ob das Problem eine Größe oder ein Leck ist. Eine Kopfblockzahl, die stetig steigt, obwohl nichts hinzugefügt wird, ist Fluktuation – und Fluktuation ist immer ein Label, das sich ändert, obwohl es das nicht sollte.
Es lohnt sich, diese Abfragen einmal auf einer gesunden Anlage laufen zu lassen, allein um zu wissen, wie normal aussieht. Eine Zahl ohne Vergleichswert ist keine Diagnose.
Ein Label zu entfernen ist eine Zeile
Die billigste Abhilfe greift beim Abtasten, bevor irgendetwas gespeichert wird. Ein Block metric_relabel_configs entfernt das Label aus den eingehenden Messwerten, und alles Nachgelagerte schrumpft um den Faktor, den dieses Label beigetragen hat.
scrape_configs:
  - job_name: 'app'
    static_configs:
      - targets: ['app:9100']
    metric_relabel_configs:
      - regex: 'path|user_id|container_id'
        action: labeldrop
Entfernen ist nicht dasselbe wie Zusammenfassen: Die Zeitreihen der einzelnen Pfade verschwinden, und die Zählstände, die sie hielten, gehen in den verbleibenden Reihen auf. Das ist meist ohnehin das Gewollte – kaum jemand sieht sich eine Anfragezahl je Pfad an, und wer es tut, will sie nach Route gruppiert und nicht nach Adresse.
Wo die Einzelheit wirklich zählt, lautet die Antwort, sie an der Quelle zu begrenzen: nach handler oder nach einer normalisierten Routenvorlage benennen statt nach dem rohen Pfad, damit aus /produkt/12345 und /produkt/12346 eine Zeitreihe wird statt zweier.
Eine Regel für neue Metriken
Bevor ein Label dazukommt, lohnt die Frage, welche Wertemenge es hat und wer darüber entscheidet. Nennt die Antwort einen Menschen oder eine Konfigurationsdatei, ist das Label begrenzt. Nennt sie einen Besucher, eine Anfrage oder eine Kennung, ist es das nicht – und es zeigt sich später an einem Pi, auf dem Prometheus nicht mehr hochkommt.
Dieselbe Frage klärt nebenbei die Datenschutzseite, denn die unbegrenzten Label sind genau die, die Personen bezeichnen. Eine E-Mail-Adresse in einem Metriklabel ist im selben Atemzug ein Kardinalitäts- und ein Datenschutzproblem, und beides löst sich dadurch, sie dort nicht hinzuschreiben.
Fragen und Antworten
Hilft eine kürzere Aufbewahrungszeit gegen den Speichermangel?
Nur gegen einen Teil davon. Der Kopfblock im Arbeitsspeicher umfasst lediglich die jüngsten zwei bis drei Stunden, gleich ob die Aufbewahrung zwei Wochen oder ein Jahr beträgt; eine kürzere Aufbewahrung begrenzt aber, wie weit Fluktuation den Index der älteren Blöcke aufbläht, und macht damit Abfragen über lange Zeiträume schneller. Aus demselben Grund sinkt prometheus_tsdb_head_series nach einem labeldrop nicht sofort, sondern erst, wenn die alten Zeitreihen bei einer der nächsten Kompaktierungen aus dem Kopfblock fallen.
Wie lässt sich verhindern, dass ein neues Label den Pi wieder lahmlegt?
Mit drei Sicherungen, die an verschiedenen Stellen greifen. Keine davon ersetzt die Frage aus dem Artikel vor jedem neuen Label, aber zusammen sorgen sie dafür, dass eine übersehene Antwort einen Job kostet und nicht die Maschine.
sample_limitje Job. Liefert ein Ziel nach denmetric_relabel_configsmehr Messwerte als erlaubt, verwirft Prometheus die ganze Abtastung und setztupfür dieses Ziel auf 0. Aus einem schleichenden Speichertod wird so ein sichtbar ausgefallenes Ziel, und die übrigen Jobs laufen weiter. Einen Anhaltspunkt für den Grenzwert liefertscrape_samples_post_metric_relabeling, das Prometheus für jedes Ziel selbst aufzeichnet; der Grenzwert gehört mit reichlich Abstand über den heutigen Wert.- Eine Warnregel auf das Wachstum. Die Abfrage
delta(prometheus_tsdb_head_series[1h])aus dem Artikel, mit einer Schwelle versehen, meldet ein Leck, bevor der Speicher knapp wird. - Eine Speichergrenze für den Container. Läuft Prometheus in Docker, beendet der Kern bei Erreichen der Grenze nur Prometheus und keinen beliebigen anderen Prozess auf dem Pi. Unter Raspberry Pi OS setzt das die eingeschaltete Speicher-Steuergruppe voraus.
Quellen
Passend dazu