English
 Deutsch
GA4-Measurement-Protocol-Nutzlasten: Jedes Feld, jede Grenze und warum der Endpunkt auf kaputtes JSON mit 204 antwortet

Inhalt
- Was der Endpunkt antwortet
- Wohin die Nutzlast wirklich gehört
- Die Kennungsfelder
- Die zwei Parameter, an denen hängt, ob die Berichte aufgehen
- Das Ereignis und sein Name
- Parameter und die Grenzen, die für sie gelten
- Wo die beiden Höchstwerte aneinandergeraten
- Zeit und die drei Arten, sie falsch zu setzen
- consent und die Schlüssel, die nicht hierhergehören
- validation_behavior und warum der Betrieb es nicht setzen sollte
- Wie sich ein Fehler überhaupt finden lässt
- Was das Protokoll jetzt ist
- Fragen und Antworten
- Quellen
Eine Measurement-Protocol-Anfrage ist ein einziger HTTPS-POST: eine Abfragezeichenfolge mit zwei Zugangsdaten und ein JSON-Rumpf mit den Ereignissen. So kommen Daten in eine GA4-Property, die nicht aus einem Browser stammen — Offline-Conversions aus einem CRM, eine per Webhook bestätigte Zahlung, ein App-Backend, das Nachreichen von Treffern, die ein Werbeblocker verschluckt hat.
Es ist zugleich der einzige Einlieferungsweg im ganzen Aufbau, der nie sagt, ob er funktioniert hat.
Was der Endpunkt antwortet
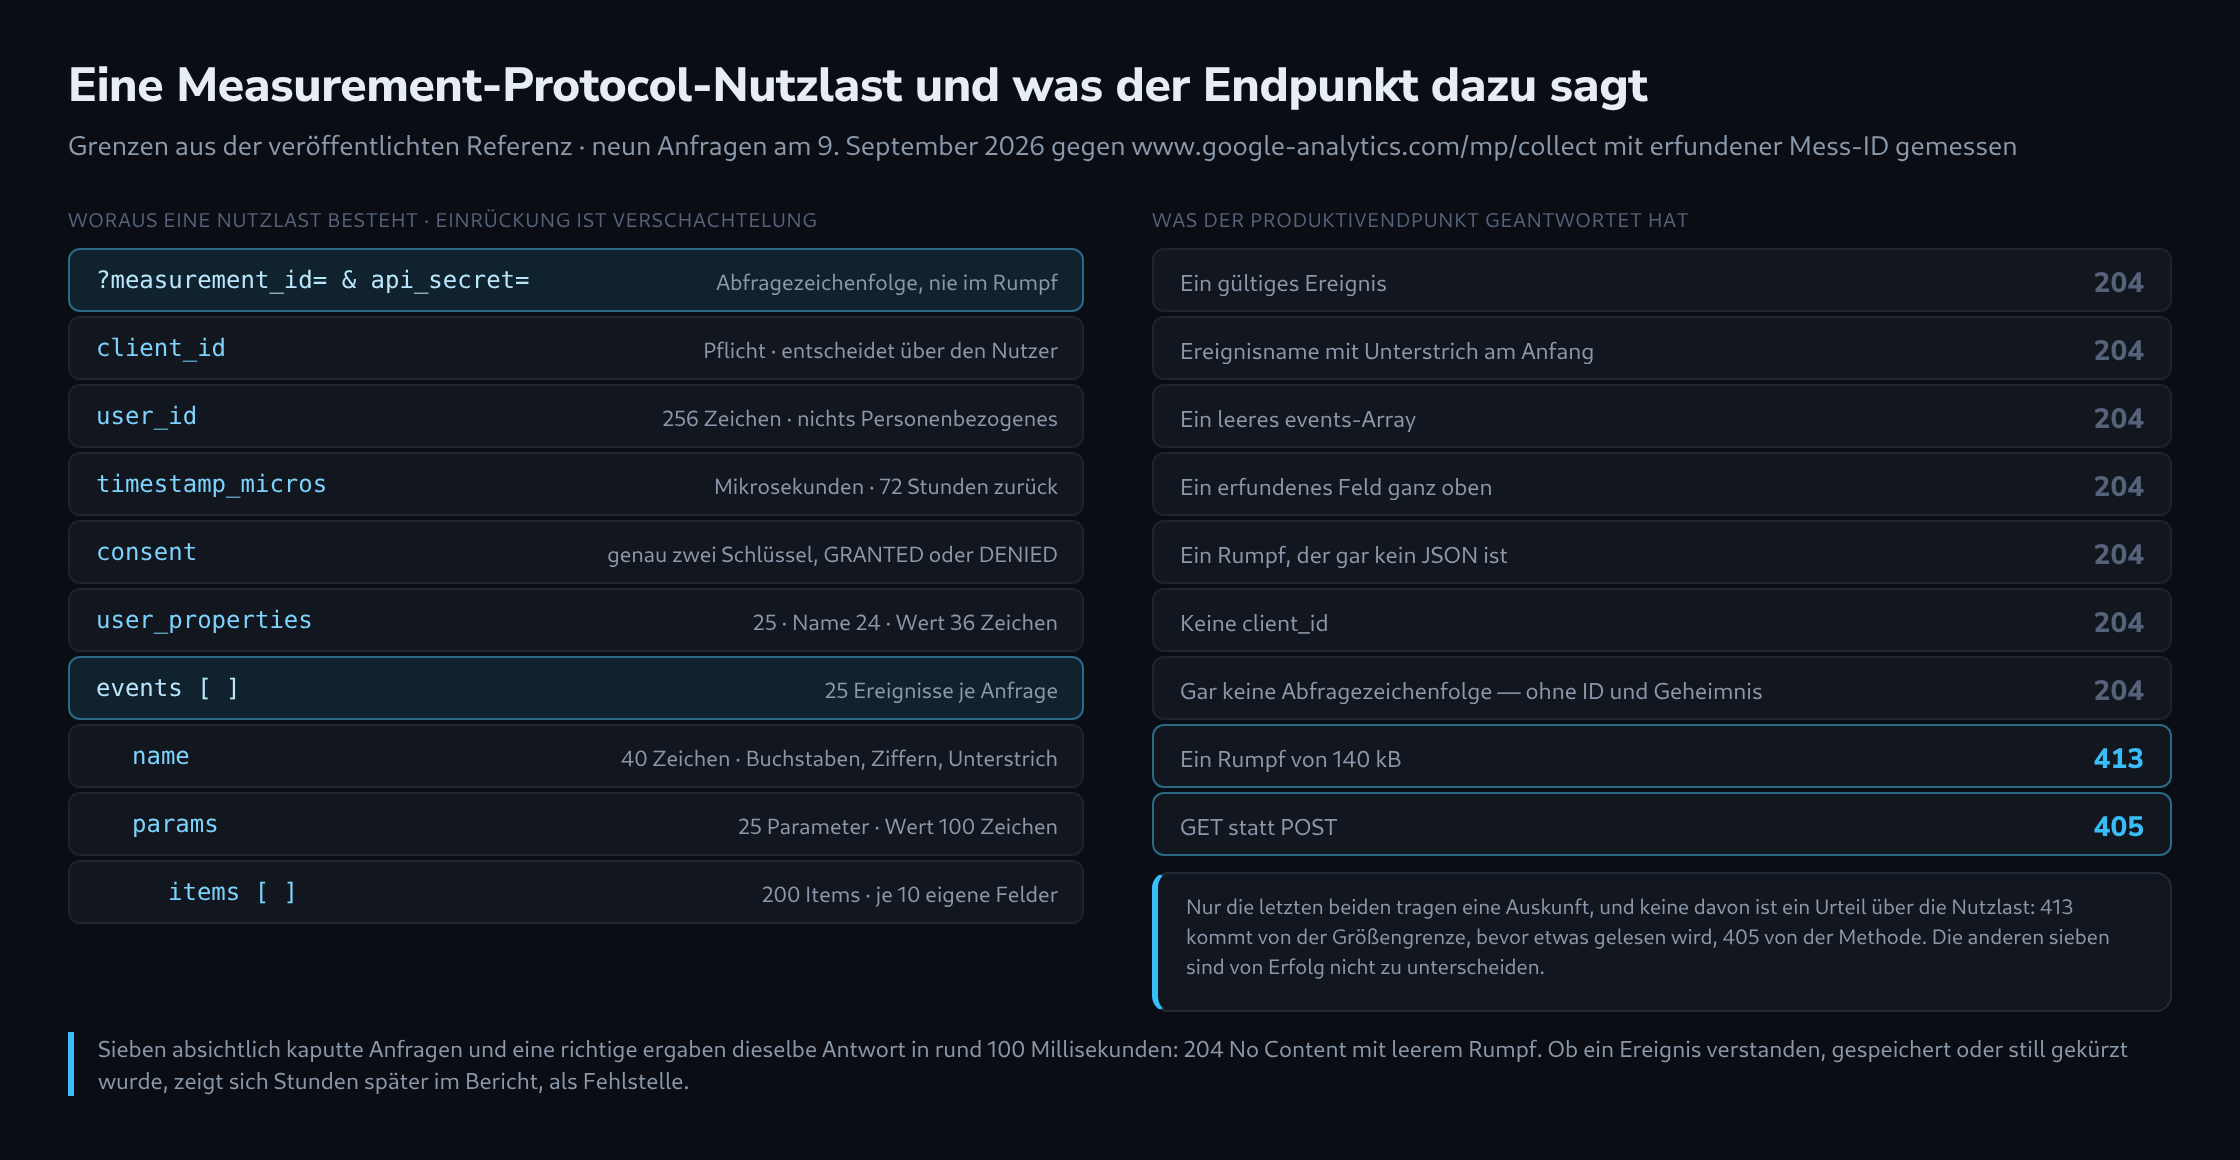
Neun Anfragen gingen am 9. September 2026 an https://www.google-analytics.com/mp/collect, alle mit einer erfundenen Mess-ID, damit nirgends etwas erfasst werden konnte. Sieben davon waren absichtlich kaputt.
Acht der neun kamen als 204 No Content zurück, in rund 100 Millisekunden und mit leerem Rumpf. Nicht nur die gültige: auch das Ereignis, dessen Name mit einem Unterstrich beginnt, das leere events-Array, die Nutzlast mit einem erfundenen Feld ganz oben, die Anfrage ohne client_id und ein Rumpf, der überhaupt kein JSON war. Eine Anfrage ganz ohne Abfragezeichenfolge — ohne Mess-ID, ohne API-Geheimnis — kam ebenfalls mit 204 zurück.
Genau zwei Dinge erzeugten einen HTTP-Fehler, und keines davon ist ein Urteil über die Nutzlast. Ein Rumpf von 140 kB wurde mit 413 und einer HTML-Fehlerseite des Vorbaus abgelehnt, weil er die dokumentierte Grenze von 130 kB überschritt, bevor überhaupt etwas gelesen wurde. Ein GET wurde mit 405 abgelehnt.
Der europäische Endpunkt region1.google-analytics.com verhält sich gleich. Über je fünf Läufe lag die Umlaufzeit vom selben Server bei beiden Hosts im Mittel bei 90 Millisekunden.
Der Antwortcode bestätigt also nur, dass die Anfrage angekommen ist. Ob das Ereignis verstanden und gespeichert wurde oder ein Parameter verloren ging, lässt sich daraus nicht erkennen. Beim Senden bleiben diese Probleme unsichtbar; erst Stunden später fallen sie als fehlende Daten im Bericht auf.
Wohin die Nutzlast wirklich gehört
Zwei Teile, und die Verwechslung liegt nahe.
Die Abfragezeichenfolge trägt die Zugangsdaten: measurement_id für einen Web-Datenstrom (oder firebase_app_id für einen App-Datenstrom) und api_secret, das je Datenstrom in der GA4-Verwaltung angelegt wird. Keines von beiden gehört ins JSON. Dort werden sie zu unbekannten Feldern, und ein unbekanntes Feld wird nicht übergangen — es macht die gesamte Nutzlast unlesbar.
Der Rumpf ist ein JSON-Objekt mit einem festen Satz erlaubter Schlüssel:
{
  "client_id": "1234567890.1700000000",
  "user_id": "crm-88213",
  "timestamp_micros": 1788000000000000,
  "consent": { "ad_user_data": "GRANTED", "ad_personalization": "DENIED" },
  "user_properties": { "kundenstufe": { "value": "gold" } },
  "events": [
    {
      "name": "purchase",
      "params": {
        "transaction_id": "T-8891",
        "currency": "EUR",
        "value": 20,
        "session_id": "1700000000",
        "engagement_time_msec": 100,
        "items": [
          { "item_id": "A-1", "item_name": "Hemd", "price": 10, "quantity": 2 }
        ]
      }
    }
  ]
}
Daneben erlaubt die Referenz user_data, user_location, ip_override, device, user_agent, non_personalized_ads und validation_behavior. Das ist die vollständige Liste. Alles andere — ein aus einem dataLayer-Objekt mitkopierter event-Schlüssel, eine ecommerce-Hülle, eine Notiz für die Kollegin — kostet die ganze Anfrage.
Die Kennungsfelder
client_id ist auf einem Web-Datenstrom Pflicht und das eine Feld, das entscheidet, ob ein Ereignis zu einem vorhandenen Nutzer stößt oder einen neuen erfindet. Die empfohlene Form sind zwei positive Zahlen, durch einen Punkt verbunden — genau das, was gtag('get') herausgibt und was die eingebaute Variable Analytics Client ID im Google Tag Manager liefert. Der volle Wert des _ga-Cookies, GA1.1.1234567890.1700000000, wird ebenfalls angenommen; die beiden Zahlen stecken darin.
Ein auf dem Server erfundener Wert wird auch angenommen, und das ist der teure Fehler. Eine frische Kennung je Anfrage erzeugt jedes Mal einen frischen Nutzer und eine frische Sitzung — eine Property, die belebt aussieht und ausschließlich aus Sitzungen mit je einem Ereignis besteht.
App-Datenströme nutzen stattdessen app_instance_id: 32 hexadezimale Zeichen aus dem Firebase-SDK, keine client_id unter anderem Namen. Beides zu senden schadet nicht und nützt nicht; das Feld der jeweils anderen Datenstromart wird übergangen.
user_id ist freiwillig, bis zu 256 Zeichen lang und muss eine Zeichenkette sein. Es ist ein Verknüpfungsschlüssel, keine Person: Eine Mailadresse oder eine Telefonnummer in diesem Feld ist ein personenbezogenes Datum, was die Nutzungsbedingungen von Google Analytics verbieten und was als Grund für die Löschung einer Property genügt. Dasselbe gilt für jeden Ereignisparameter und jede Nutzereigenschaft.
Die zwei Parameter, an denen hängt, ob die Berichte aufgehen
Ein Ereignis ohne session_id gehört zu keiner Sitzung. Gespeichert und zählbar ist es trotzdem, aber Sitzungen, engagierte Sitzungen und die sitzungsbezogenen Dimensionen gehen nicht auf, und in der Echtzeit fehlt das Ereignis unter Umständen ganz.
Ein Ereignis ohne engagement_time_msec trägt nichts zur durchschnittlichen Interaktionsdauer bei, die für den so eingelieferten Verkehr dann bei null steht.
Beides ist nicht Pflicht, beides erzeugt nirgends eine Warnung, und beides ist die übliche Antwort auf „die Ereignisse kommen an, aber der Bericht stimmt nicht”. session_id muss eine positive Ganzzahl sein — im Regelfall ein Zeitstempel — und darf als Zahl oder als Ziffernkette gesendet werden. Buchstaben darin werden abgelehnt.
Das Ereignis und sein Name
Ein Ereignis ist ein Objekt mit genau zwei erlaubten Schlüsseln, name und params. Ein Zeitstempel, der als dritter Schlüssel danebengesetzt wird, macht die Nutzlast kaputt; der Zeitstempel je Ereignis gehört als timestamp_micros in die params.
Namen müssen mit einem Buchstaben beginnen und dürfen nur Buchstaben, Ziffern und Unterstriche enthalten. Bindestriche, Punkte und Leerzeichen werden rundweg abgelehnt. Namen unterscheiden Groß- und Kleinschreibung, und das ist der stille Fall: Purchase wird angenommen, wird gespeichert und ist ein anderes Ereignis als purchase — in den E-Commerce-Berichten taucht es nie auf, weil die am kleingeschriebenen Namen hängen.
Einunddreißig Namen behält Google für sich, darunter session_start, first_visit, user_engagement, app_remove und error. Drei weitere — screen_view, ad_impression und in_app_purchase — gibt es, sind aber nur auf App-Datenströmen erlaubt. Auf einem Web-Datenstrom werden sie schlicht nicht erfasst, und niemand sagt das irgendwo.
Parameter und die Grenzen, die für sie gelten
Alle Grenzen des Protokolls an einer Stelle:
| Was | Grenze |
|---|---|
| JSON-Rumpf | unter 130 kB |
| Ereignisse je Anfrage | 25 |
| Ereignisname | 40 Zeichen |
| Parameter je Ereignis | 25 |
| Parametername | 40 Zeichen |
| Parameterwert | 100 Zeichen, 500 bei einer Analytics-360-Property |
| Nutzereigenschaften je Anfrage | 25 |
| Name einer Nutzereigenschaft | 24 Zeichen |
| Wert einer Nutzereigenschaft | 36 Zeichen |
user_id |
256 Zeichen |
| Items je Ereignis | 200 |
| Eigene Parameter je Item | 10 |
| Rückdatierung | 72 Stunden |
Parameternamen dürfen nicht mit _, firebase_, ga_, google_ oder gtag. beginnen, und firebase_conversion ist rundweg reserviert. Für Namen von Nutzereigenschaften gelten dieselben Präfixregeln und zusätzlich fünf reservierte Namen, von denen user_id derjenige ist, zu dem versehentlich gegriffen wird — die Nutzerkennung gehört ganz nach oben, nicht in user_properties.
Nur items darf ein Array sein. Jeder andere Parameter nimmt einen Einzelwert; ein verschachteltes Objekt fällt weg, und im Bericht erscheint der Parameter als fehlend statt als falsch.
Wo die beiden Höchstwerte aneinandergeraten
Fünfundzwanzig Ereignisse je Anfrage und zweihundert Items je Ereignis sind beide dokumentiert, und beide zusammen gehen nicht. Gemessen an erzeugten Nutzlasten mit realistischen Item-Feldern — Kennung, Name, Marke, Kategorie, Variante, Preis, Menge:
- Ein
purchasemit einem Item, samt consent und Nutzereigenschaften, ist 558 Byte groß. - Fünfundzwanzig solcher Ereignisse ergeben rund 14 kB und damit 10,7 % der Grenze.
- Fünfundzwanzig Ereignisse mit je 29 Items überschreiten 130 kB. Bei 28 Items sind es noch 126 kB.
- Fünfundzwanzig Ereignisse mit den erlaubten 200 Items wären 879 kB — das 6,8-Fache der Grenze.
Ein einzelnes Ereignis mit 200 Items ist 35 kB groß und passt bequem. Für gewöhnlichen Verkehr bindet also die Ereigniszahl, und sobald die Warenkörbe lang werden, übernimmt die Größengrenze. Der Übergang liegt bei rund 29 Items je Ereignis, und es ist die einzige Grenze, die mit einem HTTP-Fehler statt mit Schweigen antwortet.
Zeit und die drei Arten, sie falsch zu setzen
timestamp_micros ist ein Unix-Zeitstempel in Mikrosekunden. Fehlt er, wird das Ereignis beim Eintreffen gestempelt, was für alles Gegenwärtige richtig und für alles Nachgereichte falsch ist.
Die Einheit ist die Falle. time() in PHP und time.time() in Python liefern Sekunden, Date.now() in JavaScript liefert Millisekunden. Beides wird als Zahl angenommen, und beides legt das Ereignis irgendwo ins Jahr 1970. Der Prüfserver von Google meldet das zwar — als „timestamp too far in the past”, eine Meldung, die zur Suche nach einem Rückdatierungsproblem führt, während der wirkliche Fehler ein Faktor von tausend oder einer Million ist.
Das Fenster beträgt 72 Stunden. Älteres wird verworfen, und Ereignisse mit validation_behavior auf ENFORCE_RECOMMENDATIONS werden abgelehnt statt stillschweigend fallengelassen. Ein Zeitstempel in der Zukunft heißt meist, dass eine Uhr nachgeht oder eine Zeitzone doppelt aufgeschlagen wurde.
consent und die Schlüssel, die nicht hierhergehören
Das consent-Objekt nimmt genau zwei Schlüssel, ad_user_data und ad_personalization, jeweils GRANTED oder DENIED. Nicht analytics_storage, nicht ad_storage — das ist der Consent Mode im Browser, ein anderer Mechanismus mit einem anderen Wortschatz.
Einen davon hier einzusetzen ist kein Teilausfall. Ein unbekannter Schlüssel in consent, oder ein anderer Wert als die beiden erlaubten, macht die Nutzlast unlesbar und die ganze Anfrage sinnlos. Ganz weggelassen greift GA4 auf den Einwilligungsstand aus den Browserinteraktionen desselben Clients zurück, was für eine serverseitige Anbindung meist genau das Gewünschte ist.
non_personalized_ads wirkt weiterhin und gilt als veraltet; ad_personalization innerhalb von consent löst es ab.
validation_behavior und warum der Betrieb es nicht setzen sollte
validation_behavior kennt zwei Werte. RELAXED ist die Vorgabe: Fehlerhafte Anfragen werden abgelehnt, aber Parameter über den Grenzen werden übergangen statt gemeldet, und Daten vom falschen Typ können trotzdem durchgehen. ENFORCE_RECOMMENDATIONS lehnt genau das ab.
Die strenge Prüfung gehört in den Test, weil eine Ablehnung dort hilft, Fehler zu finden. Im Betrieb sollte das Feld dagegen fehlen: Eine Ablehnung bedeutet hier verlorene Daten. Mit lockerer Prüfung kommt ein Ereignis mit einem zu langen Parameter ohne diesen Parameter an. Mit strenger Prüfung wird das gesamte Ereignis abgelehnt.
Wie sich ein Fehler überhaupt finden lässt
Weil der Produktivendpunkt nichts sagt, müssen Fehler vor dem Senden gefunden werden. Der Prüfserver von Google nimmt dieselbe Anfrage unter /debug/mp/collect entgegen und antwortet mit einem validationMessages-Array; dorthin gesendete Ereignisse werden nie erfasst.
Bevor Du Dich auf den Prüfserver verlässt, solltest Du zwei Einschränkungen kennen. Er meldet nur den ersten Fund: Bei drei Problemen in einem Ereignis kommt zunächst eine Meldung zurück. Die nächste erscheint erst, wenn der erste Fehler behoben ist. Außerdem prüft er weder measurement_id noch api_secret. Eine Anfrage mit erfundenen Zugangsdaten erhält deshalb dasselbe Ergebnis wie eine mit echten. Das ist dokumentiert und erlaubt die Nutzlastprüfung, ohne ein echtes Geheimnis nach außen zu senden.
Ebenso gehört gekannt, was er gar nicht prüft. Gegen ihn gemessen, mit gesetztem ENFORCE_RECOMMENDATIONS, ging all das kommentarlos durch: dreißig Ereignisse in einer Anfrage, ein leeres events-Array, eine Nutzlast ganz ohne events-Schlüssel, zwei Ereignisse mit demselben Namen, screen_view auf einem Web-Datenstrom und ein purchase ohne value und ohne currency. Ohne validation_behavior — also so, wie der Betrieb denselben Text behandelt — kam auch ein Parameterwert von 120 Zeichen sauber zurück.
Was das Protokoll jetzt ist
Google hat das Measurement Protocol im Juni 2026 in einen abgeschlossenen Zustand versetzt: keine Abkündigung, keine neuen Funktionen. Die Dokumentation empfiehlt für neue Server-zu-Server-Anbindungen jetzt die Data Manager API, mit OAuth statt eines API-Geheimnisses, mehreren Zielen je Anfrage und verschlüsselten Kennungen.
Für eine bestehende Anbindung ist das kein Notfall. Das Measurement Protocol läuft weiter, seine Grenzen gelten weiter, und sein Endpunkt antwortet weiter auf alles mit 204 — was die Prüfung vor dem Senden zu derselben Aufgabe macht, die sie immer war.
Fragen und Antworten
Wie lässt sich im Betrieb erkennen, ob Measurement-Protocol-Ereignisse wirklich ankommen?
Nicht am Antwortcode, der ist fast immer 204. Tragfähig ist eine Kombination aus Prüfung vor dem Senden und Abgleich danach:
- Jede neue oder geänderte Nutzlast geht zuerst an
/debug/mp/collect. Weil der Prüfserver nur den ersten Fund meldet, ist der Durchlauf so lange zu wiederholen, bis keine Meldung mehr kommt. - Was der Prüfserver nicht prüft, prüft der eigene Code: höchstens 25 Ereignisse je Anfrage, ein nicht leeres events-Array, empfohlene Ereignisnamen wie purchase in Kleinschreibung, keine reinen App-Ereignisse auf einem Web-Datenstrom, value und currency bei einem purchase.
- Der Absender protokolliert, was er gesendet hat, etwa je Tag die Zahl der purchase-Ereignisse und ihre transaction_id. Liegt der Bericht einige Stunden später vor, zeigt der Vergleich, ob Ereignisse fehlen.
Nur der dritte Schritt findet auch Verluste im laufenden Betrieb, etwa nach einem ausgetauschten API-Geheimnis oder bei einem Zeitstempel in der falschen Einheit.
Was passiert, wenn das API-Geheimnis in der GA4-Verwaltung gelöscht oder ersetzt wird?
Beim Senden nichts Sichtbares: Der Endpunkt antwortete in der Messung selbst auf eine Anfrage ganz ohne Zugangsdaten mit 204, und der Prüfserver kontrolliert measurement_id und api_secret nicht. Ein Absender mit einem veralteten Geheimnis verliert seine Ereignisse also unbemerkt. Beim Austausch sind deshalb erst alle Absender umzustellen, bevor das alte Geheimnis gelöscht wird.
Wie passen serverseitige Ereignisse zur Einwilligung, die im Browser über den Consent Mode erfasst wird?
Nur über den eigenen Code. Das consent-Objekt des Measurement Protocol kennt allein ad_user_data und ad_personalization; einen Schlüssel für analytics_storage gibt es nicht, und ihn trotzdem zu senden macht die Nutzlast unlesbar. Eine Ablehnung der Analyse lässt sich dem Endpunkt über das consent-Objekt also nicht mitteilen. Die Entscheidung, ob für diesen Client überhaupt ein Ereignis gesendet wird, muss vorher im eigenen System fallen.
Hinzu kommt die Kennung. Ist analytics_storage abgelehnt, setzt das Google-Tag im Browser kein _ga-Cookie, und ein Server, der die client_id daraus liest, findet keine. Eine auf dem Server erfundene Ersatzkennung wäre genau der teure Fehler: ein neuer Nutzer mit einer Sitzung aus einem einzigen Ereignis.
Landet ein Zeitstempel in Millisekunden im Jahr 1970 oder gar nicht in den Berichten?
Gar nicht, weil er das Fenster von 72 Stunden verfehlt. Für den Zeitpunkt aus der Beispielnutzlast liefert Date.now() den Wert 1.788.000.000.000. Als Mikrosekunden gelesen, sind das 1.788.000 Sekunden, rund 20,7 Tage nach dem Beginn der Unix-Zeit, also der 21. Januar 1970. Ein Wert in Sekunden landet knapp eine halbe Stunde nach Mitternacht am 1. Januar 1970. Beides ist älter als 72 Stunden und wird verworfen, während der Produktivendpunkt weiter mit 204 antwortet.
Passend dazu