English
 Deutsch
 Polski
Frei zugängliche LLMs im Vergleich: Qwen, Gemma, Ministral, Llama und DeepSeek für DE, EN und PL

Inhalt
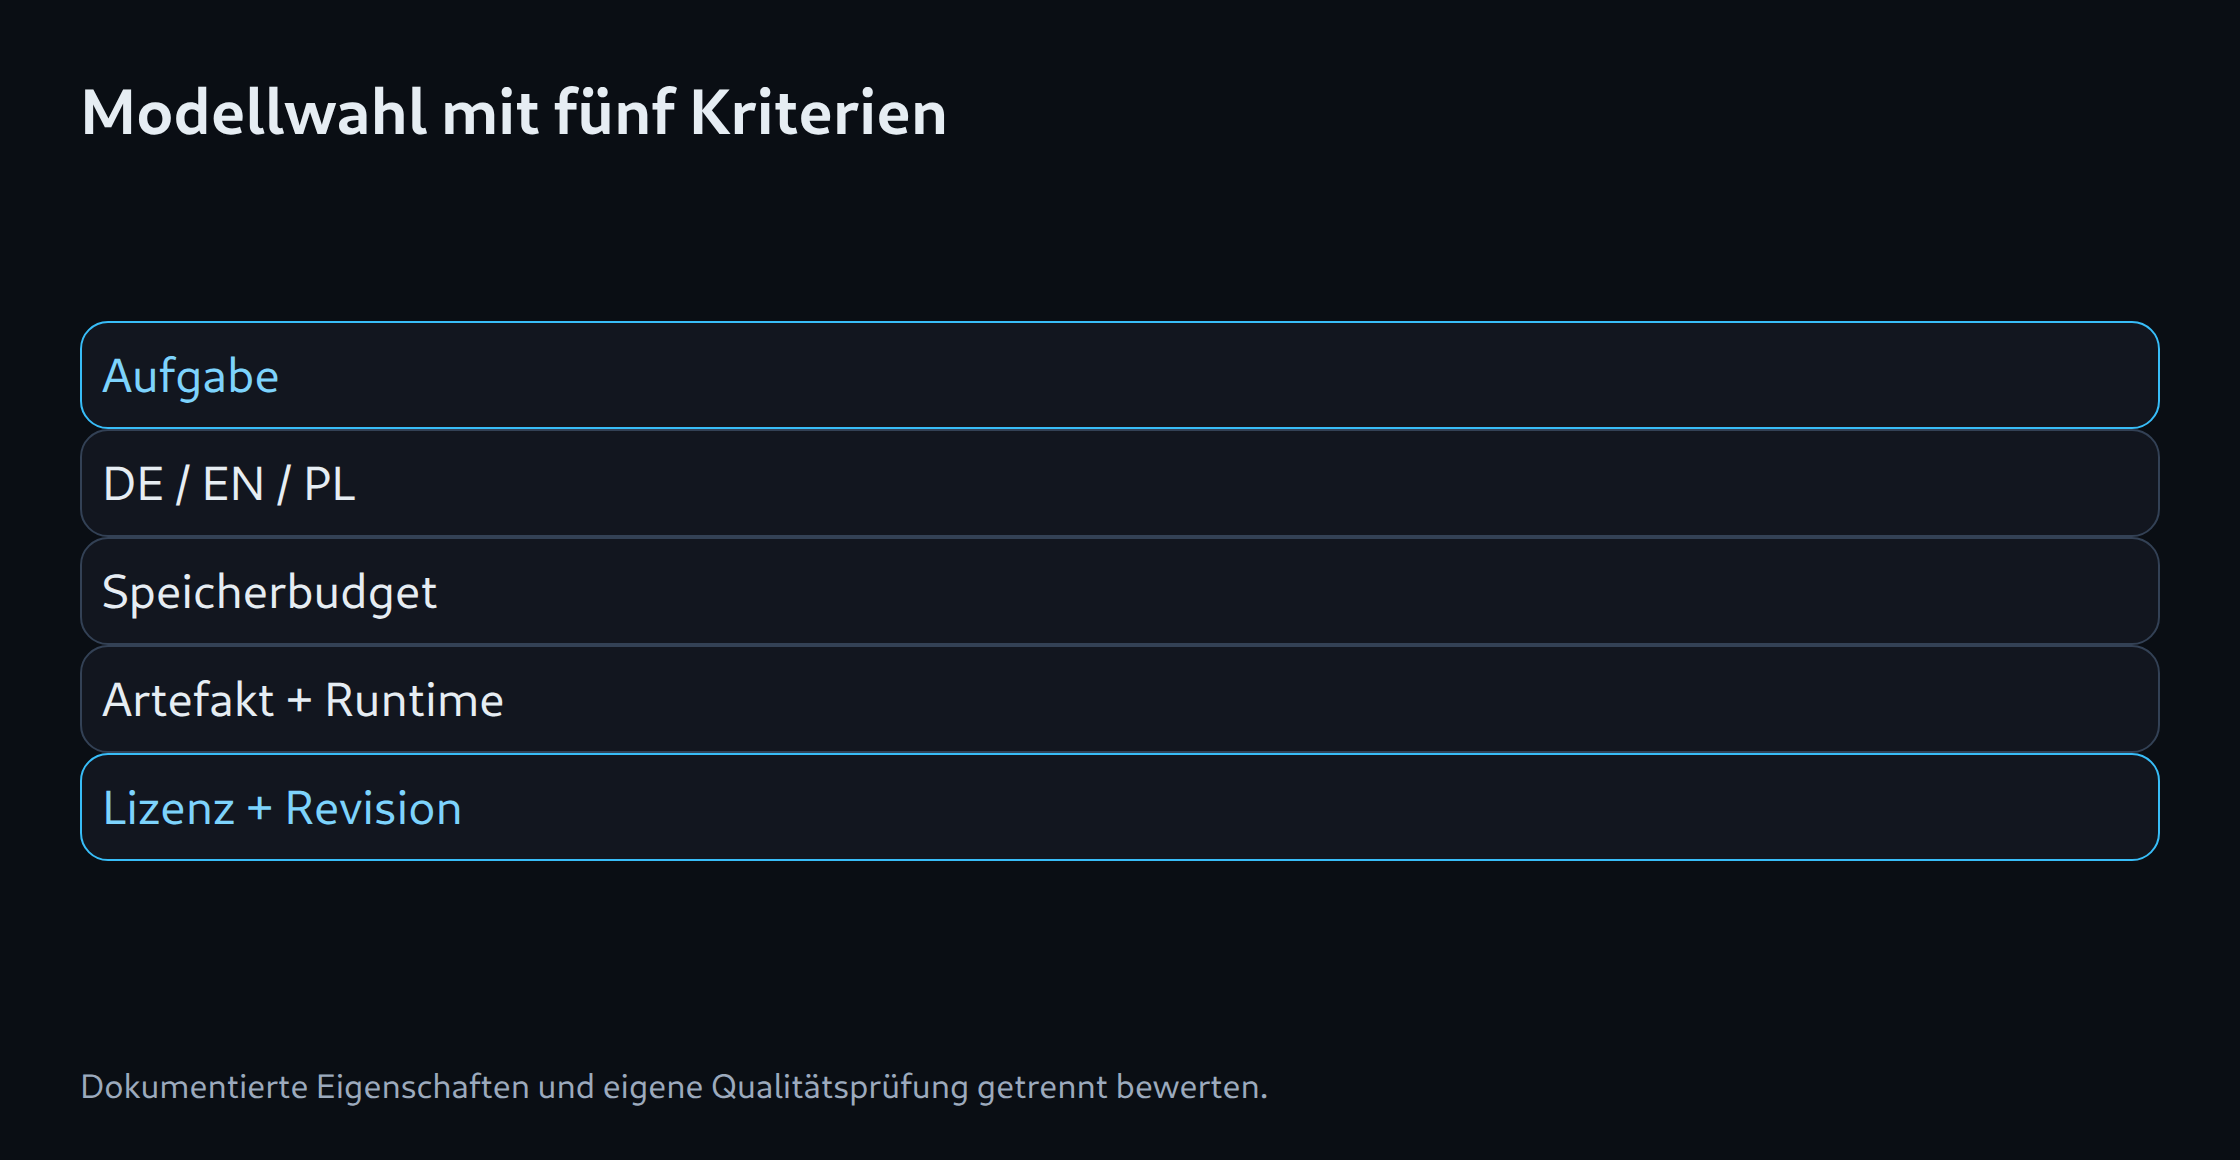
Ein frei zugängliches Sprachmodell ist erst dann eine brauchbare lokale Lösung, wenn Aufgabe, Sprache und Hardware zusammenpassen. Ein hoher allgemeiner Benchmarkwert beantwortet weder die Frage nach polnischer Textqualität noch nach dem Speicherbedarf einer konkreten Quantisierung. Deshalb braucht der Vergleich mehrere Achsen statt einer einzigen Bestenliste.
Die folgende Auswahl umfasst dokumentierte Modellfamilien und konkrete Vergleichskandidaten. Die Einordnung ist kein eigener Qualitätsbenchmark. Downloadzugang, Lizenz und technische Ausführbarkeit werden getrennt betrachtet.
Welche Kandidaten in welche Klasse gehören
| Kandidat | Sinnvoller Vergleich | Besondere Prüfung |
|---|---|---|
| Qwen3.5-9B | Kompakter allgemeiner Assistent | Hybride Architektur und Backend |
| Gemma 4 Instruct | Passende Größenklasse und Multimodalität | Exakte Variante statt Familienname |
| Ministral 3 8B/14B | Lokaler Chat und strukturierte Ausgabe | Artefaktpräzision und Sprachtest |
| Llama 3.3 70B Instruct | Größere Modellreferenz | Gewichte, Kontext und Lizenz |
| DeepSeek-R1-Distill | Reasoning in passender Größenklasse | Basismodell und Ausgabeaufwand |
Frei zugänglich ist eine unvollständige Beschreibung
Ein Modell kann herunterladbare Gewichte besitzen und trotzdem besondere Nutzungsbedingungen verlangen. Die konkrete Model Card und die mitgelieferte Lizenz sind maßgeblich. Bei Ableitungen kommen Bedingungen des Ausgangsmodells hinzu. Ein Repository-Name allein reicht für die Einordnung nicht.
Qwen3.5-9B und der ausgewählte Ministral-3-14B-Instruct-Eintrag weisen Apache 2.0 aus. Andere Familien und ältere Generationen dürfen daraus keine pauschale Lizenzzuordnung erhalten. Außerdem unterscheiden sich Basis-, Instruct- und Reasoning-Versionen selbst bei ähnlichem Namen.
DE, EN und PL brauchen eigene Ergebnisse
Ein brauchbares Aufgabenpaket umfasst Zusammenfassung, Textkorrektur, JSON-Extraktion, Codeanalyse und Antworten zu einem bereitgestellten Dokument. Dieselben Inhalte werden idiomatisch in drei Sprachen gestellt. Die Bewertung zählt fachliche Fehler, Auslassungen, Formatverletzungen und unnötige Ergänzungen.
Ein übersetzter englischer Benchmark ersetzt dabei keinen polnischen Sprachtest. Auch eine Herstellerliste unterstützter Sprachen belegt keine gleiche Qualität. Gerade Eigennamen, Flexion und sachlicher Stil können im Polnischen andere Fehlerbilder erzeugen. Solche Unterschiede gehören in separate Ergebnisspalten.
Modellgröße und Speicherbudget getrennt vergleichen
Eine erste Vergleichsgruppe hält die Modellklasse ähnlich. Eine zweite Gruppe hält das verfügbare Speicherbudget fest. So lässt sich prüfen, ob ein kleineres Modell mit höherer Präzision oder ein größeres stärker quantisiertes Modell für die konkrete Aufgabe besser passt.
Bei MoE-Modellen bestimmen aktive Parameter nur einen Teil der Rechnung. Die gesamten Gewichte bleiben für die Kapazität relevant. Llama 4 Scout und große aktuelle DeepSeek-Modelle sind deshalb keine kleinen Desktop-Modelle allein wegen einer niedriger klingenden Zahl aktiver Parameter. Auslagerung verändert zusätzlich das Antwortverhalten.
Eine reproduzierbare Auswahl statt eines Familien-Siegers
Jeder Ergebnisdatensatz braucht Modell-ID, Revision, Quantisierung, Runtime, Kontext, Chat-Template und Sampling. Reasoning-Ausgaben erhalten ein dokumentiertes Ausgabelimit. Andernfalls misst ein Zeitvergleich womöglich nur längere Antworten. Bildverarbeitung wird separat geprüft, damit ein Textvergleich nicht verschiedene Fähigkeiten vermischt.
Für die Vorauswahl hilft der vorhandene Speicherrechner. Der nächste Schritt ist ein kleiner lokaler Qualitätstest mit überprüfbaren Sollantworten. Erst danach entsteht eine begründete Shortlist für DE, EN oder PL. Eine allgemeine Rangfolge aller frei zugänglichen Modelle wäre für diese Entscheidung zu grob.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Bedeutet frei zugänglich automatisch uneingeschränkte Nutzung?
Downloadzugang und Nutzungsbedingungen sind getrennte Eigenschaften. Maßgeblich sind Lizenz und Bedingungen des konkreten Modells beziehungsweise der konkreten Ableitung.
Ist das Modell mit den meisten Parametern automatisch das beste für Polnisch?
Parameterzahl und allgemeine Benchmarks ersetzen keinen polnischen Aufgabentest. Sprachqualität, Fehlerquote und Rechenbudget müssen zusammen bewertet werden. Auch Quantisierung und Chat-Template können das Ergebnis beeinflussen.
Quellen
- Qwen: Qwen3.5-9B, offizielle Model Card
- Google DeepMind: Gemma 4
- Google: Gemma 4 31B, offizielle Model Card
- Mistral: Ministral 3 14B Instruct, offizielle Model Card
- Meta: Llama 3.3 70B Instruct, offizielle Model Card
- Meta: Llama 4 Scout, offizielle Model Card
- DeepSeek: R1 und Distill-Modelle
Quellen geprüft: 5. Oktober 2026.
Passend dazu