English
 Deutsch
 Polski
Ollama, LM Studio, llama.cpp oder vLLM: Welche Software passt zu lokalen LLMs?

Inhalt
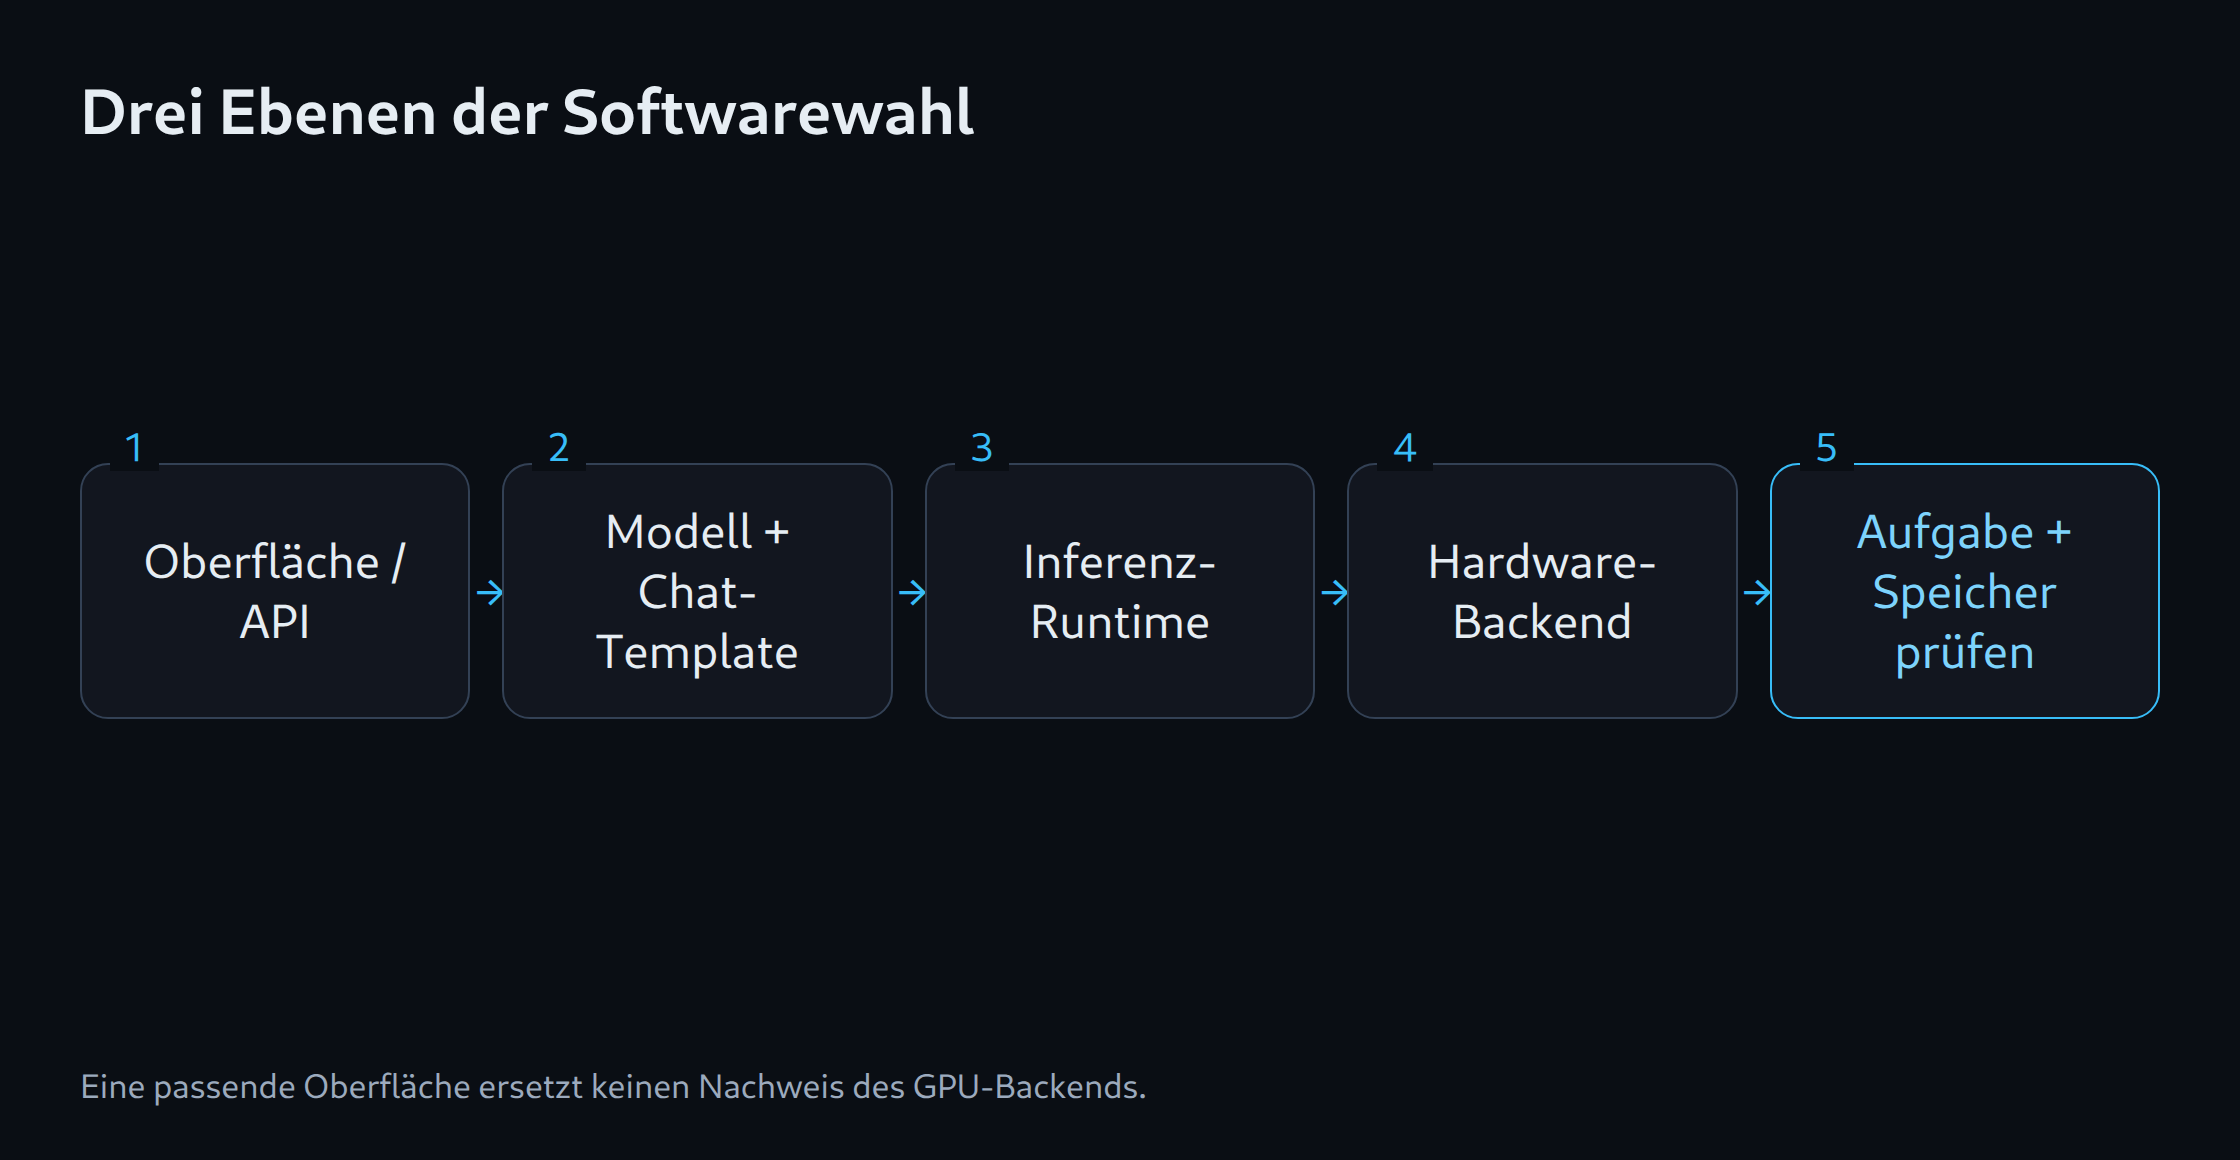
Die Softwarewahl für ein lokales LLM beginnt mit der Aufgabe. Ein privater Desktop-Chat, eine API für ein Skript und ein Dienst für mehrere gleichzeitige Anfragen brauchen unterschiedliche Eigenschaften. Die verbreiteten Produkte sitzen außerdem auf verschiedenen Ebenen: Oberfläche, Modellverwaltung und Inferenz-Engine sind keine austauschbaren Begriffe.
Der folgende Vergleich ordnet die dokumentierten Funktionen ein. Eigene Geschwindigkeitsmessungen liegen nicht zugrunde. Versionsstand, Modellarchitektur und Hardware bleiben Teil jeder konkreten Auswahl.
Sechs Wege mit unterschiedlichen Schwerpunkten
| Software | Stärke im Einsatz | Vor dem Start prüfen |
|---|---|---|
| Ollama | Modellverwaltung und lokale API | Backend, Modelltag und Kontext |
| LM Studio | Desktop-Oberfläche und Modellwahl | Runtime, Format und GPU-Auslagerung |
| llama.cpp | Direkte Kontrolle, GGUF, viele Backends | Build und unterstützte Architektur |
| MLX LM | Apple-Silicon-Ausführung | MLX-Artefakt und Speicherreserve |
| vLLM | API-Serving und Parallelität | OS, GPU und Quantisierungskernel |
| OpenVINO GenAI | Eigener optimierter Inferenzpfad | Modellkonvertierung und Zielgerät |
Desktop und API getrennt auswählen
LM Studio passt zu einem grafischen Einstieg. Ollama eignet sich für einen überschaubaren Dienst mit Modellverwaltung und API. Eine zusätzliche Chat-Oberfläche verändert die darunterliegende Runtime nicht automatisch. Ein komfortabler Chat ist deshalb kein Beleg für hohe Serverleistung.
llama.cpp bietet direkten Zugriff auf Modellparameter und Hardware-Backends. Der zusätzliche Kontrollbedarf lohnt sich bei reproduzierbaren Konfigurationen oder ungewöhnlicher Hardware. Der Projektname beschreibt dabei eine Runtime, keine Beschränkung auf die Modellfamilie Llama.
Das Backend entscheidet über Hardware
CUDA, Metal, Vulkan, SYCL und XPU sind unterschiedliche Ausführungspfade. Eine NVIDIA-Anleitung lässt sich nicht unverändert auf Intel Arc übertragen. Ollama dokumentiert zusätzliche Vulkan-Unterstützung unter Windows und Linux; vorhandener Treiber, installiertes Backend und tatsächliche Geräteerkennung müssen zusammenpassen.
Auf Apple Silicon sind MLX LM sowie geeignete Metal-Pfade naheliegende Kandidaten. Eine MLX-Quantisierung und eine GGUF-Datei sind dennoch verschiedene Artefakte. Ein Backend-Wechsel braucht eine Prüfung von Modellrevision, Tokenizer und Chat-Template, sonst erklärt eine geänderte Ausgabe möglicherweise nur eine andere Konfiguration.
vLLM für den passenden Serverfall
vLLM richtet den Fokus auf Serving. Die GPU-Installation dokumentiert Linux; unter Windows kommt unter anderem WSL infrage. Native Windows-Bedienbarkeit anderer Produkte ist damit kein gleichwertiger Installationsweg. Eine unterstützte GPU garantiert außerdem nicht jeden Quantisierungskernel.
Für eine Sitzung zählen First-Token-Zeit und flüssige Ausgabe. Für mehrere Sitzungen kommen Gesamtdurchsatz, Warteschlangen und Antwortlatenzen unter Last hinzu. Ein schneller Einzeltest entscheidet den Mehrbenutzervergleich nicht. SGLang ist ein zusätzlicher Serving-Kandidat, dessen aktuelle Modellunterstützung separat zu prüfen bleibt.
Ein belastbarer Auswahlweg
Zuerst stehen Betriebssystem, vorhandene Hardware und gewünschtes Modell fest. Danach folgen benötigte Funktionen: strukturierte Ausgabe, Tool Calling, Bildverarbeitung oder Offline-Nutzung. Schließlich wird ein gemeinsames Aufgabenpaket mit dokumentierter Revision, Kontext und Sampling ausgeführt.
Ein kleiner Desktop-Assistent braucht keinen komplexen Serving-Stack allein aus Vorsicht. Ein API-Dienst braucht dagegen nachvollziehbare Startkonfigurationen, Fehlerprotokolle und Lastgrenzen. Der vorhandene Speicherrechner hilft bei der Modellpassung; die endgültige Softwarewahl folgt dem nachgewiesenen Backend und dem tatsächlichen Einsatz.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Sind Ollama und llama.cpp austauschbar?
Ollama ergänzt die Ausführung um Modellverwaltung und eine eigene API. llama.cpp bietet direkten Zugriff auf Runtime und Backends. Modellformat, Chat-Template und unterstützte Funktionen entscheiden über einen Wechsel.
Ist vLLM für einen einzelnen Desktop-Chat nötig?
Eine einzelne Sitzung rechtfertigt den zusätzlichen Serving-Aufwand nicht automatisch. Die Auswahl hängt von Betriebssystem, Hardware, Modell und benötigten API-Funktionen ab. Ein Durchsatzvorteil bei vielen Anfragen ersetzt keinen Vergleich der Bedienbarkeit.
Quellen
- Ollama: Hardware support
- LM Studio: Dokumentation
- llama.cpp: Projekt und Backends
- vLLM: GPU installation
- MLX LM: Projekt
- OpenVINO: Generative AI workflow
Quellen geprüft: 5. Oktober 2026.
Passend dazu