Polski
Zakup GPU czy wynajem w chmurze: dostępność oraz koszty uruchomienia i pracy lokalnych modeli LLM

Spis treści
Lokalny LLM to model językowy działający na własnym komputerze. Alternatywą jest wynajem komputera z GPU albo dostęp do gotowego modelu przez interfejs programistyczny. Sama cena karty nie wystarcza do porównania: liczą się też reszta komputera, energia, konfiguracja i rzeczywiście wykonana praca.
Porównywalne dane ofert zakupu
Strona sklepu pokazuje stan z określonej chwili. Przydatne porównanie zapisuje dokładny model karty, pełną cenę i dostępność tego samego dnia. Podlinkowane sklepy są punktem wyjścia do takiej kontroli; artykuł nie podaje obecnie potwierdzonej ceny zakupu.
| Dane | Znaczenie dla porównania |
|---|---|
| Dokładny model | Producent, pojemność pamięci i wariant muszą się zgadzać. |
| Pełna cena | Obejmuje wysyłkę i ewentualne pozostałe opłaty. |
| Dostawa | Stan magazynu i potwierdzony termin to różne informacje. |
| Data kontroli | Zapis daty ma znaczenie, ponieważ oferta może się zmienić. |
Przycisk zamówienia może dotyczyć przedsprzedaży. Informacja o magazynie jest mocniejsza, lecz nie zastępuje potwierdzonego terminu konkretnego zamówienia. Miejsce dostawy, termin płatności i warunki sprzedawcy mogą zmienić datę. Porównanie euro i złotych wymaga tego samego udokumentowanego kursu oraz wszystkich dodatkowych kosztów.
Zakup obejmuje więcej niż koszyk
Pełny koszt zakupu może obejmować zasilacz, obudowę, chłodzenie, płytę główną, RAM i wysyłkę. Używane karty wymagają oceny stanu i testu pod dłuższym obciążeniem. Przeróbka pamięci może zmienić gwarancję i wsparcie; liczą się konkretne warunki. Import może dodać opłaty zależne od zamówienia i kraju docelowego oraz koszt ewentualnego zwrotu. Jeden stały procent ukrywałby te różnice.
Kalkulator pamięci VRAM dla LLM pomaga zaplanować pamięć. Zbyt mała pamięć karty może wymagać pracy części modelu na procesorze, krótszego tekstu wejściowego albo mniejszego modelu. Zmienia to czas oczekiwania lub dostępne zadania, a więc także porównanie kosztów.
Wyraźnie hipotetyczny przykład kosztów
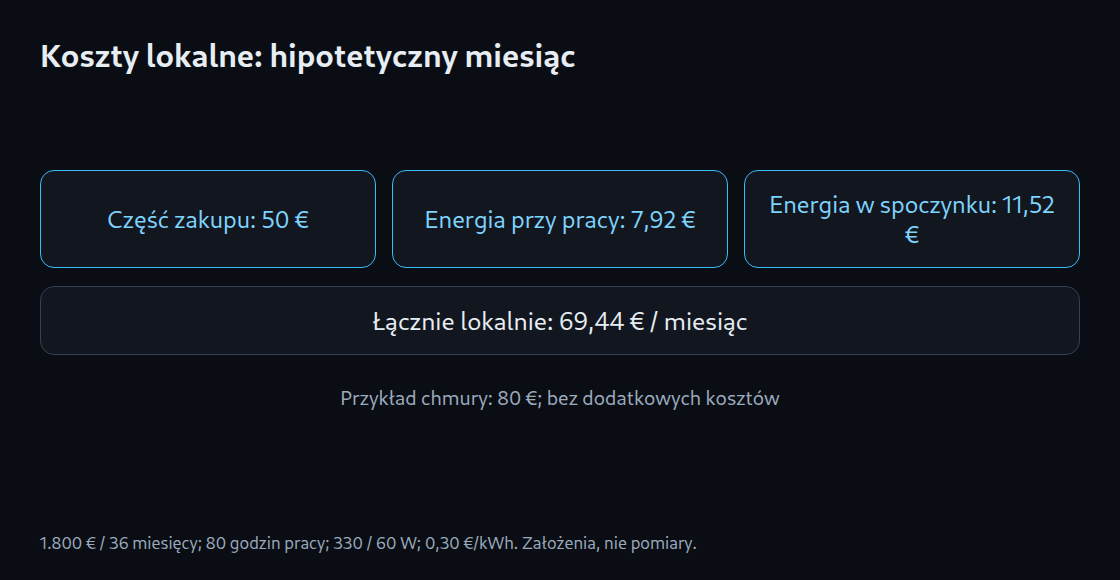
Dowolnie wybrany przykład zakłada 1.800 euro za cały komputer i 36 miesięcy użytkowania. Miesiąc ma tutaj 30 dni, czyli 720 godzin. Model pracuje 80 godzin przy poborze 330 watów całego komputera. Przez pozostałe 640 godzin komputer jest włączony i pobiera 60 watów. Energia kosztuje 0,30 euro za kilowatogodzinę. To założenia, nie pomiary RTX 5090 ani aktualna oferta zakupu.
Podział 1.800 euro przez 36 miesięcy daje 50 euro kosztu zakupu przypisanego do miesiąca. Nie są to raty ani amortyzacja podatkowa: zakup nadal wymaga 1.800 euro. 330 watów to 0,330 kilowata. Przez 80 godzin powstaje 0,330 × 80 = 26,4 kilowatogodziny, czyli 7,92 euro. Pozostałe 640 godzin kosztuje 0,060 × 640 × 0,30 = 11,52 euro. Razem daje to 69,44 euro miesięcznie. Prosty przykład pomija utrzymanie, finansowanie, podatki i możliwą cenę późniejszej odsprzedaży.
Godziny GPU i tokeny API wymagają osobnych modeli
Wymyślona stawka 1 euro za rozliczaną godzinę GPU daje 80 euro za 80 godzin. To nie jest oferta RunPod. Liczby można porównać tylko wtedy, gdy obie opcje wykonują w tym czasie tę samą przydatną pracę. Konfiguracja, pobieranie danych, oczekiwanie i niewykorzystany czas włączonej maszyny również mogą być płatne. Pamięć masowa może kosztować dodatkowo, także po zatrzymaniu. Opłaty za transfer zależą od dostawcy; RunPod wyraźnie nie nalicza ich dla danych przychodzących i wychodzących z Pods.
Dla stale włączonego komputera podstawa wynosi 50 euro zakupu oraz 12,96 euro za 720 godzin spoczynku. Każda godzina obciążenia zastępuje godzinę spoczynku i dodaje (0,330 − 0,060) × 0,30 = 0,081 euro. Symbol h oznacza liczbę godzin obciążenia. Koszt lokalny to więc 62,96 + 0,081 × h euro, a założony wynajem kosztuje 1 × h euro. Zrównanie wypada przy około 68,5 godziny. Gdyby komputer poza pracą był całkowicie wyłączony i nic nie pobierał, koszt wyniósłby 50 + 0,099 × h euro, a próg około 55,5 godziny. Obie granice obowiązują tylko przy tych założeniach, tej samej wykonanej pracy i bez dodatkowych kosztów.
API to interfejs programistyczny usługi. Dostęp do modeli często rozlicza osobno tokeny wejściowe i wyjściowe; tokeny są fragmentami tekstu, nie stałą liczbą pełnych słów. Wynajem GPU kupuje natomiast czas komputera. Uczciwe porównanie liczy więc pełny koszt tej samej liczby przydatnych zadań, na przykład 100 sprawdzonych streszczeń dokumentów. Liczą się też powtórki po błędach, konfiguracja i oczekiwanie. Równe ceny niewiele mówią, jeśli jedna opcja nie zapewnia wymaganej jakości.
Powiązane narzędzia
Pytania i odpowiedzi
Czy oferta GPU z możliwością zamówienia potwierdza natychmiastową dostępność?
Nie. Zamówienie może dotyczyć przedsprzedaży. Konkretny sprzedawca, aktualny stan magazynu i potwierdzony termin muszą do siebie pasować.
Przy jakim poziomie użycia lokalny model LLM staje się tańszy od chmury?
Przykłady wyznaczają progi tylko dla przyjętych założeń. Rozstrzygają zakup, rzeczywista energia, czas wyłączenia, płatny czas wynajmu i ta sama przydatna praca. Wolniejszy komputer może potrzebować więcej godzin na to samo zadanie.
Źródła
- ALTERNATE: oferty RTX 5090
- Caseking: karty graficzne NVIDIA
- x-kom: Zotac RTX 5090 AMP Extreme Infinity
- Morele: Gigabyte RTX 5090 Gaming OC
- RunPod: Pods pricing
Źródła ponownie sprawdzone: 25 października 2026. Bez aktualnego porównania cen. Wszystkie koszty przykładu są założeniami.
Powiązane artykuły