

 English
 Deutsch
 Polski
Tutorial: Chunk-Größe und Überlappung gegen einen Testsatz prüfen

Management Summary
Eine KI-Dokumentensuche arbeitet mit Textabschnitten, statt für jede Frage zwangsläufig den gesamten Bestand zu lesen. Abschnittsgröße und wiederholter Text zwischen Nachbarn beeinflussen, ob eine passende Erklärung gefunden wird, wie schnell die Suche läuft und welche Kosten entstehen. Der Vergleich verschiedener Aufteilungen anhand typischer Fragen zeigt einen passenden Ausgleich für die vorhandenen Dokumente. Große Abschnitte können Nebensächliches mitliefern, Wiederholungen erhöhen den Aufwand. Ein passender Fund allein garantiert noch keine richtige Antwort.
Inhalt
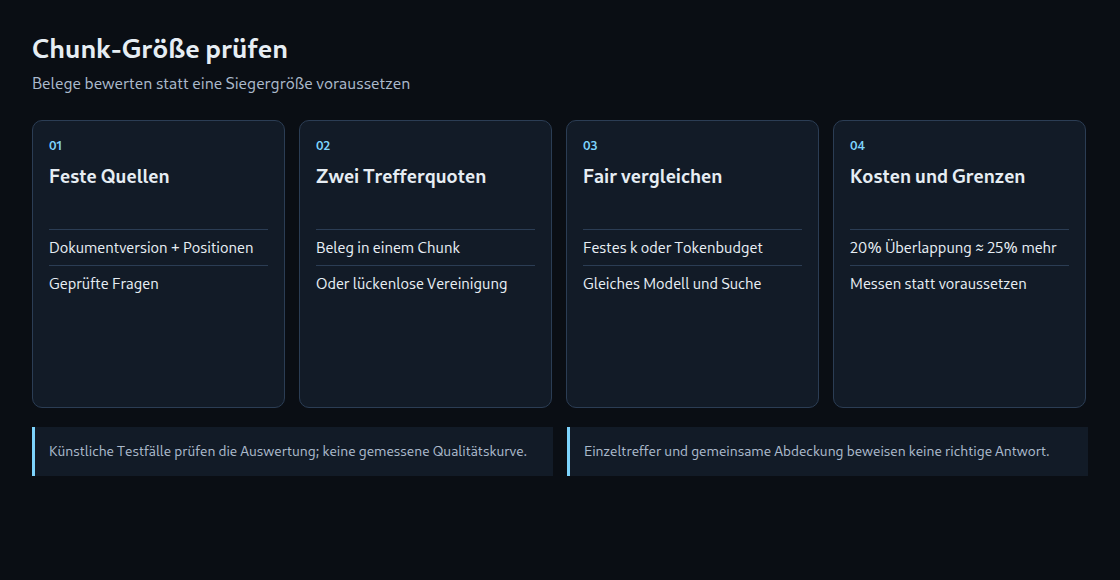
Ein Chunk ist ein Textabschnitt, der als Einheit für die Suche gespeichert wird. Überlappung bedeutet, dass benachbarte Chunks einen Teil desselben Quelltexts wiederholen. Die Chunk-Größe beeinflusst, wie viel brauchbarer Belegtext und wie viel Nebeninformation beim Antwortmodell ankommen. Eine allgemein beste Größe oder Überlappung gibt es nicht. Ein Vergleich braucht feste Quellen, geprüfte Fragen und ein klar definiertes Erfolgskriterium.
Dieses Tutorial bewertet gefundene Belege ohne anschließende Antworterzeugung. Einbettungsmodelle, Indexaufbau und Suche benötigen trotzdem Rechenleistung und können Kosten verursachen. Das Python-Beispiel läuft lokal mit künstlichen Trefferlisten. Es ist eine Auswertung, keine vollständige Einbettungspipeline.
Quellen festhalten und Belege markieren
Jede Frage erhält eine ID, ihren Wortlaut, eine eindeutige Dokumentversions-ID und eine geprüfte Belegstelle. Der Bereich verwendet Python-Zeichenpositionen: einschließlich Start, ausschließlich Ende. Das gespeicherte Zitat muss exakt diesem Ausschnitt der festgehaltenen Quelle entsprechen. Byte-, UTF-16- und Tokenpositionen sind andere Koordinatensysteme.
Die Positionen entstehen nach Textextraktion und Vereinheitlichung, aber vor dem Zerlegen. Jeder Chunk behält Dokumentversions-ID und Quellbereich. Eine Suche nur nach dem Zitat könnte denselben Satz im falschen Dokument oder an der falschen Stelle akzeptieren. Weitere Textveränderungen benötigen eine verlässliche Rückzuordnung zu diesen Positionen.
Künstlich erzeugte Fragen können einen ersten Testsatz ergänzen. Auch die Erzeugung aus ganzen Dokumenten beseitigt die Nähe zum Quellwortlaut nicht. Die Gegenlese prüft Beantwortbarkeit, Beleg, Umformulierung und Aufgabenabdeckung. Echte Anfragen liefern zusätzliche Fälle; Datenschutz und Qualität der Zuordnung bleiben relevant. Nicht beantwortbare Fragen oder Antworten aus mehreren Dokumenten brauchen eigene Regeln. Das folgende Beispiel behandelt je beantwortbarer Frage genau einen zusammenhängenden Belegbereich.
Die Kennzahl vor dem Vergleich festlegen
Single-span hit@k bezeichnet hier den Anteil der Fragen, deren vollständiger Beleg in mindestens einem der ersten k Chunks liegt. Union hit@k akzeptiert auch mehrere Treffer derselben Dokumentversion, sofern deren Bereiche den Beleg lückenlos abdecken. Die zweite Kennzahl erkennt verteilte Belege, beweist aber keine richtige Rekonstruktion durch das Antwortmodell.
Single-span MRR@k mittelt den Kehrwert des Rangs des ersten Chunks mit vollständigem Beleg. Ein Fehltreffer zählt als null. Ein vollständiger Treffer auf Rang 1 trägt 1 bei, auf Rang 2 den Wert 0,5 und auf Rang 4 den Wert 0,25. Das sind ausdrücklich definierte Kennzahlen für dieses Belegschema. Recall beschreibt allgemein den Anteil aller relevanten Einheiten, der gefunden wurde. Ein Treffer auf eine relevante Einheit ist nicht gleichbedeutend mit dem Abruf mehrerer benötigter Belegstellen.
Dreißig oder fünfzig Fragen können für einen ersten Versuch dienen, sind aber keine allgemein ausreichende Stichprobe. Ein geändertes Ergebnis entspricht bei 30 Fragen 3,33 Prozentpunkten, bei 50 Fragen 2 Punkten. Kleine Unterschiede brauchen mehr Belege, Vergleiche je Frage und eine passende Unsicherheitsanalyse. Ein zurückgehaltener Testsatz trennt wiederholtes Abstimmen von unabhängiger Prüfung.
Eine kleine ausführbare Auswertung
Die Datei benötigt nur die Python-Standardbibliothek und läuft mit python3 evaluate.py. Treffer stehen in der Reihenfolge der Suche. Eine leere Liste bedeutet eine abgeschlossene Suche ohne Treffer; eine fehlende Liste ist ein Fehler. Doppelte Bereiche, ungültige Positionen und nicht passende Belegzitate werden abgelehnt.
def evaluate(questions, rankings, corpus, k=5):
    # corpus keys identify immutable document versions.
    if type(k) is not int or k < 1 or not questions:
        raise ValueError("positive k and nonempty questions required")
    def valid_span(s):
        doc, start, end = s
        if (doc not in corpus or type(start) is not int
                or type(end) is not int
                or not 0 <= start < end <= len(corpus[doc])):
            raise ValueError("invalid source span")
        return doc, start, end
    hits, union_hits, reciprocal = 0, 0, 0.0
    seen = set()
    for q in questions:
        if q["id"] in seen:
            raise ValueError("duplicate question id")
        seen.add(q["id"])
        doc, start, end = valid_span(q["evidence"])
        if q["quote"] != corpus[doc][start:end]:
            raise ValueError("quote does not match the source span")
        # A missing result is not silently treated as an empty ranking.
        rows = rankings[q["id"]]
        if len({tuple(c) for c in rows}) != len(rows):
            raise ValueError("duplicate retrieved span")
        rows = [valid_span(c) for c in rows]
        top = rows[:k]
        rank = next((n for n, (d, a, b) in enumerate(top, 1)
                     if d == doc and a <= start and b >= end), None)
        if rank is not None:
            hits += 1
            reciprocal += 1 / rank
        # Union coverage: adjacent intervals may cover a split sentence.
        cursor = start
        spans = sorted((max(a, start), min(b, end)) for d, a, b in top
                       if d == doc and a < end and b > start)
        for a, b in spans:
            if a > cursor:
                break
            cursor = max(cursor, b)
        union_hits += cursor >= end
    n = len(questions)
    return {"single_hit_at_k": hits / n,
            "union_hit_at_k": union_hits / n,
            "single_mrr_at_k": reciprocal / n}

if __name__ == "__main__":
    corpus = {"manual-v1": "AA BBBB CC", "other-v1": "AA BBBB CC"}
    questions = [{"id": "q1", "evidence": ["manual-v1", 3, 7],
                  "quote": "BBBB"}]
    rankings = {"q1": [("other-v1", 0, 10),
                       ("manual-v1", 0, 5),
                       ("manual-v1", 5, 10)]}
    print(evaluate(questions, rankings, corpus, k=3))
    # single_hit_at_k: 0.0, union_hit_at_k: 1.0, single_mrr_at_k: 0.0
Das künstliche Beispiel ergibt Single-span hit 0, Union hit 1 und Single-span MRR 0. Der erste Treffer enthält denselben Text in einem anderen Dokument und zählt nicht. Die nächsten beiden Treffer decken den richtigen Bereich gemeinsam ab. Diese Werte prüfen die Auswertung, nicht die Qualität eines Einbettungsmodells.
Die Auswertung an die echte Suche anschließen
Für jede Einstellung zerlegt die Pipeline denselben festgehaltenen Bestand, bettet die Chunks ein, baut einen getrennten Index auf und liefert zu jeder Frage geordnete Quellbereiche. Der Adapter muss jeden gefundenen Chunk auf den ursprünglichen Bereich zurückführen. Tokenizer, Zerleger, Einbettungsclient und Suchindex sind im Beispiel nicht enthalten.
Vier mögliche Größen wie 256, 512, 1024 und 2048 Token mit jeweils null oder 20 % Überlappung ergeben acht Einstellungen. Die Größen müssen zum gewählten Einbettungsmodell und Tokenizer passen. Stilles Abschneiden kann dazu führen, dass der Vektor weniger Text repräsentiert als der gespeicherte Chunk. Falls unterstützt, wird das Abschneiden deaktiviert; andernfalls muss ein solcher Fall erkannt und als fehlgeschlagene Einstellung behandelt werden.
Modellversion, Einstellungen für Frage und Dokument, Textextraktion, Ähnlichkeitsfunktion, Filter und Suchparameter bleiben gleich. Frageeinbettungen lassen sich bei vollständig identischen Eingaben und Modelleinstellungen wiederverwenden. Für Dokumenteinbettungen gilt dasselbe. Ein Modellwechsel verlangt einen neuen Vergleich.
Qualität, Kontext und Kosten vergleichen
Bei festem k können größere Chunks mehr Text liefern. Das Produkt k × Chunk-Größe ist nur eine nominelle Obergrenze für vollständig gefüllte Chunks. Kurze Endstücke, Zusatztexte, das Entfernen von Doppelungen und Kürzungen verändern die tatsächliche Promptlänge. Ein Vergleich mit festem Budget zählt den fertig zusammengesetzten Kontext mit dem Tokenizer des Antwortmodells und verwendet für alle Einstellungen dieselbe Packregel.
Bei langen Texten mit festen Fenstern nähert sich der Tokenfaktor bei Überlappungsanteil r dem Wert 1 / (1 - r). Bei r = 0,20 ergibt das 1,25: ungefähr 25 % zusätzliche Token, nicht 20 %. Vier Durchläufe ohne und vier mit 20 % Überlappung über zwei Millionen Token ergeben deshalb näherungsweise 18 Millionen Dokumenttoken für die Einbettung. Dokumentgrenzen und Rundungen verändern den genauen Wert. Frageeinbettungen, Index, Speicherung und Prüfaufwand kommen hinzu.
Eine nützliche Ergebnistabelle enthält Einstellung, Fragenzahl, beide Trefferquoten, MRR, tatsächliche Kontexttoken, eingebettete Token, Indexgröße und Laufzeit. Hier liegt keine gemessene Qualitätskurve vor. Eine Empfehlung für 512 Token lässt sich ohne zuordenbaren Bestand, Belege und Laufprotokoll nicht begründen. Strukturorientiertes Zerlegen ist ein weiterer Kandidat, kein automatischer Sieger.
Die vollständige Antwortkette gesondert prüfen
Bei einer Nachsortierung zählt die Belegabdeckung sowohl in der Vorauswahl als auch nach Nachsortierung und Zusammenstellen des Kontexts. Ein hoher Wert der ersten Stufe garantiert nicht, dass die letzten fünf Chunks den Beleg behalten. Zusätzlich braucht die fertige Antwort Prüfungen auf richtige Bedingungen, Quellenangaben und unbelegte Aussagen.
Eine erneute Bewertung folgt wesentlichen Änderungen an Quellen, Fragen, Modellen oder Verarbeitung. Weder ein Jahrestermin noch eine feste Prüfdauer garantiert ausreichende Abdeckung. Versionierte Fragen und Ergebnisse je Anfrage erleichtern die Suche nach Verschlechterungen.
Quellen
Passend dazu


