English
 Deutsch
 Polski
Tutorial: Sprawdzanie rozmiaru chunku i nakładki na zestawie testowym

Spis treści
Rozmiar chunku wybiera się na początku przedsięwzięcia, zwykle z przykładu w poradniku, a potem nigdy się go nie rusza. Nie dlatego, że nikt nie przeczuwa jego znaczenia, lecz dlatego, że jego sprawdzenie wygląda na wymagające całego rusztowania oceny.
Potrzeba trzydziestu pytań, jednej miary i pętli. A pętla nie wywołuje żadnego modelu językowego – właśnie to czyni całą rzecz na tyle tanią, by naprawdę ją przeprowadzić.
Pytanie, na które musi odpowiedzieć zestaw testowy
Wyszukiwanie ma dokładnie jedno zadanie: wprowadzić fragment z odpowiedzią do węższego wyboru trafiającego do modelu. To, czy model napisze potem dobrą odpowiedź, jest pytaniem osobnym o osobnych przyczynach – a mieszanie obu jest tym, co czyni ocenę drogą.
Pomiar da się więc rozdzielić. Zestaw pytań, każde ze znanym miejscem odpowiedzi w materiale źródłowym, oraz miara pytająca, jak często to miejsce pojawia się w pierwszych k wynikach. Nic z tego nie wymaga generowania tekstu, a zatem przebieg po ośmiu ustawieniach kosztuje osadzenia i nic więcej.
Miara nazywa się trafnością w pierwszych k wynikach. Dla k równego pięć: w ilu z trzydziestu pytań właściwy fragment znalazł się wśród pierwszych pięciu trafień. Jej uzupełnieniem jest średnia odwrotność rangi, nagradzająca dodatkowo bycie pierwszym, a nie piątym – użyteczna, gdy trafność przestaje rozdzielać kandydatów.
Trzydzieści pytań bez pisania trzydziestu pytań
Zestaw testowy potrafi wytworzyć model językowy i właśnie tutaj opłaca się ostrożność, bo droga najbardziej oczywista daje zestaw niczego niemierzący.
Wytworzenie pytania z chunku, a potem sprawdzanie, czy ten chunk zostanie znaleziony, jest kołem: pytanie napisano z tego tekstu, dzieli z nim słownictwo i odnajdzie go przy niemal każdym ustawieniu. Test mówi wtedy, że każde ustawienie jest znakomite.
Wyjściem jest wytwarzanie z dokumentu i zapisywanie, gdzie odpowiedź stoi – a nie w który chunk wpadła. Przypisanie do chunku następuje później, dla każdego ustawienia, w chwili oceny.
Polecenie dla generatora, na kazdy dokument zrodlowy:

  Przeczytaj ponizszy dokument. Napisz osiem pytan, na ktore dokument
  odpowiada. Do kazdego pytania przytocz doslownie zdanie zawierajace
  odpowiedz. Bez pytan wymagajacych wiedzy spoza dokumentu. Zmieniaj
  sformulowania tak, by pytanie nie powtarzalo brzmienia swojego
  zdania zrodlowego.

Wynik na kazdy wpis:

  { "frage": "…", "beleg": "doslowne zdanie z dokumentu",
    "dokument": "handbuch-2026.md" }
Następują potem dwie czynności ręczne i kosztują dwadzieścia minut. Przejrzenie pytań i skasowanie tych, których odpowiedź naprawdę nie stoi w przytoczonym zdaniu – kilka takich generator wytwarza. Oraz przepisanie tej garstki, która powtarza zdanie źródłowe niemal dosłownie, bo właśnie ona schlebiałaby każdemu ustawieniu.
Trzydzieści do pięćdziesięciu wpisów to zakres użyteczny. Poniżej mniej więcej dwudziestu pięciu jedno przechylające się pytanie przesuwa wynik o cztery punkty procentowe, a kolejność staje się szumem; powyżej pięćdziesięciu dodatkowa dokładność nie zmienia już tego, które ustawienie wygrywa.
Przeprowadzenie przebiegu
Każde ustawienie oznacza: podzielić zbiór na nowo, osadzić na nowo i przepuścić przez to pytania. Sama ocena jest porównaniem podciągu – właściwym chunkiem jest ten zawierający zapisane zdanie.
import itertools, json

GROESSEN     = [256, 512, 1024, 2048]
UEBERLAPPUNG = [0.0, 0.2]
K            = 5

def treffer(fragen, index, k):
    n = 0
    for f in fragen:
        gefunden = index.suche(f["frage"], k=k)
        if any(f["beleg"] in c.text for c in gefunden):
            n += 1
    return n / len(fragen)

fragen = json.load(open("testsatz.json"))
for groesse, ueberlappung in itertools.product(GROESSEN, UEBERLAPPUNG):
    stuecke = zerlegen(korpus, groesse, int(groesse * ueberlappung))
    index   = einbetten(stuecke)
    print(f"{groesse:5d}  {ueberlappung:.0%}  "
          f"recall@{K} {treffer(fragen, index, K):.2f}  "
          f"Stuecke {len(stuecke):5d}")
Trzy szczegóły czynią przebieg godnym zaufania. Zapisane zdanie trzeba porównywać po tym samym ujednoliceniu, które stosuje dzielnik – inaczej ściągnięty znak końca linii zamienia trafienie w chybienie. Zdanie padające dokładnie na granicę chunku liczy się jako znalezione, gdy zawiera je którykolwiek z dwóch chunków – i właśnie po to jest nakładka. A model osadzeń musi pozostać ten sam przez cały przebieg, bo zamiana zmienia wszystko i porównanie traci znaczenie.
Koszt warto oszacować wcześniej, a nie później. Osiem ustawień na zbiorze dwóch milionów tokenów daje z nakładką około osiemnastu milionów tokenów do osadzenia – od kilku centów do kilku euro zależnie od modelu, a więc na tyle mało, że przebieg wychodzi taniej niż jedno popołudnie dyskusji o nim.
Odczyt krzywej
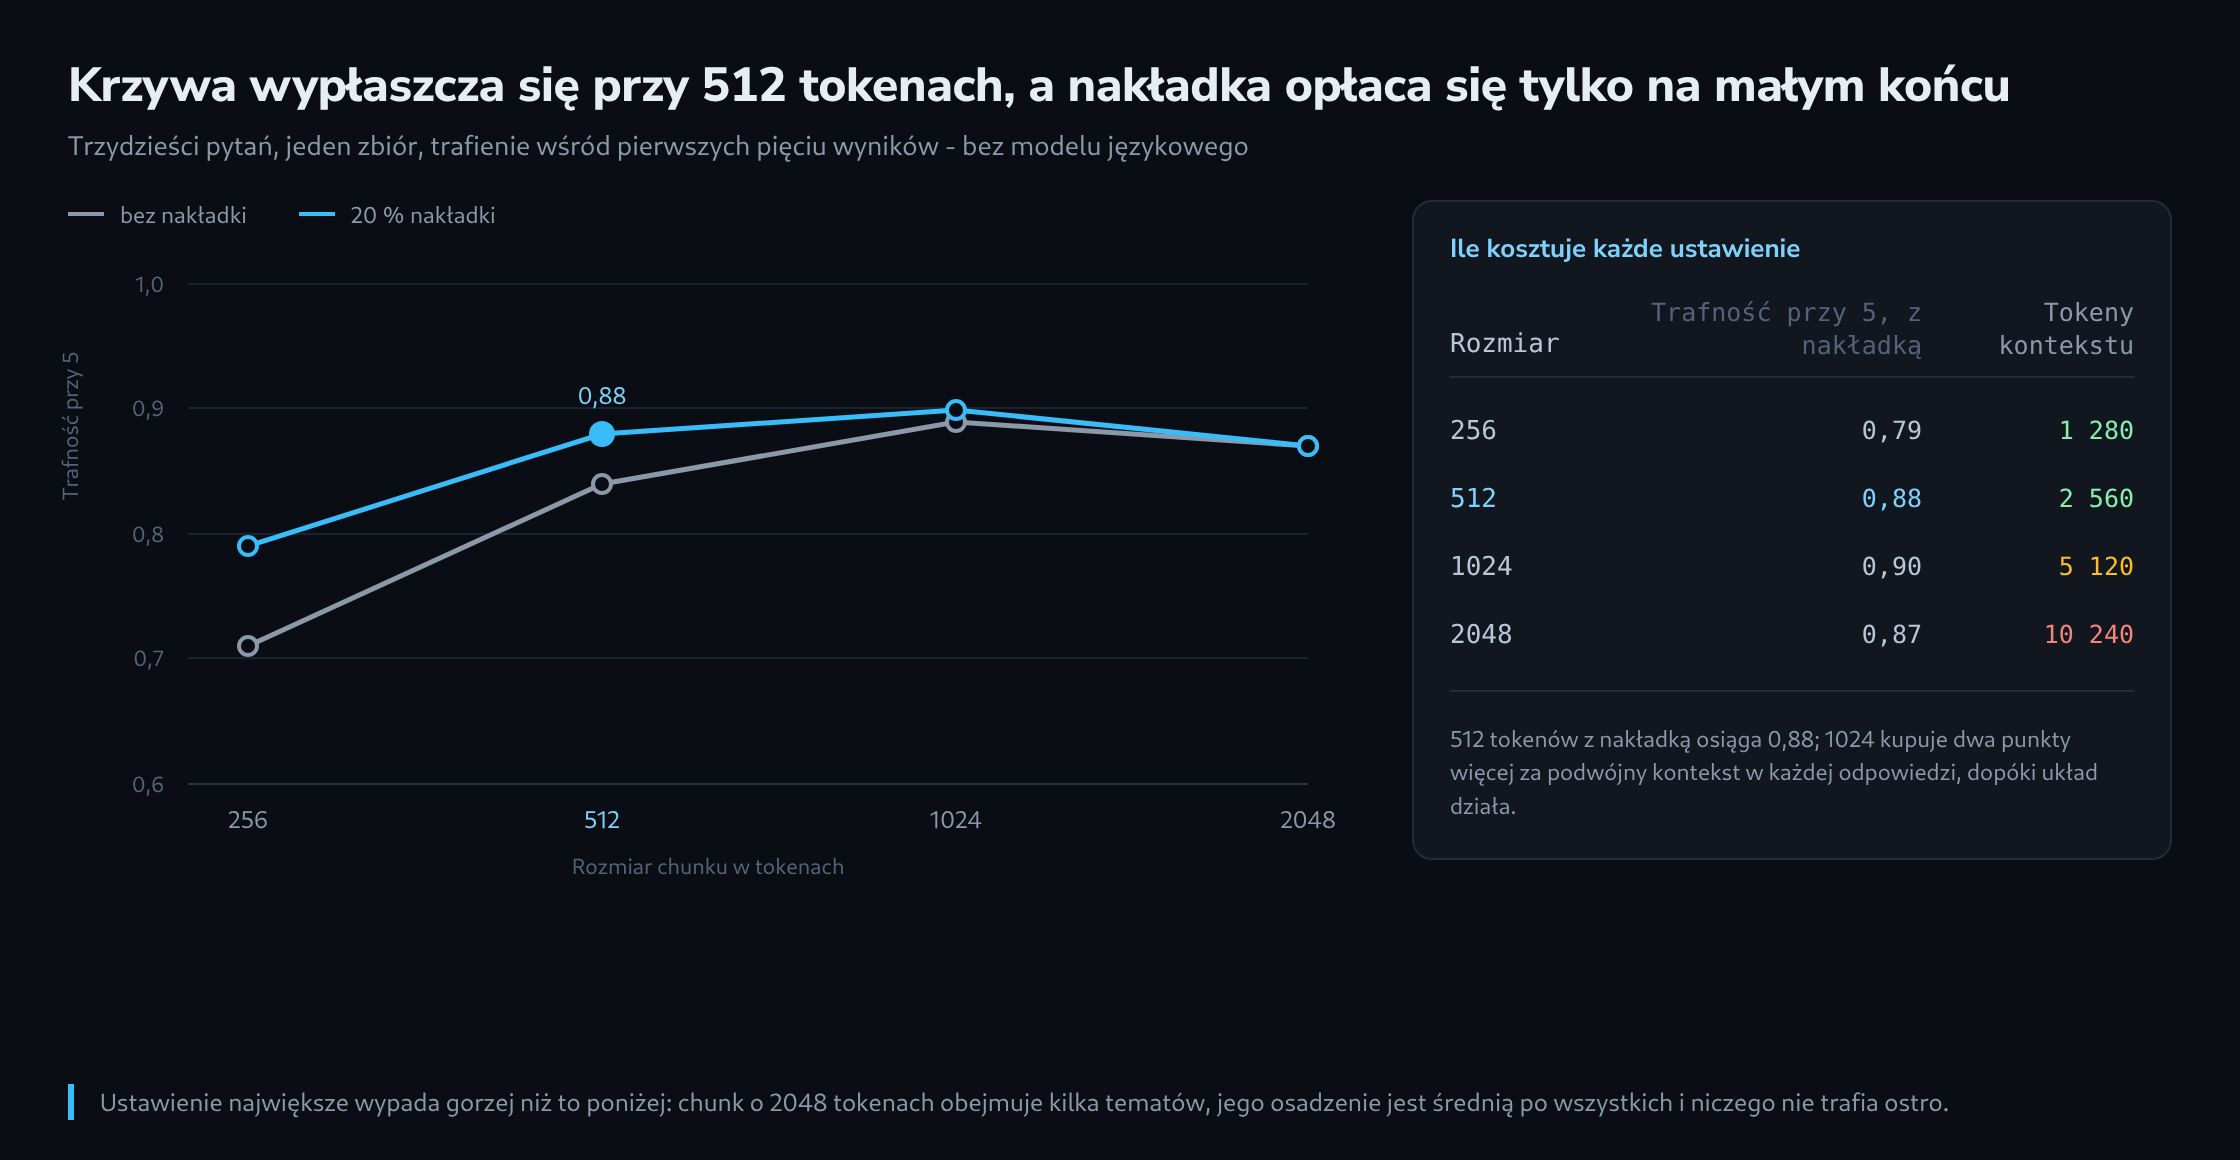
Wynik takiego przebiegu ma niemal zawsze ten sam kształt, a kształt mówi więcej niż pojedyncze liczby.
| Rozmiar chunku | bez nakładki | 20 % nakładki | Tokeny kontekstu na odpowiedź przy k = 5 |
|---|---|---|---|
| 256 | 0,71 | 0,79 | 1 280 |
| 512 | 0,84 | 0,88 | 2 560 |
| 1024 | 0,89 | 0,90 | 5 120 |
| 2048 | 0,87 | 0,87 | 10 240 |
Wynikają z tego trzy odczytania. Krzywa rośnie stromo, a potem się wypłaszcza, i to załamanie jest ustawieniem do wzięcia – tutaj 512, bo 1024 kupuje jeden lub dwa punkty za podwójny kontekst w każdej pojedynczej odpowiedzi, i to na stałe.
Nakładka zarabia na siebie na małym końcu, a na dużym traci znaczenie. Wynika to z jej celu: istnieje po to, by odpowiedź przecięta granicą przetrwała, a liczba granic zmniejsza się o połowę przy każdym podwojeniu rozmiaru chunku. Przy 1024 tokenach nakładka jest głównie dwudziestoprocentową dopłatą do rachunku za osadzenia.
A ustawienie największe wypada gorzej niż to poniżej, co za pierwszym razem zaskakuje. Chunk o 2048 tokenach obejmuje kilka tematów, jego osadzenie jest więc średnią po wszystkich i niczego nie trafia ostro. Większe chunki podnoszą prawdopodobieństwo, że odpowiedź leży gdzieś w węższym wyborze, i obniżają prawdopodobieństwo, że właściwy chunk stoi na przedzie.
Do tego samego przebiegu należy jedno porównanie i zwykle je wygrywa: dzielenie po strukturze zamiast po liczbie. Dzielnik przecinający na nagłówkach i zostawiający akapity w całości, z ograniczeniem rozmiaru jako regułą awaryjną, bije przy dokumentach z podziałem niemal każdy stały rozmiar – a przebieg pokazuje, o ile. To argument za włożeniem popołudnia w dzielnik zamiast w rozmiar.
Czego ta miara nie obejmuje
Trafność mierzy jedno ogniwo łańcucha, a trzy rzeczy leżą poza nim.
Pierwszą jest przesortowujący. Tam, gdzie taki działa, wyszukiwanie pobiera szeroki wybór wstępny – pięćdziesiąt, sto – a przesortowujący skraca go do pięciu. Liczy się wtedy trafność w pierwszych pięćdziesięciu, a ta wygląda zupełnie inaczej: jest wysoka niemal wszędzie, a rozmiar chunku przestaje przeważać. Mierzenie trafności w pierwszych pięciu w układzie z przesortowaniem odpowiada na pytanie, którego nikt nie zadał.
Drugą jest jakość odpowiedzi. Znaleziony chunk zawierający zdanie z odpowiedzią, ale nie zdanie je poprzedzające, nadal może dać odpowiedź błędną, bo modelowi brakuje warunku, na którym odpowiedź się opierała. W tej mierze jest to niewidoczne, a najtańszym sposobem zauważenia jest dwadzieścia odpowiedzi przeczytanych ręcznie, gdy ustawienie już stoi.
Trzecią jest czas. Zbiór rośnie, jego słownictwo się przesuwa, a zestaw testowy zbudowany dziś stopniowo przestaje przypominać to, o co się pyta. Powtórzenie przebiegu raz w roku kosztuje godzinę, a pożyteczniejsza część tej godziny polega na dołączeniu pytań rzeczywiście w międzyczasie zadanych – zestaw testowy z prawdziwych zapytań bije wytworzony pod każdym względem prócz szybkości powstania.
Pytania i odpowiedzi
Czy porównanie jest uczciwe, skoro duże chunki przy tym samym k wnoszą do węższego wyboru więcej tekstu?
Tylko częściowo. Przy k = 5 ustawienie z 2048 tokenami wnosi do węższego wyboru osiem razy więcej tekstu niż ustawienie z 256, a więcej tekstu już z tego powodu częściej zawiera zapisane zdanie. Nie bez powodu tabela zestawia trafność i tokeny kontekstu obok siebie, a wybór 512 opiera się właśnie na tym wyważeniu. Drugi przebieg rozdziela obie wielkości czysto.
Ustala on zamiast k budżet kontekstu. Przy 10 240 tokenach, wartości największego ustawienia, k wynika z 10240 // groesse: 40 chunków po 256, 20 po 512, 10 po 1024 i 5 po 2048. W kodzie wystarczy obliczać K dla każdego rozmiaru i przekazywać je do treffer(). Każde ustawienie przedkłada wtedy tyle samo tekstu, a trafność mierzy już tylko, jak dobrze wyszukiwanie wypełnia to miejsce.
O tym, które z dwóch porównań obowiązuje, rozstrzyga układ za nim. Jeśli w działaniu przekazywana jest stała liczba chunków, właściwy jest przebieg ze stałym k. Jeśli instrukcja jest wypełniana do budżetu tokenów, na rzeczywiście zadawane pytanie odpowiada przebieg ze stałym budżetem.
Czy zapisane zdanie, które cięcie bez nakładki rozdziela na dwa chunki, liczy się jako chybienie?
Tak, nawet jeśli obie połowy są wśród pierwszych k trafień. Porównanie podciągu szuka całego zdania w jednym chunku i nie znajduje go w żadnym z dwóch. Kolumna bez nakładki zawiera więc udział pochodzący z samego pomiaru: małe chunki mają najwięcej granic, a część różnicy między 0,71 a 0,79 przy 256 tokenach może wynikać z takich przypadków, a nie ze słabszego wyszukiwania.
Jak duża jest ta część, pokazuje druga ocena, która liczy zdanie jako znalezione także wtedy, gdy jego części stoją łącznie w pierwszych k chunkach. Obie wartości mają swoje uzasadnienie. Ścisła jest ostrożniejsza, bo obie połowy docierają do instrukcji osobno i być może w złej kolejności; luźna pokazuje, co wyszukiwanie faktycznie dostarczyło.
Czy wybrane ustawienie obowiązuje nadal po zmianie modelu osadzeń?
Nie bez sprawdzenia, bo krzywa należy do pary złożonej ze zbioru i modelu. Zestaw testowy pozostaje natomiast użyteczny, bo zapisuje dokument i zdanie, a nie chunk; zmiana modelu i tak wymaga ponownego osadzenia zbioru, a nowy przebieg dokłada wtedy tylko koszt pozostałych ustawień.
Źródła
Powiązane artykuły