Tutorial: Chunk-Größe und Überlappung gegen einen Testsatz prüfen

Inhalt
Die Chunk-Größe wird am Anfang eines Vorhabens gewählt, meist aus einem Beispiel in einer Anleitung, und danach nie wieder angefasst. Nicht weil niemand ahnte, dass sie zählt, sondern weil ihre Überprüfung nach einem Bewertungsgerüst aussieht.
Nötig sind dreißig Fragen, eine Kennzahl und eine Schleife. Und die Schleife ruft überhaupt kein Sprachmodell auf – genau das macht die Sache günstig genug, um sie tatsächlich durchzuführen.
Die Frage, die ein Testsatz beantworten muss
Der Abruf hat genau eine Aufgabe: die Passage mit der Antwort in die engere Auswahl zu bringen, die an das Modell geht. Ob das Modell danach eine gute Antwort schreibt, ist eine eigene Frage mit eigenen Ursachen – und beides zu vermischen ist es, was eine Bewertung teuer macht.
Die Messung lässt sich also trennen. Ein Satz Fragen, jede mit einem bekannten Ort der Antwort im Quellmaterial, und eine Kennzahl, die fragt, wie oft dieser Ort in den ersten k Ergebnissen auftaucht. Nichts davon braucht eine Texterzeugung, und damit kostet ein Durchlauf über zwölf Einstellungen die Einbettungen und sonst nichts.
Die Kennzahl heißt Trefferquote in den ersten k Ergebnissen. Für k gleich fünf: In wie vielen von dreißig Fragen war die richtige Passage unter den ersten fünf Treffern. Ergänzt wird sie durch den mittleren Kehrwert des Rangs, der zusätzlich belohnt, erster statt fünfter zu sein – nützlich, sobald die Trefferquote die Bewerber nicht mehr trennt.
Dreißig Fragen bekommen, ohne dreißig Fragen zu schreiben
Ein Sprachmodell kann den Testsatz erzeugen, und genau hier lohnt sich Vorsicht, denn der naheliegende Weg erzeugt einen Satz, der nichts misst.
Eine Frage aus einem Chunk zu erzeugen und dann zu prüfen, ob dieser Chunk gefunden wird, ist ein Kreis: Die Frage wurde aus diesem Text geschrieben, teilt sein Vokabular und findet ihn unter fast jeder Einstellung. Der Test sagt dann, dass jede Einstellung hervorragend sei.
Der Ausweg besteht darin, aus dem Dokument zu erzeugen und festzuhalten, wo die Antwort steht – nicht, in welchen Chunk sie gefallen ist. Die Zuordnung zum Chunk geschieht später, je Einstellung, zum Zeitpunkt der Auswertung.
Vorgabe an den Erzeuger, je Quelldokument:

  Lies das folgende Dokument. Schreibe acht Fragen, die das Dokument
  beantwortet. Zitiere zu jeder Frage den Satz, der die Antwort
  enthaelt, woertlich. Keine Fragen, die Wissen von ausserhalb des
  Dokuments brauchen. Variiere die Formulierung, damit eine Frage
  nicht den Wortlaut ihres Belegsatzes wiederholt.

Ergebnis je Eintrag:

  { "frage": "…", "beleg": "woertlicher Satz aus dem Dokument",
    "dokument": "handbuch-2026.md" }
Zwei Handgriffe folgen und kosten zwanzig Minuten. Die Fragen durchsehen und die löschen, deren Antwort nicht wirklich im zitierten Satz steht – davon erzeugt der Generator einige. Und die Handvoll umschreiben, die den Quellsatz fast wörtlich wiederholt, denn genau die würde jeder Einstellung schmeicheln.
Dreißig bis fünfzig Einträge sind der brauchbare Bereich. Unterhalb von etwa fünfundzwanzig verschiebt eine einzige kippende Frage das Ergebnis um vier Prozentpunkte und die Rangfolge wird zum Rauschen; oberhalb von fünfzig ändert die zusätzliche Genauigkeit nicht mehr, welche Einstellung gewinnt.
Den Durchlauf fahren
Jede Einstellung bedeutet: den Bestand erneut zerlegen, erneut einbetten und die Fragen hindurchschicken. Die Auswertung selbst ist ein Teilstring-Vergleich – der Chunk, der den festgehaltenen Satz enthält, ist der richtige.
import itertools, json

GROESSEN     = [256, 512, 1024, 2048]
UEBERLAPPUNG = [0.0, 0.2]
K            = 5

def treffer(fragen, index, k):
    n = 0
    for f in fragen:
        gefunden = index.suche(f["frage"], k=k)
        if any(f["beleg"] in c.text for c in gefunden):
            n += 1
    return n / len(fragen)

fragen = json.load(open("testsatz.json"))
for groesse, ueberlappung in itertools.product(GROESSEN, UEBERLAPPUNG):
    stuecke = zerlegen(korpus, groesse, int(groesse * ueberlappung))
    index   = einbetten(stuecke)
    print(f"{groesse:5d}  {ueberlappung:.0%}  "
          f"recall@{K} {treffer(fragen, index, K):.2f}  "
          f"Stuecke {len(stuecke):5d}")
Drei Einzelheiten machen den Lauf vertrauenswürdig. Der festgehaltene Satz muss nach derselben Vereinheitlichung verglichen werden, die auch der Zerleger anwendet – sonst macht ein zusammengezogener Zeilenumbruch aus einem richtigen Treffer einen Fehltreffer. Ein Satz, der genau auf eine Chunk-Grenze fällt, gilt als gefunden, wenn einer der beiden Chunks ihn enthält – und genau dafür ist eine Überlappung da. Und das Einbettungsmodell muss über den ganzen Durchlauf dasselbe bleiben, denn ein Wechsel verändert alles und der Vergleich verliert seine Bedeutung.
Die Kosten lohnen sich vorher zu schätzen statt nachher. Acht Einstellungen über einen Bestand von zwei Millionen Token ergeben mit der Überlappung rund achtzehn Millionen einzubettende Token – wenige Cent bis wenige Euro je nach Modell, und damit klein genug, dass der Durchlauf günstiger ist als ein Nachmittag Diskussion darüber.
Die Kurve lesen
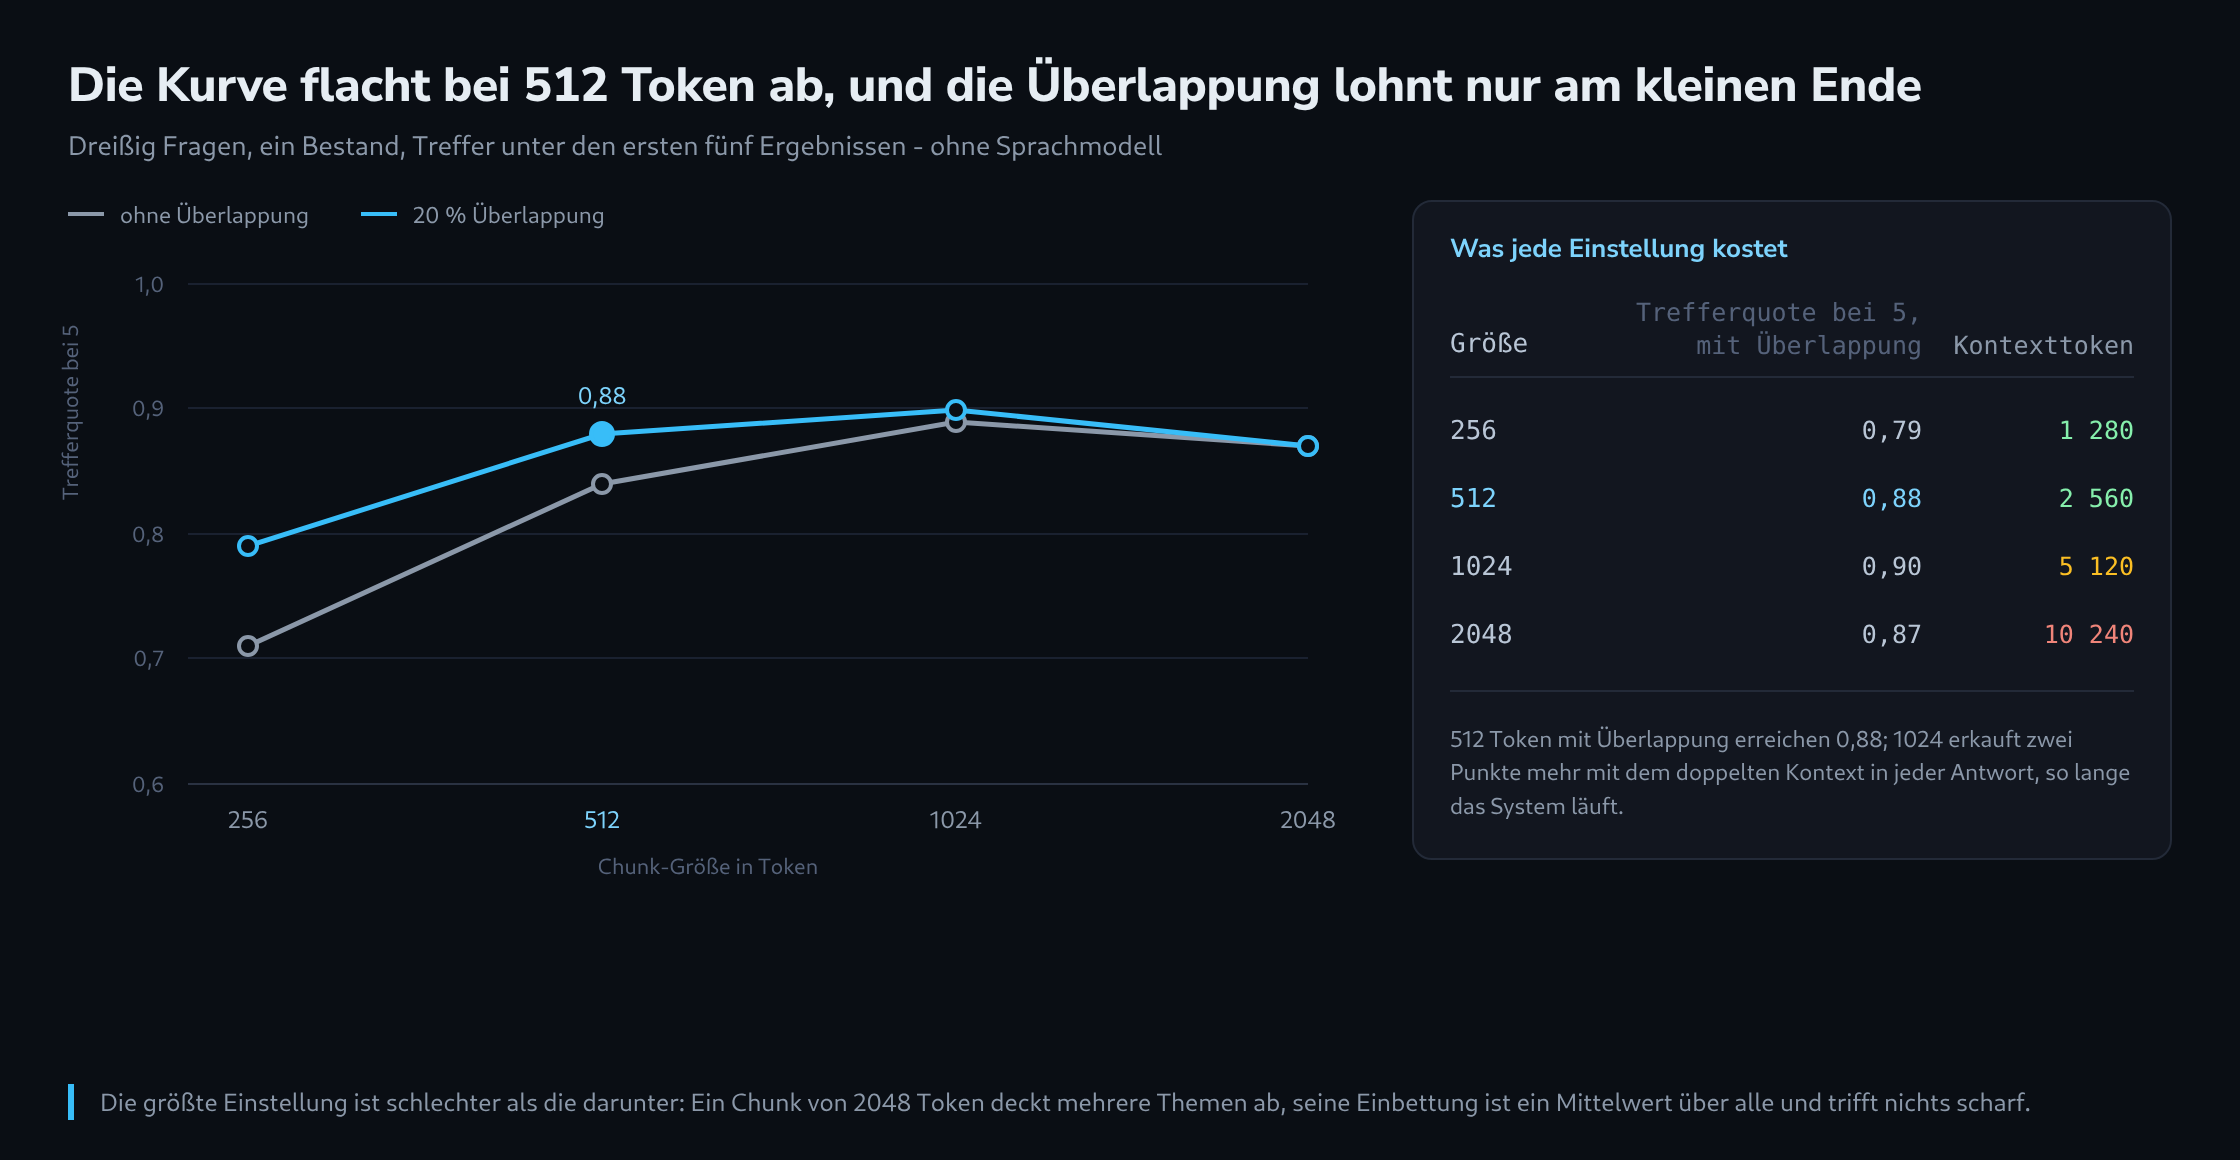
Das Ergebnis eines solchen Laufs hat fast immer dieselbe Gestalt, und die Gestalt sagt mehr als die einzelnen Zahlen.
| Chunk-Größe | ohne Überlappung | 20 % Überlappung | Kontexttoken je Antwort bei k = 5 |
|---|---|---|---|
| 256 | 0,71 | 0,79 | 1 280 |
| 512 | 0,84 | 0,88 | 2 560 |
| 1024 | 0,89 | 0,90 | 5 120 |
| 2048 | 0,87 | 0,87 | 10 240 |
Drei Lesarten ergeben sich daraus. Die Kurve steigt steil und flacht dann ab, und der Knick ist die Einstellung, die zu nehmen ist – hier 512, denn 1024 erkauft ein bis zwei Punkte mit dem doppelten Kontext in jeder einzelnen Antwort, auf Dauer.
Die Überlappung verdient ihr Geld am kleinen Ende und verliert am großen ihre Bedeutung. Das folgt aus ihrem Zweck: Die Überlappung existiert, damit eine über eine Grenze zerschnittene Antwort überlebt, und die Zahl der Grenzen halbiert sich mit jeder Verdopplung der Chunk-Größe. Bei 1024 Token ist eine Überlappung überwiegend ein Aufschlag von zwanzig Prozent auf die Einbettungsrechnung.
Und die größte Einstellung ist schlechter als die darunter, was beim ersten Mal überrascht. Ein Chunk von 2048 Token deckt mehrere Themen ab, seine Einbettung ist also ein Mittelwert über alle und trifft nichts scharf. Größere Chunks erhöhen die Wahrscheinlichkeit, dass die Antwort irgendwo in der engeren Auswahl liegt, und senken die Wahrscheinlichkeit, dass der richtige Chunk vorn steht.
Ein Vergleich gehört in denselben Lauf und gewinnt ihn meist: an der Struktur zerlegen statt an einer Zahl. Ein Zerleger, der an Überschriften trennt und Absätze ganz lässt, mit einer Größenbegrenzung als Auffangregel, schlägt bei Dokumenten mit Gliederung so gut wie jede feste Größe – und der Durchlauf zeigt, um wie viel. Das ist das Argument dafür, den Nachmittag in den Zerleger zu stecken statt in die Größe.
Was die Kennzahl nicht abdeckt
Die Trefferquote misst ein Glied der Kette, und drei Dinge liegen außerhalb.
Das erste ist ein Nachsortierer. Wo einer im Einsatz ist, holt der Abruf eine weite Vorauswahl – fünfzig, hundert – und der Nachsortierer kürzt sie auf fünf. Dann zählt die Trefferquote in den ersten fünfzig, und die sieht ganz anders aus: fast überall hoch, und die Chunk-Größe hört auf, den Ausschlag zu geben. Die Trefferquote in den ersten fünf in einem System mit Nachsortierung zu messen, beantwortet eine Frage, die niemand gestellt hat.
Das zweite ist die Antwortgüte. Ein gefundener Chunk, der den Antwortsatz enthält, aber nicht den Satz davor, kann trotzdem zu einer falschen Antwort führen, weil dem Modell die Bedingung fehlt, an der die Antwort hing. In dieser Kennzahl ist das unsichtbar, und der billigste Weg, es zu bemerken, sind zwanzig von Hand gelesene Antworten, sobald die Einstellung steht.
Das dritte ist die Zeit. Ein Bestand wächst, sein Vokabular verschiebt sich, und ein heute gebauter Testsatz ähnelt allmählich nicht mehr dem, was gefragt wird. Den Durchlauf einmal im Jahr zu wiederholen kostet eine Stunde, und der nützlichere Teil dieser Stunde besteht darin, die inzwischen tatsächlich gestellten Fragen aufzunehmen – ein Testsatz aus echten Anfragen schlägt einen erzeugten in jeder Hinsicht außer in der Geschwindigkeit seiner Entstehung.
Quellen
Passend dazu