

 English
 Deutsch
 Polski
Co obiecuje mapa witryny i co dotrzymują zawarte w niej adresy

Management Summary
Mapa witryny to lista adresów pomagająca wyszukiwarkom odkrywać opublikowane treści. Przydaje się zwłaszcza dużym stronom lub materiałom trudno dostępnym przez odsyłacze. Artykuł wyjaśnia, dlaczego wpisy powinny prowadzić do właściwych stron i czemu sprawdzenie kilku pozycji nie ocenia całej witryny. Mapa ułatwia odnajdywanie treści, ale nie gwarantuje obecności w wynikach wyszukiwania. Poprawne adresy i uzasadnione daty zmian zwiększają użyteczność przekazywanych informacji.
Spis treści
Mapa witryny udostępnia wyszukiwarkom adresy URL do odkrycia. Pomaga szczególnie przy dużych zbiorach lub słabym linkowaniu. Zgłoszenie mapy nie gwarantuje pobrania ani indeksowania stron. Wyszukiwarki mogą również znajdować strony przez odnośniki, bez mapy witryny.
Kontrola wymaga rozdzielenia trzech pytań: czy mapa jest dostępna i czytelna, jakie adresy zawiera faktycznie odczytany fragment oraz co zwracają wybrane adresy podczas pobierania. Dzięki temu ograniczona próbka nie staje się oceną całej witryny.
Odnalezienie mapy
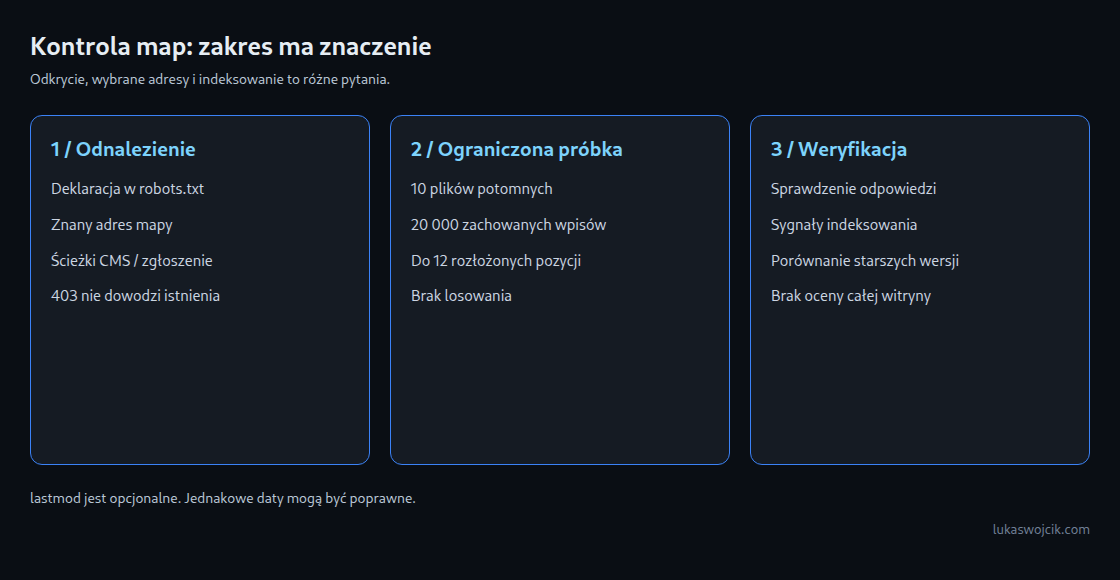
Wpis Sitemap: w robots.txt podaje jawnie opublikowany adres. Inne możliwości to znane ścieżki CMS, takie jak /sitemap.xml lub /wp-sitemap.xml, indeks map oraz bezpośrednio znany URL. Google przyjmuje także zgłoszenia przez Search Console. Istnieją zatem więcej niż dwie drogi; brak odpowiedzi pod zwyczajową ścieżką nie dowodzi braku mapy.
Status 403 potwierdza odmowę obsługi danego żądania. Nie potwierdza istnienia poprawnego pliku za tą odpowiedzią ani dostępu dla Googlebota. Takie wnioski wymagają osobnych dowodów.
Indeks a zakres kontroli
Lista URL w XML zawiera wpisy stron, natomiast indeks map wskazuje pliki map. Limity protokołu wynoszą odpowiednio 50 000 adresów lub 50 000 odwołań do map oraz 50 MB nieskompresowanych danych na plik. Google nie obsługuje indeksu map zagnieżdżonego w kolejnym indeksie.
Narzędzie odczytujące dziesięć plików map wskazanych przez indeks nie sprawdziło całego indeksu zawierającego na przykład 22 pliki. Osobno należy podawać liczbę rozpoznanych wpisów, zachowanych wpisów i faktycznie pobranych stron. Limit testu nie określa rozmiaru całej witryny.
Co wynika z próbki
Przykład objaśniający: siedem z dwunastu sprawdzonych adresów przekierowuje, a pięć zwraca 404. To dwanaście odpowiedzi wymagających uwagi w konkretnym wyborze. Nie wynika z tego odsetek błędów całej witryny ani wynik wszystkich żądań wyszukiwarek. Reguły dostępu są jedną z możliwych przyczyn 403; pewna diagnoza wymaga dodatkowych danych.
Dla trwale opublikowanej treści mapa powinna zasadniczo zawierać docelowe adresy kanoniczne. Są to preferowane adresy, gdy kilka URL pokazuje tę samą lub bardzo podobną treść. Przekierowania i nieaktualne URL wymagają sprawdzenia. Brak canonical wskazującego na tę samą stronę nie stanowi jednak samodzielnego zakazu indeksowania; obecny canonical również jest tylko sygnałem. Status 200 może towarzyszyć stronie błędu lub blokady. Treść odpowiedzi oraz, w miarę dostępności, Search Console dostarczają dalszych informacji.
lastmod: pole opcjonalne, oparte na treści
Pole lastmod jest opcjonalne. Nieznaną datę zmiany można pominąć; wymyślona świeża data byłaby gorsza. Dla Google liczy się ostatnia istotna zmiana, na przykład głównej treści, danych uporządkowanych lub ważnych odnośników. Odbudowa pamięci podręcznej albo sama aktualizacja roku praw autorskich nie uzasadnia nowej daty zmiany treści.
Jednakowe daty mogą odpowiadać rzeczywistej wspólnej aktualizacji. Duża liczba różnych dat nie dowodzi poprawności. Kontrola wymaga wcześniejszych wersji treści lub wiarygodnego rejestru zmian. Pojedyncze bieżące pobranie nie ustala daty ostatniej zmiany strony.
Możliwości i granice audytora
Audytor map XML wykonuje ograniczoną kontrolę. Implementacja sprawdzona 25 października 2026 początkowo wybiera pierwszy adres, gdy robots.txt podaje kilka; jawnie wpisany URL ma pierwszeństwo. Bez takich deklaracji sprawdzanych jest kilka typowych ścieżek. Odpowiedź ze statusem 200 może zakończyć wyszukiwanie także wtedy, gdy późniejsza analiza nie rozpozna mapy XML.
- Odczytywanych jest najwyżej dziesięć plików map wskazanych bezpośrednio przez indeks; dalsze poziomy indeksów nie są przeglądane.
- Do dalszej analizy pozostaje najwyżej 20 000 rozpoznanych wpisów URL.
- Z zachowanego fragmentu wybieranych jest do dwunastu równomiernie rozmieszczonych pozycji. Nie jest to losowanie ani reprezentatywne oszacowanie całego zbioru.
- Próbka strony obejmuje najwyżej 65 536 bajtów. JavaScript nie jest wykonywany.
- Metatagi robots i canonical w HTML są rozpoznawane przez ograniczone wzorce tekstowe. Inna kolejność atrybutów może pozostać niewykryta;
X-Robots-Tag, metatagi dla konkretnych botów i canonical w nagłówku HTTP Link nie są sprawdzane kompleksowo.
Wynik „czysty” oznacza więc tylko brak odpowiedniego ustalenia przy zastosowanych regułach. Nie oznacza pełnej walidacji XML ani pewnej możliwości indeksowania. Ważne adresy wymagają dodatkowej kontroli również po pozornie poprawnej próbce.
Pytania i odpowiedzi
Czy mapa może znajdować się na innym hoście?
Protokół opisuje upoważnienie przez deklarację mapy w robots.txt hosta danej witryny. Google obsługuje również potwierdzone zgłaszanie map dla różnych witryn. Dowolny odnośnik nie zastępuje wszystkich wymagań dotyczących własności i zakresu.
Jak dokumentować wynik?
Potrzebne są czas, dokładny adres początkowy, klient, sposób wyboru, limity pobierania, status, przekierowania i treść odpowiedzi. Twierdzenia o zmianach wymagają dodatkowo wcześniejszego stanu porównawczego. Kilka udanych żądań nie zatwierdza całego zbioru.
Powiązane artykuły


