English
 Deutsch
 Polski
Gdy AI czyta treści: Pay per Crawl, licencja danych czy płatne API?

Management Summary
Treści można oferować usługom AI za opłatą od pobrania, na podstawie uzgodnionych praw wykorzystania albo jako regularną dostawę przygotowanych danych. Każdy model sprzedaje inną usługę. Sam dostęp techniczny nie pozwala na dowolne użycie i nie tworzy przychodu. Mała próba z konkretnymi odbiorcami pomaga sprawdzić popyt, dostępne prawa, koszty utrzymania oraz wpływ na wizyty z wyszukiwarek. Potwierdzone dostawy i otrzymane płatności trzeba liczyć osobno; liczy się kwota pozostająca po kosztach.
Spis treści
Robot AI to program automatycznie pobierający strony, na przykład w celu zebrania materiałów dla aplikacji AI. Takie żądania nie muszą prowadzić do wizyt ludzi ani przychodu reklamowego. Treści można oferować za opłatą od pobrania, na licencji określającej użycie lub przez płatny interfejs danych. Modele da się łączyć; każdy dotyczy innej części usługi.
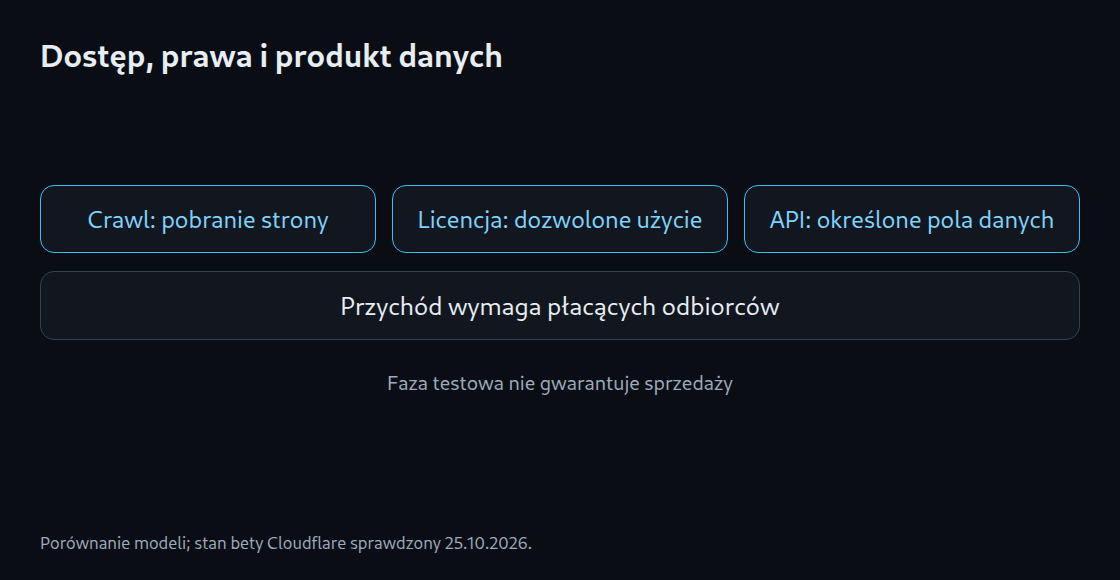
Trzy warstwy
| Model | Sprzedawana usługa | Warunek |
|---|---|---|
| Pay per Crawl | Płatny dostęp techniczny | Robot uczestniczący i gotowy zapłacić |
| Licencja danych | Uzgodniony zakres użycia | Prawa i konkretny odbiorca |
| Płatne API | Uporządkowana, niezawodna dostawa | Jakość, utrzymanie i integracja |
Mechanizm opisany przez Cloudflare
Opisany przez Cloudflare mechanizm Pay per Crawl wymaga uczestniczących, zarejestrowanych robotów. Żądanie płatnej treści może najpierw otrzymać odpowiedź HTTP 402 Payment Required z ceną: materiał jest dostępny za tę kwotę. Robot może zaakceptować cenę albo zrezygnować. Potwierdzone płatne dostarczenie trafia do rozliczenia; Cloudflare zbiera zdarzenia i rozlicza je później. Sama odpowiedź 402 nie uruchamia płatności. [1]
25 października 2026 roku publiczna strona zapisów nadal określa Pay per Crawl jako prywatną betę, czyli fazę testową z ograniczonym dostępem. AI Crawl Control pokazuje i kontroluje żądania robotów; Pay per Crawl dodaje płatny dostęp. Zgłoszenie nie oznacza aktywacji. Nawet po aktywacji przychód wymaga uczestniczących operatorów gotowych rzeczywiście płacić. [2]
Dostęp nie jest pełną licencją
Udane pobranie oznacza początkowo tylko przesłanie danych. Dalsze dozwolone użycie musi wynikać z odpowiednich warunków. Licencja może na przykład pozwalać na wyszukiwanie wewnętrzne i wykluczać przekazanie danych innym firmom. Może też określać czas, przechowywanie i przetwarzanie. Cena w odpowiedzi serwera nie zastępuje pełnego opisu tych praw.
Artykuł może zawierać własny tekst i cudze zdjęcie. Zgoda na pokazanie zdjęcia na blogu nie musi obejmować dalszego udostępnienia w pakiecie danych. Oferta wymaga więc spisu materiałów i związanych z nimi praw. Obiecane zastosowania muszą mieścić się w faktycznie dostępnych uprawnieniach.
Kiedy API daje więcej wartości
API to interfejs umożliwiający programom pobieranie określonych danych. Przykładem jest katalog produktów ze stałymi polami: numer artykułu, cena, waluta i data zmiany. Inny program może bezpośrednio wczytać te wartości zamiast wyszukiwać je na stronie internetowej. Dodatkową korzyść dają sprawdzone źródła, aktualne wpisy i zapowiedziane zmiany formatu.
Utrzymanie interfejsu wymaga stałej pracy. Trzeba sprawdzać klucze dostępu, ograniczać liczbę żądań i usuwać awarie. Błędy danych i pytania klientów również zajmują czas. Warunki zakończenia umowy powinny opisywać eksport, usuwanie i możliwość dalszego używania kopii. Działające API nie dowodzi jeszcze istnienia płacącego klienta.
Ograniczona próba biznesowa
Pierwsza próba zaczyna się od małego przykładowego zbioru i określonej grupy odbiorców. Rozmowy ustalają potrzebne pola, częstotliwość zmian i usługę wartą zapłaty. W próbie płatnego pobierania osobno zapisuje się potwierdzone zdarzenia rozliczeniowe, rzeczywiste wpływy i koszty utrzymania. Ocena obejmuje też zmiany ruchu z wyszukiwarek i innych wizyt. To porównanie nie zawiera wyników przychodowych własnej próby płatnego pobierania.
Plik robots.txt zawiera zasady dla robotów, które ich przestrzegają. Blokada nie zatrzymuje programów ignorujących plik i nie zastępuje ochrony hasłem. Google może nadal pokazywać zablokowany adres, jeśli prowadzą do niego linki z innych stron. Reguły dla wyszukiwarek i usług AI powinny więc odpowiadać konkretnemu celowi; ogólna blokada może objąć także pożądany ruch. [3]
Przydatna decyzja zaczyna się od konkretnego pytania: jakich danych potrzebuje kupujący i jaka usługa oszczędza pracę? Cena pobrania dotyczy dostępu. Licencja określa dozwolone zastosowania. API może dodatkowo regularnie dostarczać przygotowane dane. Dla każdej oferty trzeba sprawdzić popyt i kwotę pozostającą po kosztach; sama technologia nie potwierdza żadnej z tych rzeczy.
Powiązane narzędzia
Pytania i odpowiedzi
Czy każdy robot AI automatycznie płaci?
Nie. Opisany mechanizm Cloudflare wymaga rejestracji i gotowości do zapłaty. Robot może odrzucić płatną ofertę. Odpowiedź z ceną nie tworzy zatem automatycznie przychodu.
Czy porównanie zawiera własne pomiary przychodów?
Nie. Artykuł porównuje udokumentowane oferty i mechanizmy. Nie przedstawia własnej próby płatnego pobierania ani zmierzonych przychodów z takiej próby.
Źródła
- Cloudflare: Introducing pay per crawl
- Cloudflare: Pay per crawl private beta
- Google: Robots.txt limitations
- data.europa.eu: prawa do cudzych danych i ilustracji
Źródła ponownie sprawdzone: 25 października 2026.
Powiązane artykuły