English
 Deutsch
 Polski
Analityka bez ciasteczek: dlaczego syntetyczne ID nie odtwarzają sesji

Management Summary
Analityka bez cookies mierzy aktywność witryny bez małych zapisów przeglądarki służących rozpoznawaniu. Jedna metoda oblicza identyfikator z cech sieci i przeglądarki, lecz nie odtwarza wiarygodnie pojedynczych wizyt. Różne osoby mogą zostać połączone, a jedna wizyta rozbita po zmianie połączenia. Ma to znaczenie dla raportów o drodze klienta. Wybór pytania biznesowego przed metodą pomiaru ogranicza zbędne rozpoznawanie, bo dzienne sumy mogą wymagać mniej informacji niż indywidualne ścieżki.
Spis treści
- Co rzeczywiście łączy syntetyczny identyfikator
- Odmowa ciasteczek nie zawsze tworzy zmierzoną sesję z jednym zdarzeniem
- Brak ciasteczka nie dowodzi anonimowości
- Zmiana dnia nie usuwa zapisanych danych
- Dlaczego uniwersalny fragment kodu nie wystarcza
- Bez ślepego podstawiania identyfikatorów w systemach docelowych
- Wybór wiarygodnej metody pomiaru
- Pytania i odpowiedzi
- Źródła
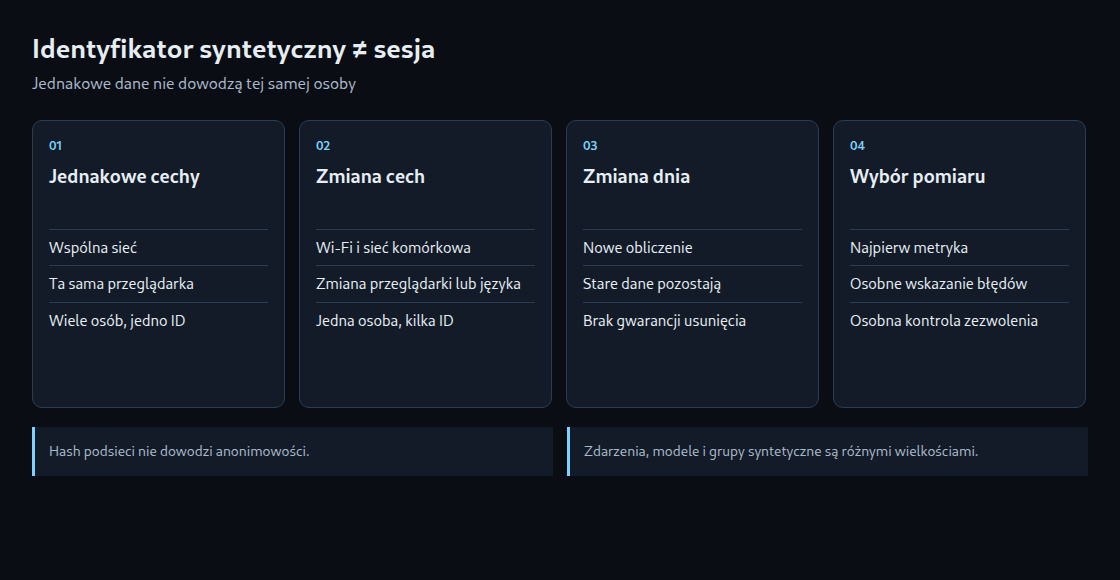
Bez powtarzalnego identyfikatora nie da się łatwo połączyć odsłon w wizyty. Hash podsieci IP i cech przeglądarki nie rozwiązuje tego problemu niezawodnie: różne osoby mogą otrzymać tę samą identyfikację, a jedna osoba kilka różnych. Taka wartość opisuje najpierw grupę jednakowych danych wejściowych, a nie potwierdzoną sesję.
Artykuł wyjaśnia techniczne ograniczenia syntetycznych identyfikatorów. Odmowa ciasteczek nie oznacza zgody na alternatywny mechanizm rozpoznawania.
Co rzeczywiście łączy syntetyczny identyfikator
Hash to kod obliczony z danych wejściowych. Typowa metoda łączy część sieciową adresu IP, opis przeglądarki w User-Agent, preferowany język i wartość zmienianą codziennie. Jednakowe dane dają jednakowy hash. To właściwość obliczenia, a nie dowód używania tej samej przeglądarki.
| Przykład | Wynik | Błąd pomiaru |
|---|---|---|
| Dwie osoby w sieci firmowej używają tego samego typu przeglądarki i języka. | Jednakowe dane i identyfikator | Dwie osoby zostają połączone. |
| Telefon przechodzi z Wi-Fi do sieci komórkowej. | Inna sieć, nowy identyfikator | Jedna wizyta może się podzielić. |
| Przeglądarka wraca rano i wieczorem. | Możliwy ten sam identyfikator dzienny | Osobne wizyty łączą się bez dodatkowej reguły czasu. |
| Wizyta trwa przez północ. | Nowa wartość dzienna i identyfikator | Trwająca wizyta zostaje podzielona. |
Błędy powstają przed haszowaniem. Dłuższy hash nie rozróżnia jednakowych danych wejściowych. Wynik skrócony do 16 znaków szesnastkowych ma ponadto tylko 64 bity; możliwe kolizje kryptograficzne są innym problemem niż celowe grupowanie tych samych cech.
Odmowa ciasteczek nie zawsze tworzy zmierzoną sesję z jednym zdarzeniem
Zachowanie zależy od produktu i konfiguracji. Całkowicie zablokowany tag analityczny nie wysyła zdarzeń pomiarowych. Zaawansowany Google Consent Mode może wysyłać sygnały bez ciasteczek analitycznych. Przy odpowiednich warunkach GA4 może udostępniać modelowane metryki użytkowników i sesji. Są to oszacowania, a nie odzyskane indywidualne ścieżki.
Błędne jest więc twierdzenie, że każda odsłona bez zgody musi stać się pełną izolowaną sesją i unieważnia wszystkie raporty. Błędna jest również przeciwna obietnica, że hash podsieci odtwarza rzeczywiste ścieżki. Zmierzone zdarzenia, modelowane wartości i własne grupy wymagają odrębnych oznaczeń.
Brak ciasteczka nie dowodzi anonimowości
Haszowanie nie jest szyfrowaniem. Skrócone IP i cechy przeglądarki nadal mogą umożliwiać przypisanie lub łączenie danych. Pseudonimizacja wymaga zatem odróżnienia od wykazanej anonimizacji. IPv4 /24 i IPv6 /48 są wyborami technicznymi, a nie ustawowymi progami anonimowości.
Art. 5 ust. 3 dyrektywy ePrivacy nie ogranicza się do ciasteczek. Wytyczne EROD obejmują także śledzenie oparte na IP; znaczenie mają rzeczywiste źródło i przetwarzanie informacji. W Niemczech odpowiednie wymagania wdraża § 25 TDDDG. Wymagana zgoda lub właściwy wyjątek oraz podstawa późniejszego przetwarzania danych osobowych wymagają osobnej oceny.
Twierdzenie o „braku przetwarzania pełnych adresów IP” byłoby również błędne dla funkcji odbierającej pełny adres przed skróceniem. Sieć, proxy i logi mogą tworzyć kolejne miejsca przetwarzania. Kontrola samych nagłówków odpowiedzi Set-Cookie nie obejmuje tych ścieżek.
Zmiana dnia nie usuwa zapisanych danych
Nowa wartość dzienna zmienia przyszłe hashe. Zapisane wcześniej identyfikatory, zdarzenia i powiązania pozostają bez zmian. Znaczniki czasu, konta, adresy URL lub inne pola nadal mogą łączyć rekordy. Powiązanie między dniami nie staje się więc matematycznie niemożliwe.
Salt to dodatkowa wartość uwzględniana przy obliczaniu hasha; zwykle nie jest sekretem. Osobno chroniony klucz HMAC może utrudnić odgadywanie bez znajomości klucza, ale nie usuwa błędów grupowania ani kwestii prawnych. Przechowywanie klucza, kopie, dostęp i usuwanie oraz retencja zdarzeń wymagają własnego projektu.
Transient WordPressa przechowuje wartość tymczasowo, aby uniknąć ponownych obliczeń lub pobierania danych. Nie jest niezawodnym magazynem klucza: wpis pamięci podręcznej może zniknąć przed terminem. Równoległe pierwsze żądania mogą użyć różnych wartości przy nieskoordynowanym tworzeniu. Kopie bazy i cache mogą zachować stare wartości. Wygaśnięcie i potwierdzone usunięcie wszystkich kopii to różne rzeczy.
Dlaczego uniwersalny fragment kodu nie wystarcza
Adresy IP wymagają parsera, czyli części programu rozpoznającej ich budowę i poprawne formy skrócone. Obcinanie tekstu rozdzielonego dwukropkami błędnie obsługuje skompresowane IPv6 oraz adresy IPv4 odwzorowane w IPv6. Za proxy REMOTE_ADDR często oznacza proxy, a dowolne przekazane nagłówki mogą być manipulowane. Brak adresu nie powinien po cichu grupować wszystkich żądań pod wartością zastępczą.
Kod Node.js z require(’crypto’) nie jest gotowym szablonem sGTM. GTM używa własnych API piaskownicy. Cloudflare Workers mają odrębne środowisko i konfigurację zgodności. Skopiowany generator nie zawiera ponadto kontroli zezwolenia, bezpiecznego zarządzania kluczami, zbierania zdarzeń ani sprawdzonego mapowania odbiorcy.
Bez ślepego podstawiania identyfikatorów w systemach docelowych
Identyfikator klienta GA4 nie jest identyfikatorem sesji. Wstawienie dziennej wartości jako client_id zmienia model tożsamości; non_personalized_ads=1 nie zapewnia brakującej zgody ani samodzielnie nie wdraża Consent Mode. Zgodność interfejsu nie potwierdza dopuszczalności przetwarzania.
Matomo dokumentuje dokładnie 16 znaków szesnastkowych dla _id. Prefiks syn_ i 16 znaków nie odpowiadają temu formatowi. Piwik PRO wymaga osobnej kontroli aktualnego interfejsu; podobne produkty nie są zamienne. Utworzenie identyfikatora również nie dodaje automatycznie kolumny najwyższego poziomu do eksportu BigQuery. Potrzebny jest własny schemat lub jawnie zaprojektowane przekształcenie.
Wybór wiarygodnej metody pomiaru
Najpierw potrzebna jest definicja metryki. Dla dziennych sum może wystarczyć wczesne zliczanie zdarzeń razem, bez przypisywania ich do rozpoznawalnych odwiedzających, jeżeli konkretne zbieranie danych jest dopuszczalne. Indywidualne ścieżki wymagają wiarygodnych, dozwolonych identyfikatorów i określonego modelu sesji. Syntetyczne grupy nie powinny być przedstawiane jako rzeczywiste osoby ani pełne ścieżki.
Ocena wykorzystuje sztucznie utworzone przypadki testowe albo legalnie zebrane dane porównawcze: wspólne sieci, zmiany adresów, jednakowe przeglądarki, zmianę dnia i brakujące pola. Raport powinien pokazać połączenia, podziały i przypadki nieznane. Grupa ze zgodą może różnić się od pozostałych wizyt i nie stanowi automatycznego dowodu jakości.
Pytania i odpowiedzi
Czy nowy identyfikator po północy dowodzi usunięcia danych?
Nie. Test pokazuje tylko zmianę obliczenia. Zapisane rekordy i kopie potrzebują odrębnej kontroli usuwania.
Czy identyfikator dzienny jest już sesją?
Nie. Sesja wymaga zdefiniowanych reguł czasu i zdarzeń. Nawet próg bezczynności nie usuwa błędów rozpoznawania.
Źródła
Powiązane artykuły