

 English
 Deutsch
 Polski
Weryfikacja adresów crawlerów: odwrotne DNS, opublikowane zakresy i granice obu metod

Management Summary
Roboty internetowe automatycznie odwiedzają witryny na potrzeby wyszukiwarek, usług AI i innych zadań. Podaną nazwę można skopiować, dlatego sama deklaracja nie wystarcza do wiarygodnego rozpoznania. Porównanie adresu połączenia z oficjalnymi informacjami dostawcy pomaga ustalić pochodzenie żądania. Artykuł wyjaśnia dowody i ich granice: nieudane sprawdzenie nie potwierdza podszywania się, a rozpoznany operator nie oznacza, że każda wizyta powinna mieć nieograniczony dostęp.
Spis treści
User-Agent to przesłana przez klienta etykieta z nazwą przeglądarki lub automatycznego programu. User-Agent taki jak Googlebot jest początkowo deklaracją klienta. Żądana ścieżka również pochodzi z żądania. Mocniejszą podstawę stanowi adres połączenia ustalony przez serwer, pod warunkiem poprawnego uwzględnienia pośredniczącego proxy. Dopiero wtedy można porównać adres z udokumentowaną infrastrukturą wskazanej usługi.
Dwie typowe metody to udokumentowany wzorzec nazwy DNS z potwierdzeniem wprzód oraz dopasowanie do oficjalnych zakresów IP. Wpis rejestrowy „Google LLC” lub „Microsoft Corporation” uzupełnia kontekst, lecz nie identyfikuje konkretnego crawlera.
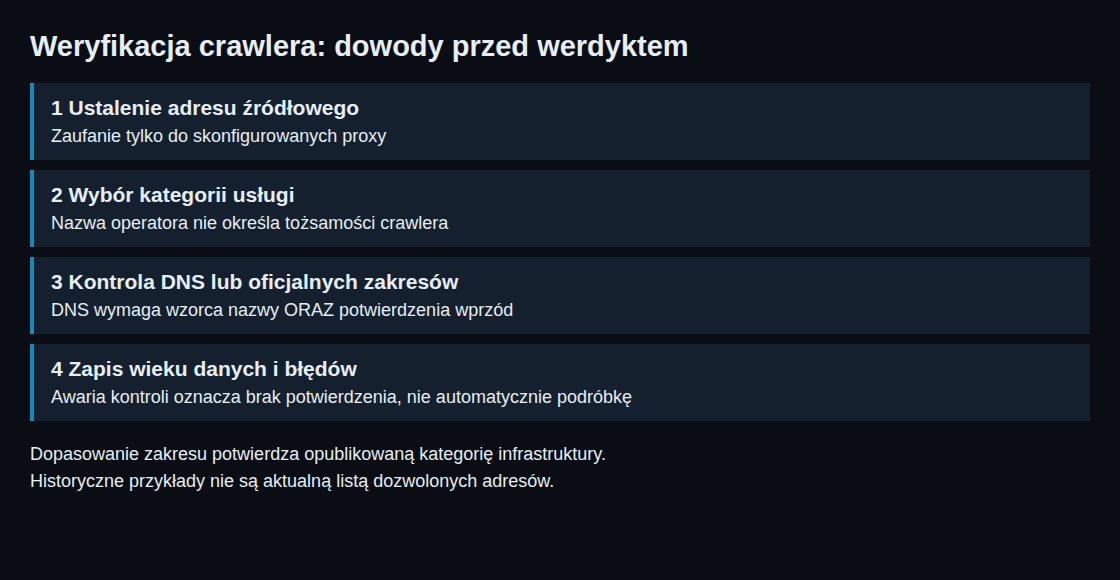
Weryfikacja DNS: nazwa, granica i kontrola wprzód
Odwrotne zapytanie zwraca nazwę PTR dla adresu IP. Sama nazwa nie wystarcza: administrator bloku adresowego może ustawić PTR bez kontroli nad domeną wymienioną w rekordzie. Weryfikacja wymaga zatem trzech kroków:
- Odczyt PTR rzeczywistego adresu źródłowego.
- Porównanie nazwy z aktualnie udokumentowanym wzorcem odpowiedniej kategorii crawlera. Zwykłe crawlery Google, crawlery specjalne i pobrania inicjowane przez użytkowników stanowią odrębne kategorie.
- Rozwiązanie zaakceptowanej nazwy przez rekordy A lub AAAA. Odpowiedź musi zawierać pierwotny adres.
Granica domeny ma znaczenie: crawl.example.googlebot.com znajduje się pod googlebot.com, natomiast googlebot.com.example.org nie. Dowolny poprawny obieg DNS potwierdza relację adresu z nazwą, a nie tożsamość Googlebota. Sama końcówka google.com również nie wystarcza do tak konkretnej klasyfikacji.
Metoda nie wymaga pobranej listy zakresów, ale nadal wymaga utrzymania. Wzorce nazw mogą się zmieniać, odpowiedzi DNS wygasają, a błędy rozwiązywania należy odróżniać od odpowiedzi negatywnych.
Listy zakresów: właściwa kategoria
Oficjalne pliki JSON zawierają prefiksy IPv4, a dla części usług także IPv6, w notacji CIDR, na przykład 66.249.66.0/27. Kontrola sprawdza przynależność adresu do sieci. Proste porównanie tekstu nie wystarcza.
Google wskazuje obecnie common-crawlers.json dla zwykłych crawlerów, osobną listę crawlerów specjalnych oraz kilka list pobrań i agentów inicjowanych przez użytkowników. Dopasowanie potwierdza przede wszystkim przynależność do opublikowanej kategorii infrastruktury. Wspólna lista nie musi rozróżniać każdego konkretnego identyfikatora User-Agent.
OpenAI publikuje osobne listy dla GPTBot, OAI-SearchBot i ChatGPT-User. Zadania obejmują odpowiednio trening modeli, wyszukiwanie i określone działania użytkowników. Brak PTR nie jest więc automatycznie podejrzany. Dla usług bez udokumentowanej metody weryfikacji DNS istotnym dowodem pozostaje odpowiednia oficjalna lista.
Co potwierdza historyczna próbka
Zapisany zestaw danych z 5 września 2026 r. obejmuje dwanaście odczytanych list z 2560 wpisami prefiksów; 2143 przypadały na cztery ówczesne listy Google. Podczas aktualizacji sumy ponownie obliczono z zachowanych liczników. Wpisy prefiksów nie oznaczają unikalnych adresów IP ani koniecznie rozłącznych sieci. Liczba wpisów nie pozwala wiarygodnie określić wielkości ruchu, architektury ani częstotliwości zmian.
Dla 20.171.207.1 i 52.230.152.1 historyczny wynik zawiera dopasowania do zakresów GPTBot bez ustalonego PTR. Zapisane pole nie odróżnia jednak braku PTR od błędu rozwiązywania. Wpis Microsoft w rejestrze również nie dowodzi konkretnej umowy najmu usług chmurowych. Wszystkie ustalenia adresowe pozostają obserwacjami historycznymi, a nie aktualną listą dozwolonych adresów.
8.8.8.8 pokazuje różnicę między organizacją a funkcją: Google dokumentuje ten adres jako publiczny resolver DNS. Poprawny obieg DNS i wpis Google w rejestrze nie oznaczają Googlebota. Wskazanie „Googlebot” było deklaracją wybraną do testu, a nie dowodem rzeczywistego żądania HTTP z tego resolvera.
64.233.173.1 znajdował się w historycznej liście pobrań Google inicjowanych przez użytkowników i miał odpowiednią nazwę google-proxy. Nie wynika z tego ani konkretna czynność odwiedzającego, ani automatyczne potwierdzenie Googlebota. Właśnie w tym miejscu klasyfikacja narzędzia była zbyt szeroka.
Tożsamość i zasady dostępu to osobne decyzje
robots.txt steruje współpracującymi crawlerami i pozostaje przydatny do tego celu. Plik nie stanowi blokady dostępu. Potwierdzony operator nie oznacza też jednakowych zasad robots.txt dla wszystkich usług: Google rozróżnia zwykłe crawlery, przypadki szczególne i pobrania inicjowane przez użytkowników. Googlebot nie obsługuje crawl-delay, więc ta dyrektywa nie odróżnia Googlebota od pobrania na żądanie użytkownika.
Brak potwierdzenia lub sprzeczne dowody nie oznaczają automatycznie złośliwego działania. Zależnie od celu niepożądane żądania mogą wymagać uwierzytelniania, limitów częstotliwości albo reguł na serwerze WWW lub poprzedzającej warstwie ochronnej. Blokada IP jest jedną z możliwości, a nie kompletną ochroną. Nie istnieje uniwersalny wspólny budżet crawlowania dla wszystkich operatorów.
Powtarzalna kontrola ręczna
Przykład wykorzystuje adres IPv4 z dokumentacji Google. Nazwa PTR musi pochodzić z rzeczywistej odpowiedzi; sprawdzenie kategorii i granicy domeny poprzedza rozwiązanie wprzód. Samo pobranie pliku JSON nie wykonuje dopasowania CIDR.
dig +short -x 66.249.66.1
dig +short A crawl-66-249-66-1.googlebot.com
dig +short AAAA crawl-66-249-66-1.googlebot.com
curl --fail --show-error --silent --location --max-time 20 \
  https://developers.google.com/static/crawling/ipranges/common-crawlers.json
Weryfikator IP crawlerów zbiera wyniki DNS, zakresów i rejestru. Podczas aktualizacji odtworzono jednak dwa ograniczenia: nazwa proxy Google potwierdzona wprzód mogła zostać zbyt ogólnie uznana za Googlebota, a nieudane pobranie listy nadal mogło prowadzić do werdyktu „podrobiony”. Poszczególne dowody i aktualność danych są zatem ważniejsze od etykiety podsumowującej. Pamięć podręczna jest odświeżana na żądanie po około 24 godzinach; nie gwarantuje to codziennego udanego pobrania.
Pytania i odpowiedzi
Który adres obowiązuje za kilkoma proxy?
Bezpośrednia strona połączenia musi najpierw należeć do jawnie zaufanych proxy. Następnie przekazany łańcuch jest analizowany od prawej do lewej, dopóki aktualny nadawca może wiarygodnie zgłaszać poprzedni adres. Wynik nie jest więc zawsze skrajnie prawym ani skrajnie lewym wpisem. Dowolny przychodzący nagłówek X-Forwarded-For nie może zastępować adresu źródłowego.
Apache udostępnia do tego mod_remoteip. Granice zaufania wymagają odpowiednich ustawień RemoteIPTrustedProxy lub RemoteIPInternalProxy; samo RemoteIPHeader nie stanowi bezpiecznej konfiguracji. Moduł może następnie używać sprawdzonego adresu klienta w logach i kontroli dostępu.
Czy DNS trzeba sprawdzać przy każdym żądaniu?
Przy synchronicznej kontroli DNS obsługa żądania czeka na odpowiedź DNS. Zwiększa to opóźnienie i może zatrzymać obsługę podczas awarii. Zwykle lepiej sprawdza się lokalne porównanie zakresów, ograniczony czas przechowywania wyników DNS i późniejsza analiza logów. Przetwarzanie nie jest bezkosztowe: limity czasu, wiek pamięci podręcznej i stany błędów wymagają zaplanowania. Apache domyślnie wyłącza ogólne HostnameLookups.
Czego wymaga IPv6?
Kontrola musi obsługiwać prefiksy IPv6 i odwrotną strefę ip6.arpa. Równoważne zapisy adresów wymagają normalizacji: 2001:db8::1 oraz 2001:0db8:0:0:0:0:0:1 oznaczają ten sam adres. Zwykłe porównanie ciągów może błędnie wykazać niezgodność.
Co oznacza brak dopasowania do zakresu?
Początkowo tylko brak wyniku w użytej liście. Wiarygodna ocena wymaga również właściwej kategorii, udanego pobrania, zaufanego źródła i znajomości wieku kopii. Czas publikacji dostawcy, lokalny czas pobrania i ostatnie udane pobranie to różne informacje. Udokumentowana kontrola DNS może dostarczyć dodatkowych dowodów, jeśli jest dostępna; w przeciwnym razie nieudana weryfikacja pozostaje „niepotwierdzona”, a nie automatycznie „podrobiona”.
Powiązane artykuły


