English
 Deutsch
 Polski
Od pobrania do pierwszej odpowiedzi: jak trudne jest uruchomienie lokalnego modelu LLM?

Management Summary
Lokalny model językowy tworzy odpowiedzi AI na własnym komputerze zamiast w zewnętrznej usłudze. Artykuł wyjaśnia drogę od pobrania programu do pierwszego użytecznego czatu. Odpowiednia aplikacja może ułatwić start na jednym stanowisku, ale urządzenie, pamięć i oprogramowanie muszą do siebie pasować. Opis pokazuje rzeczywisty nakład: konfiguracja i rozwiązywanie problemów dochodzą do późniejszego utrzymania. Wspólny dostęp dla kilku osób zwiększa wymagania.
Spis treści
Lokalny LLM to model językowy tworzący odpowiedzi na danym komputerze. Do pierwszej rozmowy często wystarcza aplikacja komputerowa i zgodny plik modelu. Usługa obsługująca kilka jednoczesnych zapytań wymaga dodatkowej konfiguracji. Najczęstsze przeszkody to odpowiednie sterowniki, wystarczająca pamięć i wykrycie karty graficznej.
Porównanie wyjaśnia kolejne kroki, ale nie podaje zmierzonego czasu instalacji. Czas zależy od komputera, oprogramowania i modelu. Długie pobieranie nie oznacza automatycznie trudnej konfiguracji, dlatego oba czasy są zapisywane osobno.
Odpowiedni początek według systemu
| System | Prosta ścieżka startowa | Dodatkowa praca |
|---|---|---|
| Windows | LM Studio lub Ollama | Odpowiedni sterownik; vLLM nie działa natywnie w Windows |
| macOS / Apple Silicon | LM Studio lub Ollama | Zgodny plik modelu i dostępna pamięć |
| Linux | Ollama lub gotowy program llama.cpp | Odpowiedni pakiet, dostęp do GPU i start usługi |
| Serwer Linux | vLLM ze zgodnym GPU | Obsługa modelu, formatu liczb i funkcji obliczeniowych |
Pięć informacji przed pobraniem
Przed pobraniem potrzebnych jest pięć informacji: system operacyjny, układ graficzny (GPU), dostępna pamięć operacyjna lub graficzna, wolne miejsce na dysku i wybrany model. Dokumentacja musi potwierdzać obsługę tej konkretnej kombinacji. Backend to część programu wykonująca obliczenia na CPU lub GPU. Kilka wersji modelu potrzebuje łącznie więcej miejsca na dysku niż pojedynczy plik.
Do pierwszego testu nadaje się mały obsługiwany model i krótkie zadanie z możliwym do sprawdzenia wynikiem, na przykład dwa punkty podsumowania podanego akapitu. Dłuższe teksty i jednoczesne zapytania dochodzą dopiero po tym teście. Pozwala to oddzielić błędy instalacji od ograniczeń pamięci. Kontekst oznacza ilość tekstu, którą model może uwzględnić podczas jednego zapytania.
Czas pobierania a czas konfiguracji
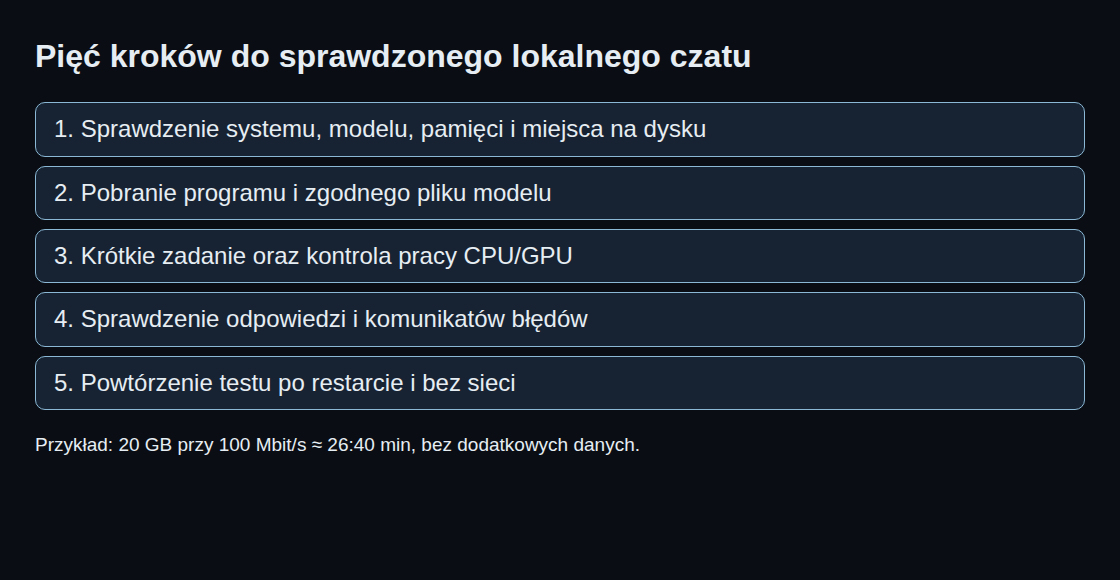
Przykład obliczeniowy: plik modelu o wielkości 20 GB zawiera 160 gigabitów, ponieważ jeden bajt ma osiem bitów. Przy stałych 100 Mbit/s przesłanie pliku trwa teoretycznie 1600 sekund, czyli 26 minut i 40 sekund. Przy 1 Gbit/s trwa 160 sekund. Chodzi o dziesiętne GB; obliczenie pomija dodatkowe dane transmisji, wahania szybkości i limity serwera.
Rzetelne porównanie czasu zapisuje osobno cztery etapy: pobieranie, instalację, pierwszy start modelu i szukanie błędów. Po szybkim pobraniu może nastąpić długa diagnostyka. Z kolei prosta w obsłudze aplikacja może długo czekać na duży plik.
Potwierdzenie pracy GPU
Odpowiedź nie potwierdza pracy GPU. W Ollama polecenie ollama list pokazuje zapisane modele, a ollama ps modele aktualnie załadowane. Kolumna PROCESSOR rozróżnia pamięć CPU, GPU i podział między obie. Dzienniki programu i obciążenie GPU podczas zapytania uzupełniają tę informację. Pusta lista po usunięciu modelu z pamięci nie dowodzi błędu sterownika.
ollama list
ollama ps
Słabe lub powolne odpowiedzi mogą mieć różne przyczyny. Obliczenia na CPU mogą trwać dłużej. Błędny szablon czatu może przekazywać role lub wiadomości w niewłaściwym formacie. Nieobsługiwana kwantyzacja, czyli oszczędniejszy zapis liczb, może uniemożliwić załadowanie modelu. Błędy pamięci przy dłuższych tekstach wymagają natomiast sprawdzenia długości kontekstu i zapasu pamięci. Konkretny komunikat błędu wyznacza następny krok.
Pierwszy start a stała praca
Po pierwszym sukcesie następują zmiana modelu, ponowne uruchomienie komputera i powtórzenie tego samego zadania bez sieci. Pliki modelu i potrzebne moduły obliczeniowe muszą być już zainstalowane. Narzędzia zewnętrzne i modele chmurowe pozostają wyłączone. Test potwierdza sprawdzoną konfigurację; późniejsze aktualizacje lub inne funkcje mogą ponownie wymagać połączenia.
API umożliwia innym programom wysyłanie zapytań do modelu. Na początku usługa powinna być dostępna tylko przez adres pętli zwrotnej 127.0.0.1 na tym samym komputerze. Udostępnienie w sieci wymaga ochrony dostępu, limitów jednoczesnych zapytań i utrzymania. Pojedynczy czat komputerowy nie potrzebuje takiej usługi. Kalkulator pamięci pomaga wybrać model i sprzęt, a zapis przebiegu instalacji pokazuje rzeczywisty nakład pracy.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy poprawne uruchomienie modelu potwierdza pracę GPU?
Model może działać również na procesorze głównym (CPU) albo częściowo na CPU i GPU. Podział pamięci w ollama ps oraz obciążenie podczas zapytania pomagają sprawdzić konfigurację.
Czy lokalny model LLM działa bez internetu?
Po pobraniu wszystkich plików i instalacji odpowiedniego programu odpowiedzi mogą powstawać bez internetu. Narzędzia zewnętrzne i modele chmurowe mogą wymagać połączenia. Test bez sieci pokazuje, czy konkretne lokalne zadanie działa.
Źródła
- Ollama: obsługiwany sprzęt
- vLLM: instalacja z obsługą GPU
- llama.cpp: projekt i obsługa sprzętu
- LM Studio: dokumentacja
- Ollama: FAQ
- Ollama: opis poleceń
- LM Studio: praca bez internetu
- LM Studio: wymagania systemowe
Źródła sprawdzone: 26 października 2026.
Powiązane artykuły