English
 Deutsch
 Polski
Intel Arc dla lokalnych modeli LLM: B580, Pro B50, B60, B65 i B70 w porównaniu z NVIDIA

Spis treści
Intel Arc zasługuje na porównanie dla lokalnych LLM, gdy wymagana konfiguracja modelu działa przez właściwy backend. Niska cena za GB nie wystarcza sama w sobie. Sterownik, system, architektura modelu i silnik muszą obsługiwać tę samą konkretną kartę.
Porównanie analizuje oficjalne pojemności i udokumentowane ścieżki programowe, bez własnych pomiarów szybkości względem NVIDIA. Nakład pracy programowej powinien więc być równie widoczny jak pamięć.
Pięć konkretnych poziomów pamięci
| Karta Intel | Oficjalna pamięć | Główna kontrola |
|---|---|---|
| Arc B580 | 12 GB | Konfiguracja początkowa i sterownik |
| Arc Pro B50 | 16 GB | Kompaktowa wersja profesjonalna |
| Arc Pro B60 | 24 GB | Większy pojedynczy model |
| Arc Pro B65 | 32 GB | Konkretna karta partnera i silnik |
| Arc Pro B70 | 32 GB | Profil obliczeń przy tej samej pojemności |
Ta sama pamięć nie czyni B65 i B70 identycznymi kartami. Mniejsza konfiguracja obliczeniowa może wystarczyć, gdy główną granicą jest pojemność. Porównanie zakupu potrzebuje dwóch ujęć: tej samej pamięci i podobnego kosztu całości.
Osobna kontrola czterech ścieżek
llama.cpp dokumentuje backendy Vulkan i SYCL. Ollama opisuje dodatkową obsługę Vulkan w Windows i Linux. OpenVINO GenAI zapewnia osobną ścieżkę inferencji, a vLLM posiada instalację XPU. Te informacje nie gwarantują łącznie każdej karty Arc i architektury modelu.
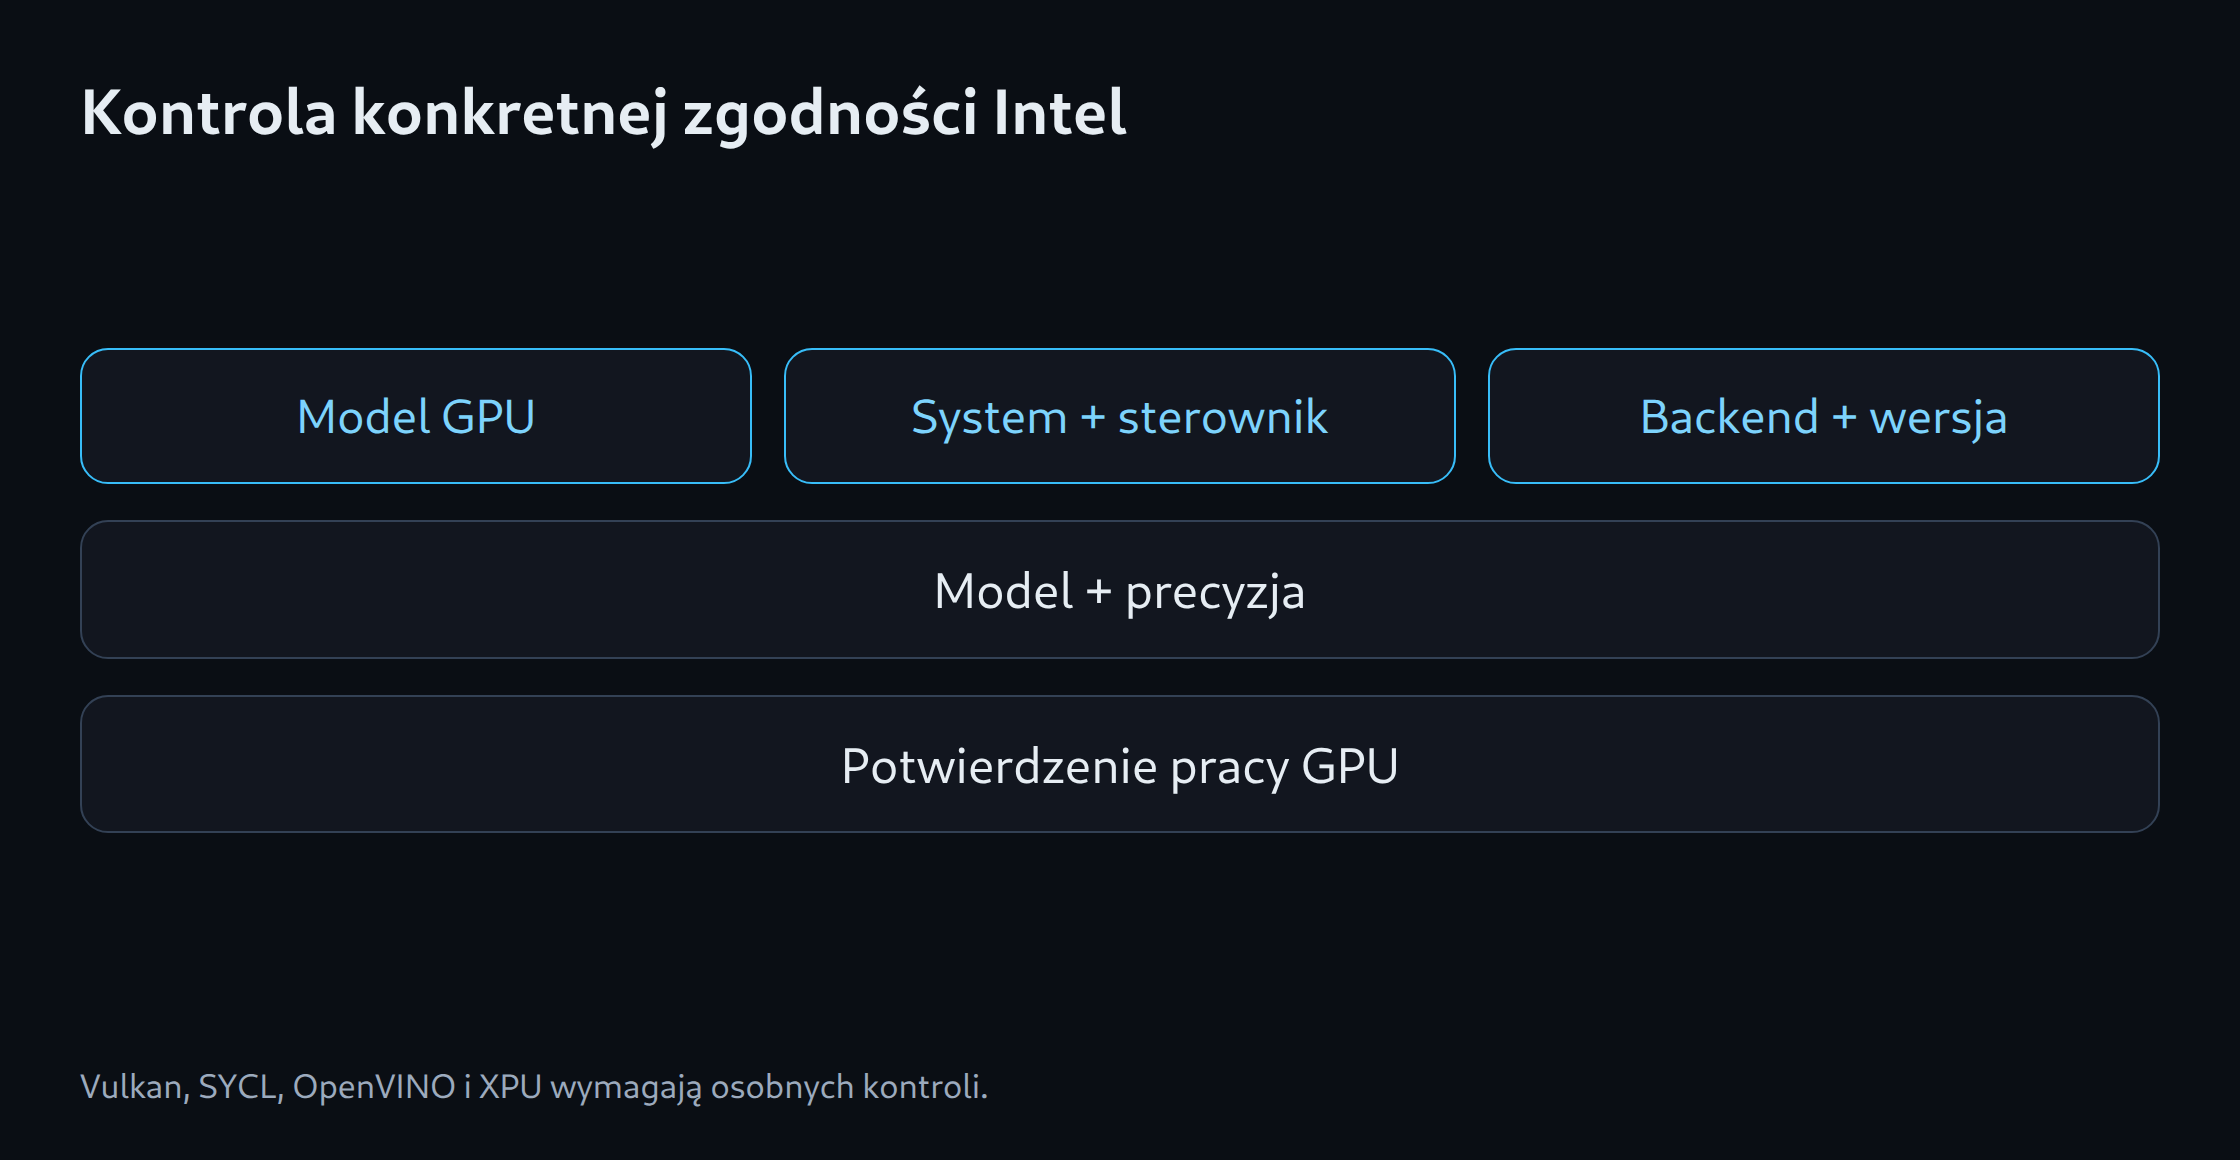
Macierz kontroli wymaga GPU, sterownika, systemu, wersji środowiska, rewizji modelu i precyzji. Jedna ścieżka może wymagać konwersji, a inna obyć się bez niej. Poprawna instalacja nie potwierdza ani pracy GPU, ani prawidłowego wyniku.
Windows i Linux to różne projekty
Aplikacja komputerowa w Windows może uprościć początek. Linux dodaje wersje pakietów, dostęp do urządzenia i ustawienia kontenera. Nakład pracy zależy od backendu. Instrukcja CUDA nie staje się bez zmian instrukcją Intela.
Wykrywanie urządzenia, zajęta pamięć GPU i logi pomagają ustalić, gdzie faktycznie wykonywane są obliczenia. Niezauważone przejście na CPU może sprawiać wrażenie udanego startu. Krótkie zadanie referencyjne ze sprawdzalną odpowiedzią pomaga także rozpoznać problemy z formatem lub modelem.
Uczciwe porównanie z NVIDIA
Arc Pro B60 z 24 GB może być porównana z kartą NVIDIA 24 GB pod względem pojemności. Ocena ceny wymaga bieżących ofert i kosztu całego systemu. Różne modele lub długości odpowiedzi nie tworzą poprawnego porównania szybkości.
Potrzebne są te same zadania, rewizja modelu i zapisany kontekst. Jeżeli backendy wymagają różnych kwantyzacji, różnica pozostaje jawna. Ocena obejmuje pierwszą odpowiedź, generowanie, błędy i nakład pracy przy konfiguracji, zamiast przypisywać nadmierne znaczenie jednej liczbie tokenów na sekundę.
Kiedy Intel pasuje do listy
Intel jest atrakcyjny, gdy potwierdzona konfiguracja obsługuje model i zachowuje istotną przewagę ceny. Dodatkowa kompilacja lub konwersja może zużyć tę korzyść w małym projekcie. Czas diagnozowania także należy do kosztów.
Kalkulator pamięci pomaga ocenić pojemność. Wybór programu wymaga następnie potwierdzonej ścieżki Intela. Ogólna etykieta zgodności nie zastępuje wyniku. Bez dowodu testu kombinacja pozostaje kandydatem, nawet przy wystarczającym VRAM.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy programy CUDA działają bez zmian na Intel Arc?
CUDA nie jest natywnym backendem Intel Arc. Konkretne oprogramowanie wymaga obsługiwanej ścieżki, takiej jak Vulkan, SYCL, OpenVINO lub XPU.
Czy ogólna deklaracja obsługi GPU Intela wystarcza do decyzji zakupowej?
Ogólna deklaracja nie obejmuje każdej karty, architektury modelu ani kwantyzacji. Znaczenie mają konkretny GPU, sterownik, system i wersja środowiska. Udokumentowana konfiguracja testowa zapewnia lepszy dowód niż ogólne oznaczenie zgodności.
Źródła
- Intel: Arc B580 12 GB / B570 10 GB
- Intel: Arc Pro B50 16 GB
- Intel: Arc Pro B60 und B50
- Intel: Einführung Arc Pro B65 / B70
- Intel: Arc Pro B70 – Datenblatt, 32 GB
- Ollama: Hardware support
- llama.cpp: Projekt und Backends
- vLLM: GPU installation
- OpenVINO: Generative AI workflow
- Intel: Arc Pro B65 32 GB – Datenblatt
- Intel: Arc Pro B60 24 GB
Źródła sprawdzone: 5 października 2026.
Powiązane artykuły