English
 Deutsch
 Polski
Vocal chain w FL Studio 2026: kolejność efektów, ustawienia i zmierzony wpływ każdego kroku

Spis treści
- Jak wyglądał pomiar
- Krok 1: własna ścieżka miksera, poziom nagrania i czyszczenie
- Krok 2: wysokość dźwięku przed dynamiką
- Krok 3: filtr górnoprzepustowy w Fruity Parametric EQ 2
- Filtr górnoprzepustowy należy przed kompresor
- Krok 4: kompresja w Fruity Limiter, zakładka COMP
- Krok 5: de-esser i wpływ kompresji na syczenie
- Przed kompresorem czy za nim: decyduje próg, a nie miejsce
- Krok 6: nasycenie oszczędnie
- Pogłos i delay na ścieżkach send
- Gotowy łańcuch w kolejności slotów
- Po łańcuchu: szyna i głośność
- Zakres i granice
- Pytania i odpowiedzi
- Źródła
Wokal leży w FL Studio na własnej ścieżce miksera. Każda ścieżka insert ma według podręcznika dziesięć slotów efektów, a to, co i w jakiej kolejności w nich stoi, współdecyduje o głośności, równości i ostrości głosu. Ten poradnik buduje łańcuch z sześciu kroków, wymienia do każdego kroku regulatory opisane w podręczniku i mierzy, co zmienia kolejność.
Pomiar powstał nie na wtyczkach FL, lecz w ffmpeg na syntetycznym sygnale głosowym. Dzięki temu cztery pytania mają odpowiedź liczbową, a nie tylko smakową: jak wysoko wolno położyć filtr górnoprzepustowy, ile kosztuje on na tonie podstawowym, co daje przed kompresorem i jak kompresja przesuwa odstęp między syczeniem a samogłoską.
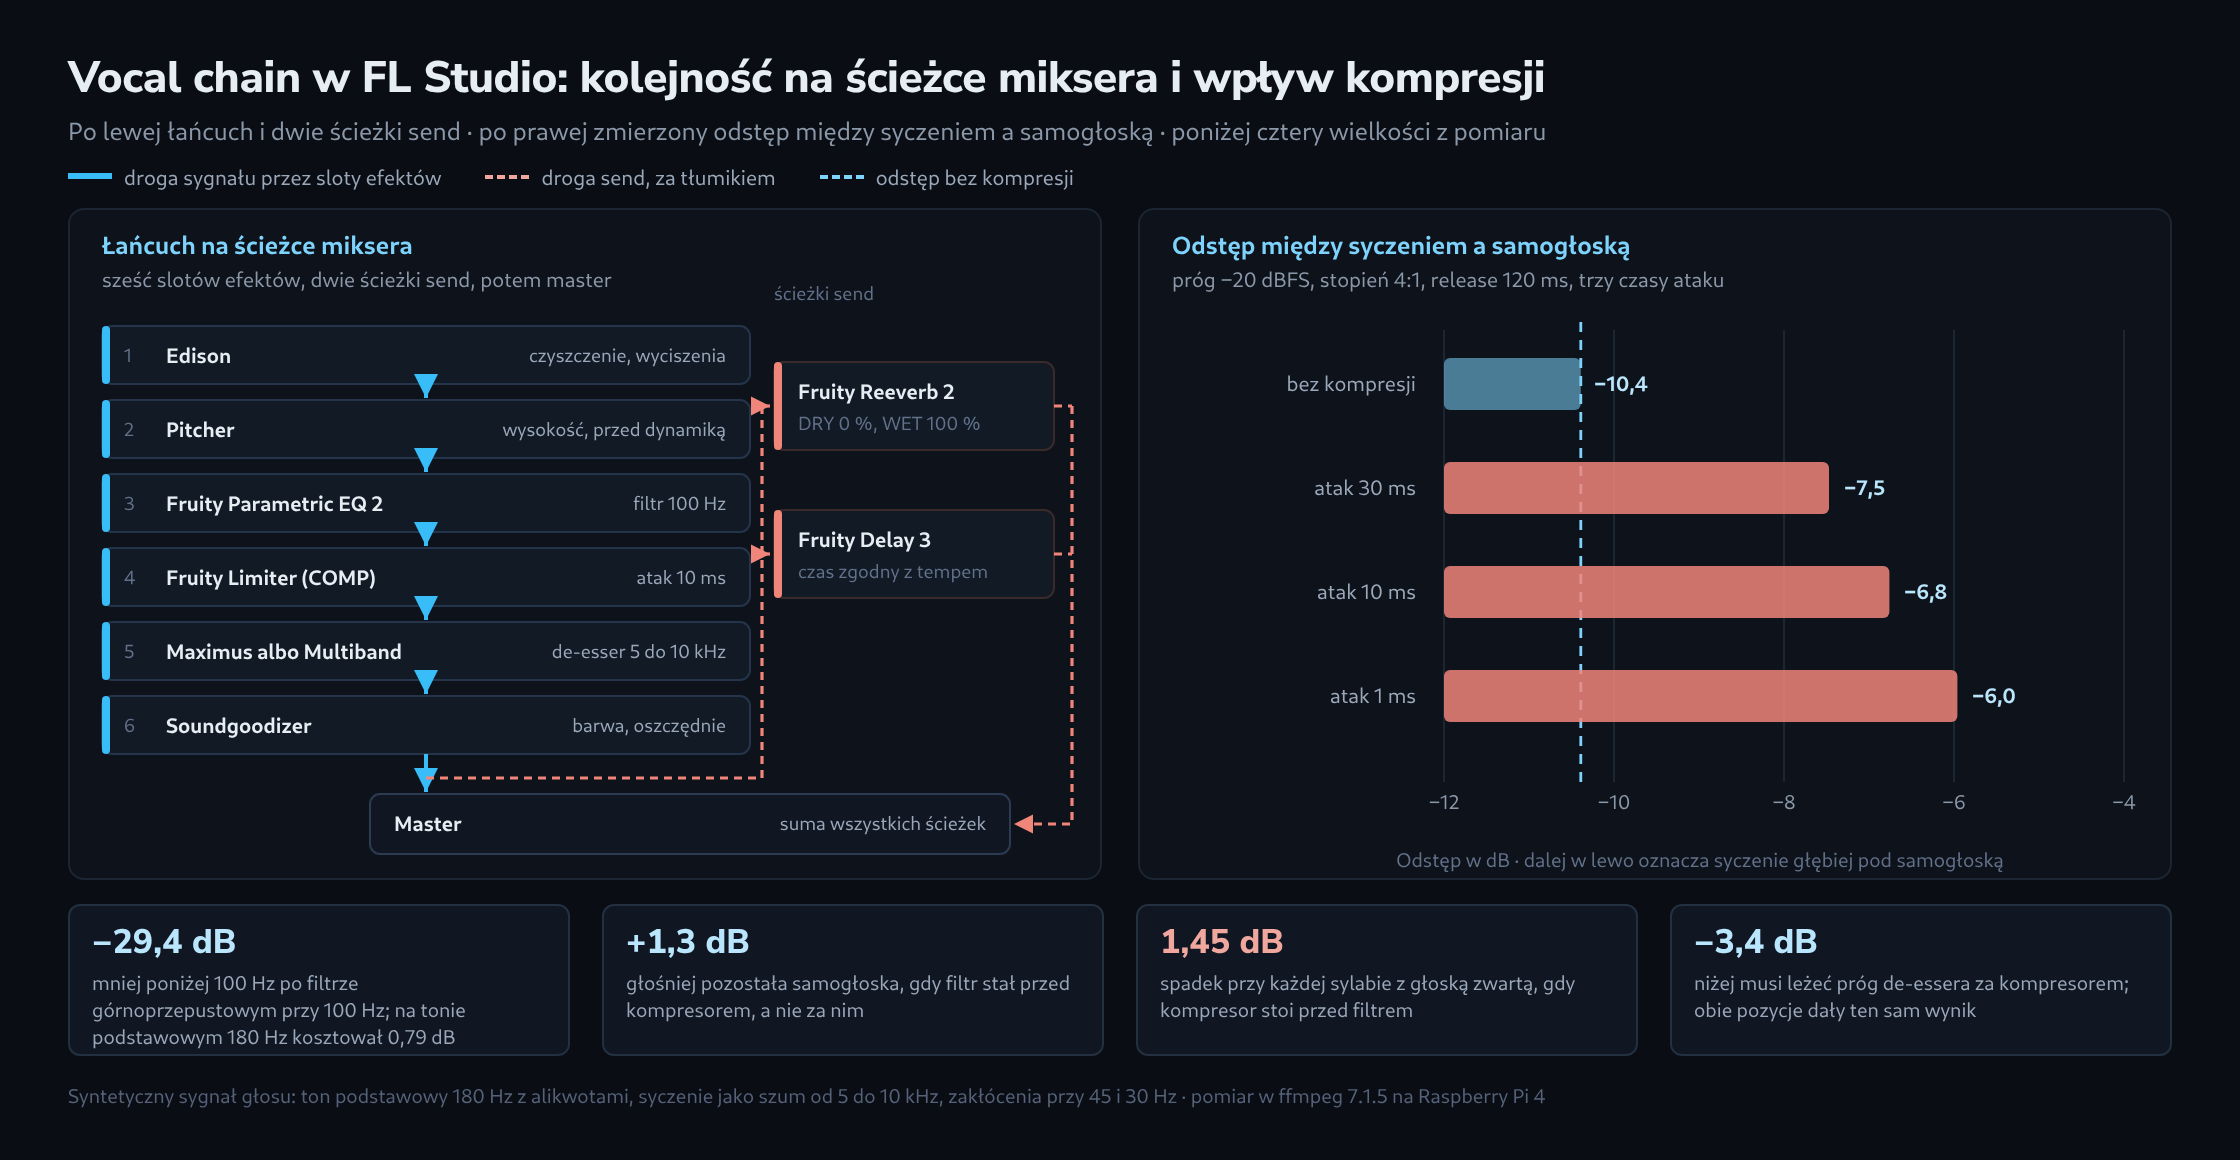
Jak wyglądał pomiar
- Sygnał: 24 sekundy przy 48 kHz. Co 500 ms jedna sylaba z 300 ms samogłoski i 120 ms syczenia. Samogłoska składa się z tonu podstawowego 180 Hz z alikwotami do 5 kHz i osiąga w szczycie −12 dBFS, syczenie to szum między 5 a 10 kHz przy −18 dBFS. Do tego dochodzą dwa zakłócenia: ton ciągły 45 Hz przy −20 dBFS oraz co 2 sekundy głoska zwarta przy 30 Hz. Razem szczyt leży przy −1,86 dBFS.
- Łańcuch: ffmpeg 7.1.5. Filtr górnoprzepustowy jako dwa biquady szeregowo, razem 24 dB na oktawę. Kompresor z progiem −20 dBFS, stopniem 4:1, kolanem 6 dB, release 120 ms, detekcją po wartości skutecznej i bez makeup gain. De-esser jako dynamiczny korektor przy 7 kHz z dobrocią 1,4, stopniem 4:1 i atakiem 1 ms.
- Ocena: filtry pasmowe w transformacie Fouriera. Poziom samogłoski to wartość skuteczna między 150 Hz a 4 kHz w oknie od 50 do 280 ms każdej sylaby, poziom syczenia to wartość między 5 a 10 kHz w oknie od 310 do 410 ms, obie uśrednione po 48 sylabach. Głośność pochodzi z ffmpeg według ITU-R BS.1770.
- Zasięg wniosków: kompresor w ffmpeg to nie Fruity Limiter, a sygnał syntetyczny to nie zaśpiewany głos. Liczby pokazują kierunek i rząd wielkości działania kolejności, a nie brzmienie konkretnej wtyczki.
Krok 1: własna ścieżka miksera, poziom nagrania i czyszczenie
Podręcznik podaje dla miksera 500 ścieżek insert po dziesięć slotów efektów każda. Wokal dostaje jedną z nich, żeby łańcuch i ścieżki send pozostały niezależne od innych ścieżek. Poziom nagrania spokojnie może zostawić zapas: szczyty w okolicy −12 do −6 dBFS w zupełności wystarczą przy 24 bitach, a im większy odstęp od pełnego wysterowania, tym mniej kłopotu sprawiają głoski zwarte. Jak mały może być bufor podczas śpiewania, wylicza kalkulator opóźnienia i bufora.
Edison ładuje się według podręcznika do dowolnego slotu efektu i nagrywa albo odtwarza dźwięk dokładnie z tego miejsca. To czyni go pierwszym krokiem łańcucha: pozycja „Clean up (Denoise / Declip / Declick)” otwiera narzędzie do naprawy nagrań zaszumionych, przesterowanych i trzeszczących, a wyciszenia na początku i końcu usuwają prawym przyciskiem dodatkowo trzaski. To, co zostanie tu naprawione, nie wymaga później prostowania kompresorem.
Krok 2: wysokość dźwięku przed dynamiką
Pitcher koryguje wysokość do wybranej tonacji i skali; dźwięki spoza skali przesuwają się według podręcznika do najbliższego stopnia w skali. Szybkość korekty decyduje o charakterze, ustawienia szybkie brzmią bardziej sztucznie, a wolniejsze naturalniej. Regulator formantu utrzymuje barwę, gdy wysokość się zmienia. W trybie MIDI klawiatura albo Piano Roll wyznacza dźwięki docelowe, a tryb „Harmonize” dokłada kolejne głosy. Pitcher należy według podręcznika do pakietu Signature Bundle i wyżej albo jest dostępny osobno.
Korekta wysokości stoi przed dynamiką, ponieważ kompresor podnosi także jej skutki uboczne: im mocniej ciche miejsca zostaną później podniesione, tym wyraźniej wychodzą artefakty, które przed kompresją ledwo rzucają się w uszy. Sama korekta z kolei nie potrzebuje zagęszczonego wejścia.
Krok 3: filtr górnoprzepustowy w Fruity Parametric EQ 2
Fruity Parametric EQ 2 ma siedem pasm, które pracują między innymi jako górnoprzepustowe, dolnoprzepustowe, półkowe albo dzwonowe; nachylenie zbocza sięga według podręcznika od 12 do 48 dB na oktawę. Domyślnym kształtem pasma jest dzwon. Tryb liniowej fazy pracuje na szybkiej transformacie Fouriera i podnosi przy tym opóźnienie wtyczki, podczas gdy tryb standardowy liczy niemal natychmiast; dla łańcucha pracującego podczas śpiewania właściwy jest tryb standardowy.
Pierwsze pasmo staje się filtrem górnoprzepustowym. Pomiar pokazuje, co różne częstotliwości graniczne robią z sygnałem testowym przy nachyleniu 24 dB na oktawę:
| Filtr | Zakłócenie, 10 do 100 Hz | Ton podstawowy, 150 do 250 Hz | Poziom szczytowy |
|---|---|---|---|
| brak | −20,91 dBFS | −23,96 dBFS | −1,86 dBFS |
| 60 Hz | −34,85 dBFS | −24,06 dBFS | −10,87 dBFS |
| 80 Hz | −43,17 dBFS | −24,29 dBFS | −10,47 dBFS |
| 100 Hz | −50,29 dBFS | −24,75 dBFS | −10,70 dBFS |
| 120 Hz | −56,31 dBFS | −25,53 dBFS | −11,32 dBFS |
| 150 Hz | −63,86 dBFS | −27,38 dBFS | −12,78 dBFS |
Przy 100 Hz zakłócenie leżało 29,38 dB niżej niż bez filtru, a ton podstawowy stracił 0,79 dB. Przy 150 Hz było to 42,95 dB mniej zakłócenia, ale już 3,42 dB mniej tonu podstawowego, co przy głosie z tonem podstawowym 180 Hz jest stratą zbyt dużą. Uwagę zwraca poziom szczytowy: już filtr przy 60 Hz zabrał nagraniu 9 dB szczytu, bo to głoska zwarta przy 30 Hz dawała największe wychylenia. Te 9 dB to zapas, który reszta łańcucha może wykorzystać.
Jako punkt wyjścia sprawdza się częstotliwość graniczna pół oktawy poniżej najniższego tonu podstawowego głosu. Dla 180 Hz sygnału testowego to około 120 Hz; pomiar przyjmuje 100 Hz, żeby zostawić rezerwę. Głosy niższe wymagają odpowiednio niższej granicy.
Filtr górnoprzepustowy należy przed kompresor
Kompresor reaguje na cały poziom, nie tylko na głos. Gdy stoi przed filtrem, jego redukcję wzmocnienia sterują także buczenie i głoski zwarte. Obie kolejności przy poza tym identycznych ustawieniach dały:
| Kolejność | Poziom samogłoski | Głośność | Poziom szczytowy | Spadek przy sylabach z głoską zwartą |
|---|---|---|---|---|
| Filtr, potem kompresor | −23,72 dBFS | −25,8 LUFS | −13,61 dBFS | 0,01 dB |
| Kompresor, potem filtr | −25,06 dBFS | −27,1 LUFS | −14,16 dBFS | 1,45 dB |
Z filtrem z przodu głos pozostał o 1,34 dB głośniejszy, a głośność o 1,3 LU wyższa, bez żadnej zmiany w ustawieniach kompresora. Ważniejsza od poziomu jest ostatnia kolumna: z kompresorem z przodu każda sylaba z głoską zwartą była średnio o 1,45 dB cichsza od pozostałych sylab. Właśnie to słychać jako krótkie odepchnięcie głosu. Z filtrem z przodu efekt zniknął całkowicie.
Krok 4: kompresja w Fruity Limiter, zakładka COMP
Fruity Limiter ma dwie zakładki, LIMIT i COMP; regulatory kompresora leżą w zakładce COMP. THRESH ustala poziom, od którego kompresja zaczyna działać, RATIO siłę obniżenia powyżej progu, a KNEE to, czy przejście jest łagodne, czy ostre. ATT decyduje, jak szybko obwiednia reaguje na początek sygnału, i wyznacza zarazem podgląd limitera, co widać w opóźnieniu wtyczki. REL to czas powrotu; ustawiony zbyt krótko powoduje według podręcznika zniekształcenia. CURVE sięga od 1 dla reakcji natychmiastowej do 8 dla powolnej. SUSTAIN od 0 do 1000 ms wyznacza czas, przez jaki wejście jest uśredniane jako wartość skuteczna, i zapobiega przez to zbyt wczesnemu puszczeniu. GAIN działa jako makeup za kompresorem, a przed stopniem limitera.
Jako punkt wyjścia dla zaśpiewanego głosu: stopień 3:1 do 4:1, próg na tyle nisko, żeby głośne sylaby pokazywały 3 do 6 dB redukcji, atak około 10 ms, release około 120 ms. Czas ataku nie jest przy tym wyłącznie kwestią gustu, co pokazuje następny rozdział. Do duckingu względem innej ścieżki ta sama zakładka przyjmuje sygnał sidechain; droga sygnału stoi w poradniku o kompresji sidechain w FL Studio.
Krok 5: de-esser i wpływ kompresji na syczenie
Image-Line opisuje de-essery rzeczowo: większość dobrych de-esserów to po prostu kompresory ograniczone do pasma, pod inną nazwą. Jako narzędzia producent wymienia Fruity Multiband Compressor i Maximusa, a jako zakres syczenia 4000 do 12 000 Hz. Przewaga nad stałym obniżeniem w korektorze: kompresja z właściwym progiem i stopniem obniża syczenie tylko wtedy, gdy przekracza ono znośny poziom, podczas gdy korektor obniża te same częstotliwości na całej ścieżce i często czyni ją matową.
Maximus przynosi do tego preset „De-esser Split Band”. Według poradnika pasmo niskie i wysokie oraz master są w nim wyłączone, pasmo średnie pracuje z mocną kompresją i trzyma wejście przy około −6 dB, a wszystko poniżej przechodzi bez zmian. Dolna częstotliwość graniczna pasma średniego trafia na syczenie, PRE GAIN podnosi sygnał na tyle, żeby syczenie weszło w zakres kompresji, a POST GAIN zabiera tę samą wartość z powrotem. Fruity Multiband Compressor oferuje w zamian trzy pasma z czterema regulatorami częstotliwości granicznych, progi od 0 do −60 dB, stopnie od 1:1 do nieskończoności, atak od 0,1 do 100 ms, release od 10 do 1000 ms i wzmocnienie wyjściowe do 17 dB, a do tego przełączniki pasma na aktywne, wyciszone i pominięte.
Ciekawe jest to, co dzieje się przed de-esserem. Kompresja obniża głośne samogłoski mocniej niż cichsze syczenie i przesuwa przez to relację między nimi:
| Obróbka | Poziom samogłoski | Poziom syczenia | Odstęp | Zmiana |
|---|---|---|---|---|
| bez kompresji | −19,29 dBFS | −29,68 dBFS | −10,39 dB | odniesienie |
| atak 30 ms | −22,34 dBFS | −29,81 dBFS | −7,47 dB | +2,92 dB |
| atak 10 ms | −23,21 dBFS | −29,97 dBFS | −6,76 dB | +3,63 dB |
| atak 1 ms | −24,50 dBFS | −30,46 dBFS | −5,96 dB | +4,43 dB |
Samo syczenie straciło przez kompresję najwyżej 0,78 dB, a samogłoska nawet 5,21 dB. Syczenie zbliżyło się przez to do samogłoski o 2,92 dB przy powolnym ataku i o 4,43 dB przy bardzo szybkim. Szybki atak czyni więc głos nie tylko gęstszym, ale i ostrzejszym, i to w sposób mierzalny. Kto kompresuje głos i potem stwierdza, że syczy on bardziej niż przedtem, nie ulega złudzeniu, lecz ma przed sobą właśnie ten efekt.
Przed kompresorem czy za nim: decyduje próg, a nie miejsce
Z poprzedniego rozdziału wynikałoby, że de-esser musi koniecznie stać za kompresorem. Próba kontrolna pokazuje inny obraz. Próg de-essera został w niej ustawiony w obu pozycjach tak, żeby na końcu stał ten sam odstęp między syczeniem a samogłoską co w sygnale nieprzetworzonym, czyli −10,39 dB:
| Pozycja | Potrzebny próg | Końcowy poziom syczenia | Końcowy poziom samogłoski |
|---|---|---|---|
| De-esser przed kompresorem | −41,8 dB | −34,16 dBFS | −23,77 dBFS |
| De-esser za kompresorem | −45,2 dB | −34,24 dBFS | −23,85 dBFS |
Oba łańcuchy wylądowały z dokładnością do 0,09 dB na tym samym poziomie syczenia i z dokładnością do 0,08 dB na tym samym poziomie samogłoski. Różnica tkwi w drugiej kolumnie: za kompresorem próg musi leżeć 3,4 dB niżej, bo kompresor wcześniej obniża sygnał. Przesunięcie de-essera bez poprawienia progu sprawia więc, że ten sam regulator działa zupełnie inaczej. Przy niezmienionym progu i krótkim release 5 ms obie pozycje obniżyły syczenie o 15,19 i 15,32 dB, czyli szły równo; release 200 ms z kolei pociągnął samogłoskę w dół o 5,34 i 3,21 dB, bo obniżenie działało jeszcze w następnej sylabie.
Praktycznie wynika z tego: de-esser stoi za kompresorem, bo tam obrabia relację, która na końcu jest słyszalna. Jego release pozostaje krótki, rzędu 5 do 40 ms. A próg zawsze wymaga ustawienia w tym miejscu, w którym de-esser faktycznie siedzi, i nigdy przeniesienia z innego łańcucha.
Krok 6: nasycenie oszczędnie
Soundgoodizer to według podręcznika maximizer i enhancer oparty na silniku Maximusa. Jego duży regulator odpowiada miksowi LMH z Maximusa i przenika między wejściem a wyjściami trzech pasm kompresora; cztery presety od A do D to gotowe ustawienia Maximusa. Skoro wtyczka nie tylko barwi, ale i zagęszcza, jej miejsce jest na końcu łańcucha i w małych dawkach. Dla dokładniejszej kontroli te same ustawienia stoją otworem wprost w Maximusie.
Jednego punktu pomiar nie obejmuje: nasycenie tworzy nowe alikwoty, które mogą trafić w zakres syczenia. Ostatnia kontrola po ustawieniu nasycenia wraca więc do głosek „s”.
Pogłos i delay na ścieżkach send
Pogłos i delay nie należą do łańcucha ścieżki wokalu, lecz na własne ścieżki. Ścieżki insert dają się według podręcznika wysłać do dowolnie wielu innych ścieżek: najpierw wybór ścieżki źródłowej, potem przełącznik send na ścieżce docelowej; przełącznik zostaje przy tym zastąpiony regulatorem wysyłanej ilości. Wysyłki pracują za tłumikiem, a za odczep przed tłumikiem odpowiada wtyczka Fruity Send.
Na ścieżce pogłosu stoi Fruity Reeverb 2. Podręcznik podaje dla pracy na ścieżce send wprost DRY na 0 % i WET na 100 %. DELAY ustala czas między sygnałem bezpośrednim a pierwszym odbiciem, DEC czas zaniku do −60 dB, DIFF gęstość odbić, DAMP tłumienie wysokich tonów w pogłosie, L.CUT i H.CUT wycinają zakresy z pogłosu, a SEP reguluje szerokość stereo sygnału mokrego.
Na ścieżce delaya stoi Fruity Delay 3. Opóźnienie sięga od 1 do 1000 ms, a przy synchronizacji z tempem od jednej czterdziestej ósmej kroku do 16 kroków, czyli jednego taktu; echa podążają wtedy także za automatyką tempa. Do wyboru są cztery modele: mono, stereo, ping pong i wyłączony. Właściwy czas w milisekundach przelicza kalkulator BPM i delaya.
Gotowy łańcuch w kolejności slotów
| Slot | Wtyczka | Zadanie | Punkt wyjścia |
|---|---|---|---|
| 1 | Edison | czyszczenie, wyciszenia, szum | clean up tylko w razie potrzeby |
| 2 | Pitcher | wysokość dźwięku | ustawiona tonacja, wolna korekta |
| 3 | Fruity Parametric EQ 2 | filtr górnoprzepustowy i cięcia | filtr 100 Hz, 24 dB na oktawę |
| 4 | Fruity Limiter, zakładka COMP | kompresja | 4:1, atak 10 ms, release 120 ms |
| 5 | Maximus albo Fruity Multiband Compressor | de-esser | pasmo 5 do 10 kHz, release poniżej 40 ms |
| 6 | Soundgoodizer | nasycenie | preset A, regulator daleko w lewo |
| Send 1 | Fruity Reeverb 2 | przestrzeń | DRY 0 %, WET 100 % |
| Send 2 | Fruity Delay 3 | echo | synchronizacja z tempem, ping pong |
Po łańcuchu: szyna i głośność
Kilka ścieżek wokalnych sensownie schodzi się na wspólnej ścieżce, na której stoi kolejny, bardzo łagodny kompresor. Od tego miejsca obowiązują reguły masteringu: miernik LUFS i true peak pokazuje, gdzie stoi głośność, narzędzie do korelacji stereo i mid/side sprawdza, czy głos naprawdę stoi w środku, a poradnik o masteringu do głośności streamingowej opisuje drogę do gotowego pliku.
Zakres i granice
- Pomiar powstał w ffmpeg, a nie na wtyczkach FL. Regulatory o tych samych nazwach zachowują się tam inaczej, a Maximus pracuje z dowolnie kształtowaną charakterystyką, której żaden prosty kompresor nie odtwarza.
- Sygnał testowy jest syntetyczny: równe sylaby, brak przestrzeni, brak oddechów, brak vibrata. Prawdziwe nagranie waha się mocniej, przez co skutki kolejności mogą wypaść większe.
- Liczby dotyczące filtru zależą od tonu podstawowego 180 Hz. Dla głosów niższych wartości przesuwają się odpowiednio w dół.
- Jedna obserwacja pozostała bez wyjaśnienia: przy niezmienionym progu i release 40 ms ten sam de-esser obniżył przed kompresorem 19,40 dB, a za nim 5,15 dB, podczas gdy przy 5 ms pracował w obu pozycjach tak samo mocno. Wartość jest odnotowana, lecz niewyjaśniona; wspiera zalecenie, by próg zawsze powstawał w ostatecznym łańcuchu.
- Dane o wtyczkach pochodzą z podręcznika Image-Line i nie zostały zmierzone.
Pytania i odpowiedzi
Dlaczego głoska zwarta ścisza całą sylabę, skoro filtr górnoprzepustowy usuwa ją później?
Bo kompresor reaguje na poziom, który widzi, a głoska zwarta daje tam największe wychylenia. Podbija ona redukcję wzmocnienia, która przy release 120 ms ustępuje tylko stopniowo; w to okno czasowe wpada samogłoska tej samej sylaby. Filtr za kompresorem usuwa wprawdzie głoskę zwartą, ale obniżenie samogłoski zostaje w sygnale, średnio 1,45 dB.
Czy kompresor na szynie wokalnej z powrotem podnosi syczenie?
Działa w tym samym kierunku co kompresor na pojedynczej ścieżce, przy łagodnym ustawieniu tylko słabiej. Pomiar pokazuje mechanizm: kompresja obniżyła samogłoskę o 3,05 do 5,21 dB, a cichsze syczenie tylko o 0,13 do 0,78 dB. Odstęp między nimi zmniejszył się więc o większą część wartości, o którą obniżono samogłoskę. Według tej samej logiki, choć bez pomiaru, kompresor na szynie obniżający głośne sylaby o 1 do 2 dB przybliża syczenie do samogłoski o podobną wartość, i to za de-esserem, który wcześniej ustawił jego poziom.
Wynikają z tego dwie rzeczy. Po pierwsze, zasada z artykułu, by ustawiać próg tam, gdzie de-esser faktycznie siedzi, dotyczy także szyny: ostatnia kontrola głosek „s” odbywa się przy włączonym kompresorze na szynie, a nie na pojedynczej ścieżce. Po drugie, przy kilku głosach dodatkowy de-esser na szynie bywa lepszym wyborem niż ostrzejsze ustawienie każdej ścieżki z osobna, bo sumuje się tam syczenie głosów śpiewających jednocześnie.
Które kroki łańcucha opóźniają sygnał podczas nagrywania wokalu?
Według artykułu dwa z opisanych ustawień: tryb liniowej fazy w Fruity Parametric EQ 2, który pracuje na szybkiej transformacie Fouriera, oraz czas ataku w Fruity Limiter, wyznaczający zarazem jego podgląd. Oba dokładają się do opóźnienia bufora interfejsu audio.
Kompensacja opóźnień potrafi wyrównać odtwarzanie pozostałych ścieżek względem takich wtyczek, ale przy odsłuchu w trakcie nagrania opóźnienia nie da się odzyskać: głos dociera do słuchawek później. Do nagrywania wystarcza więc oszczędny łańcuch z korektorem w trybie standardowym; pozostałe ustawienia da się włączyć z powrotem po nagraniu.
Źródła
- Image-Line: FL Studio Manual, Mixer: 500 ścieżek insert, dziesięć slotów efektów, przełącznik i regulator send, wysyłki za tłumikiem, Fruity Send do odczepu przed nim.
- Image-Line: Fruity Parametric EQ 2: siedem pasm, typy filtrów, nachylenie od 12 do 48 dB na oktawę, tryb liniowej fazy z wyższym opóźnieniem.
- Image-Line: Fruity Limiter: zakładki LIMIT i COMP, THRESH, RATIO, KNEE, ATT z podglądem, REL, CURVE 1 do 8, SUSTAIN 0 do 1000 ms, GAIN jako makeup.
- Image-Line: De-Essing Options in FL Studio: de-essery jako kompresory ograniczone do pasma, syczenie między 4000 a 12 000 Hz, kompresja kontra stałe obniżenie.
- Image-Line: Maximus Tutorials: preset „De-esser Split Band”, aktywne tylko pasmo średnie, PRE GAIN i POST GAIN przeciwbieżnie.
- Image-Line: Fruity Multiband Compressor: trzy pasma, cztery regulatory częstotliwości granicznych, próg 0 do −60 dB, atak 0,1 do 100 ms, release 10 do 1000 ms.
- Image-Line: Fruity Reeverb 2: DELAY, DEC do −60 dB, DIFF, DAMP, L.CUT, H.CUT, SEP, DRY 0 % i WET 100 % na ścieżce send.
- Image-Line: Fruity Delay 3: 1 do 1000 ms, synchronizacja z tempem od jednej czterdziestej ósmej kroku do 16 kroków, modele mono, stereo i ping pong.
- Image-Line: Pitcher: tonacja i skala, szybkość korekty, formant, tryb MIDI z Harmonize, Signature Bundle i wyżej.
- Image-Line: Soundgoodizer: maximizer i enhancer oparty na silniku Maximusa, regulator jako miks LMH, presety od A do D.
- Image-Line: Edison: ładuje się do slotu efektu i nagrywa z tego miejsca; clean up na szum, przesterowanie i trzaski, wyciszenia z usuwaniem trzasków.
Powiązane artykuły