English
 Polski
Porównanie dostępnych modeli LLM: Qwen, Gemma, Ministral, Llama i DeepSeek w DE, EN i PL

Spis treści
Dostępny model językowy staje się użytecznym rozwiązaniem lokalnym dopiero po dopasowaniu zadania, języka i sprzętu. Wysoki ogólny wynik benchmarku nie określa jakości polszczyzny ani pamięci dla konkretnej kwantyzacji. Porównanie potrzebuje więc kilku osi zamiast jednej listy najlepszych modeli.
Zestaw obejmuje udokumentowane rodziny i konkretne kandydatury. Nie przedstawia własnego benchmarku jakości. Dostęp do pobrania, licencja i wymagania wykonania są oceniane osobno.
Klasy kandydatów
| Kandydat | Sensowne porównanie | Szczególna kontrola |
|---|---|---|
| Qwen3.5-9B | Mały asystent ogólny | Architektura hybrydowa i backend |
| Gemma 4 Instruct | Odpowiednia klasa wielkości i multimodalność | Konkretna wersja zamiast rodziny |
| Ministral 3 8B/14B | Czat lokalny i wynik strukturalny | Precyzja artefaktu i test języka |
| Llama 3.3 70B Instruct | Większy model referencyjny | Wagi, kontekst i licencja |
| DeepSeek-R1-Distill | Rozumowanie w odpowiedniej klasie | Model bazowy i długość wyniku |
Dostępność nie opisuje wszystkiego
Wagi dostępne do pobrania mogą nadal podlegać szczególnym warunkom użycia. Znaczenie mają konkretna karta modelu i dołączona licencja. Wersje pochodne mogą dziedziczyć warunki modelu bazowego. Sama nazwa repozytorium nie rozstrzyga tej oceny.
Qwen3.5-9B i wybrany wpis Ministral 3 14B Instruct wskazują Apache 2.0. Nie oznacza to takiej samej licencji dla innych rodzin i starszych generacji. Wersje bazowe, Instruct i Reasoning różnią się także mimo podobnych nazw.
DE, EN i PL wymagają osobnych wyników
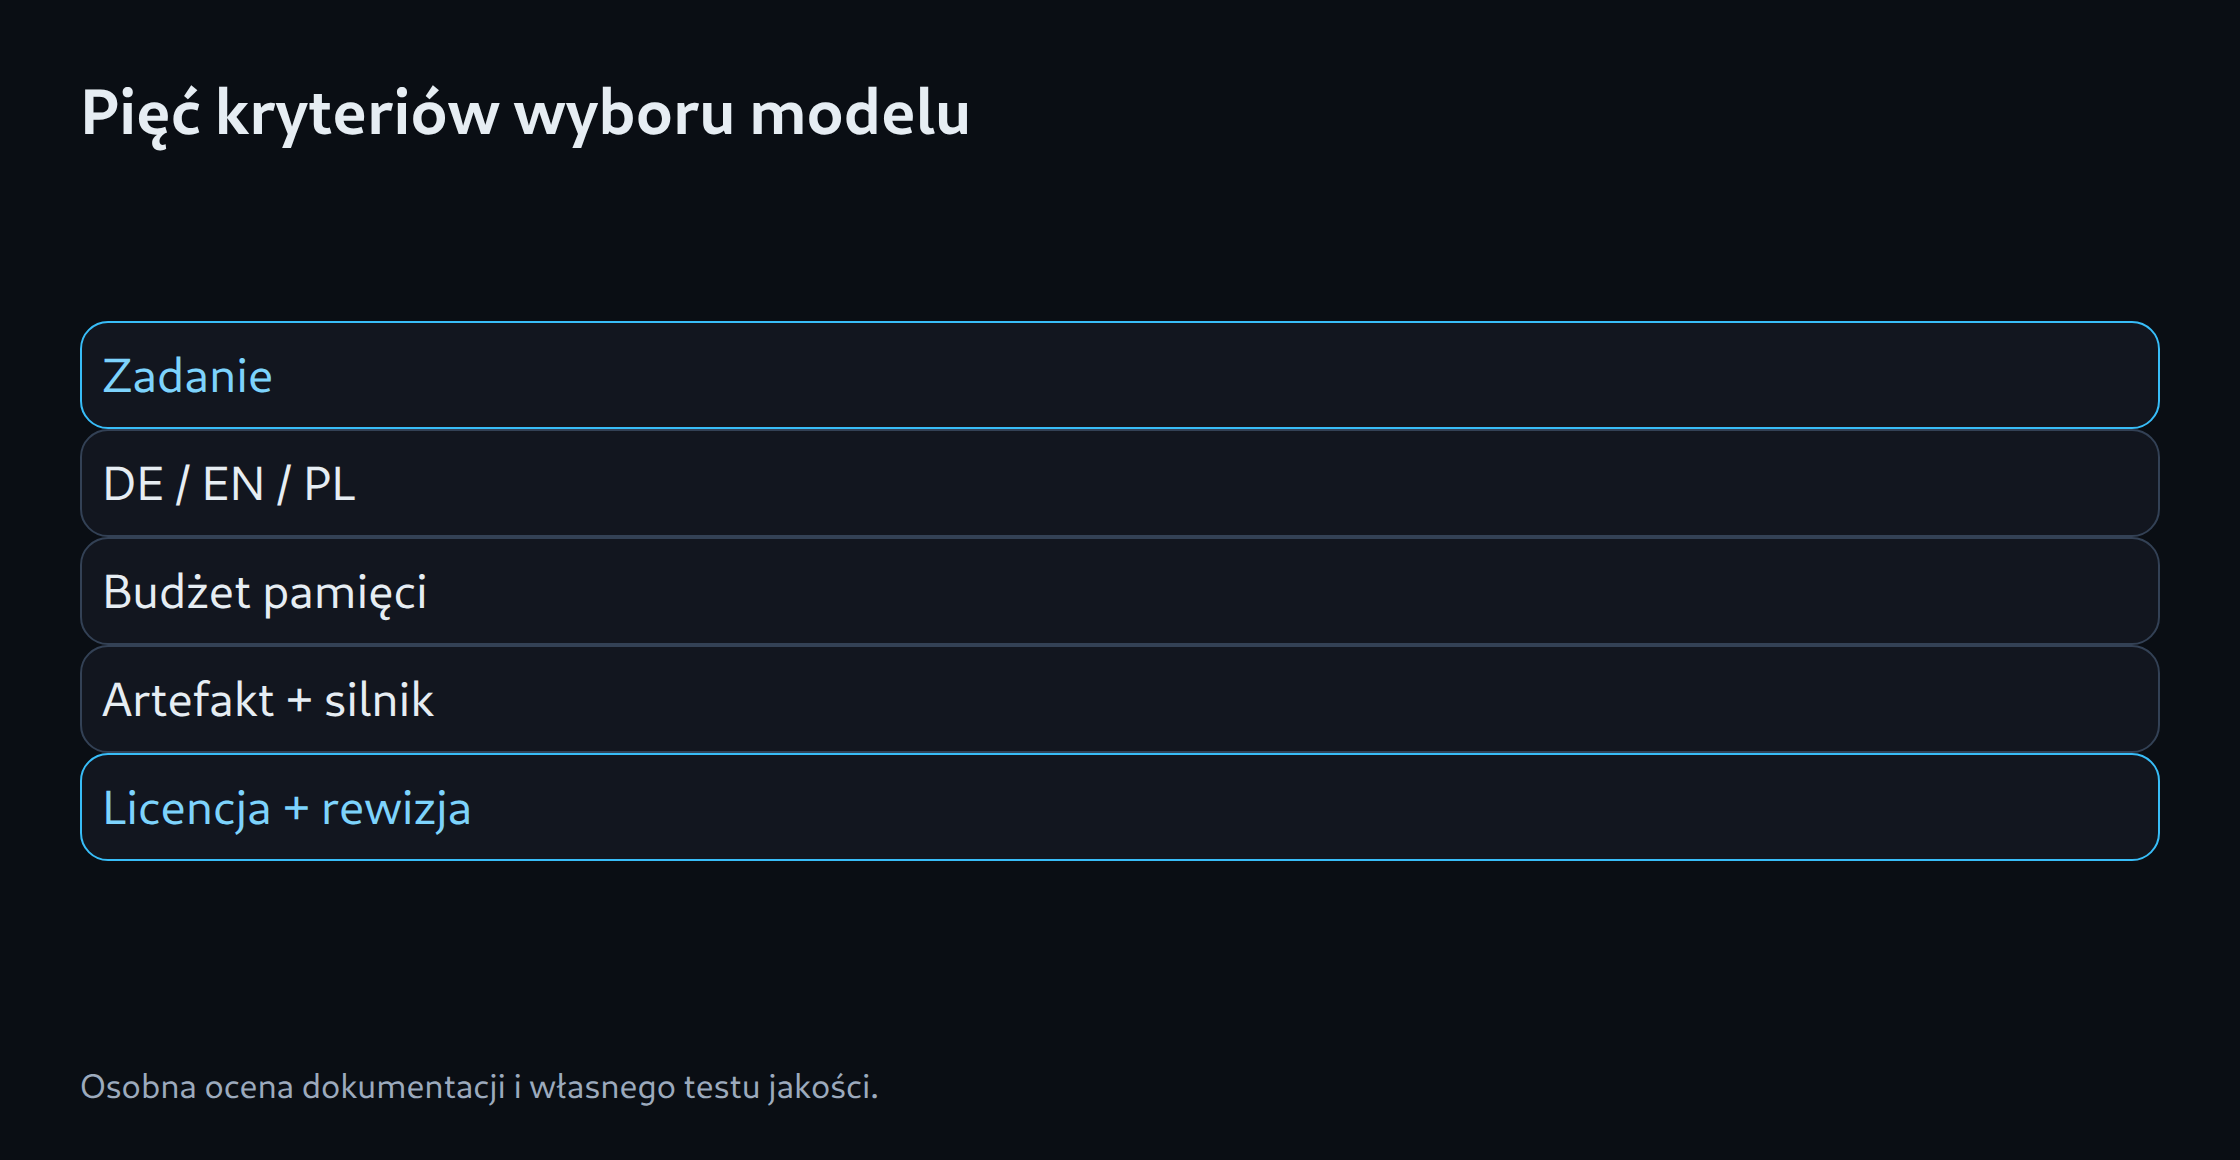
Przydatny zestaw zadań obejmuje streszczenie, korektę tekstu, ekstrakcję JSON, analizę kodu i odpowiedzi oparte na dostarczonym dokumencie. Równoważna treść powinna być naturalnie sformułowana w trzech językach. Ocena zlicza błędy rzeczowe, pominięcia, naruszenia formatu i nieuzasadnione dodatki.
Przetłumaczony benchmark angielski nie zastępuje oceny polszczyzny. Lista obsługiwanych języków od producenta również nie potwierdza jednakowej jakości. Nazwy własne, fleksja i neutralny styl mogą ujawniać odrębne błędy. Osobne kolumny wyników zachowują te różnice.
Osobne porównanie klasy i budżetu pamięci
Pierwsza grupa utrzymuje podobną klasę modelu. Druga zachowuje ten sam dostępny budżet pamięci. Takie podejście pozwala porównać mniejszy model z wyższą precyzją z większym modelem po silniejszej kwantyzacji dla konkretnego zadania.
Aktywne parametry opisują tylko część wymagań modelu MoE. Dla pojemności nadal istotne są wszystkie wagi. Llama 4 Scout i duże aktualne modele DeepSeek nie stają się małymi modelami komputerowymi wyłącznie dzięki niższej liczbie aktywnych parametrów. Przenoszenie części danych poza GPU dodatkowo zmienia czas odpowiedzi.
Powtarzalna krótka lista
Każdy wynik wymaga identyfikatora modelu, rewizji, kwantyzacji, środowiska, kontekstu, szablonu czatu i próbkowania. Wyniki rozumowania potrzebują także zapisanego limitu generowania. Inaczej porównanie czasu może mierzyć wyłącznie dłuższe odpowiedzi. Obrazy wymagają osobnego testu.
Istniejący kalkulator pamięci pomaga we wstępnym wyborze. Następnie potrzebny jest mały test lokalny ze sprawdzalnymi oczekiwanymi odpowiedziami. Dopiero wtedy powstaje uzasadniona lista dla niemieckiego, angielskiego lub polskiego. Uniwersalny ranking wszystkich dostępnych modeli byłby zbyt ogólny.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy swobodny dostęp automatycznie oznacza brak ograniczeń użycia?
Dostęp do pobrania i warunki użycia to odrębne kwestie. Zakres dozwolonego użycia określają licencja i warunki konkretnego modelu lub wersji pochodnej.
Czy model z największą liczbą parametrów jest automatycznie najlepszy dla polskiego?
Liczba parametrów i ogólne benchmarki nie zastępują testu zadań w języku polskim. Jakość językowa, częstość błędów i budżet obliczeniowy wymagają wspólnej oceny. Kwantyzacja i szablon czatu również mogą wpływać na wyniki.
Źródła
- Qwen: Qwen3.5-9B, offizielle Model Card
- Google DeepMind: Gemma 4
- Google: Gemma 4 31B, offizielle Model Card
- Mistral: Ministral 3 14B Instruct, offizielle Model Card
- Meta: Llama 3.3 70B Instruct, offizielle Model Card
- Meta: Llama 4 Scout, offizielle Model Card
- DeepSeek: R1 und Distill-Modelle
Źródła sprawdzone: 5 października 2026.
Powiązane artykuły