English
 Deutsch
 Polski
Prometheus na Raspberry Pi: jak etykiety mnożą szeregi czasowe i jak znaleźć winowajcę

Spis treści
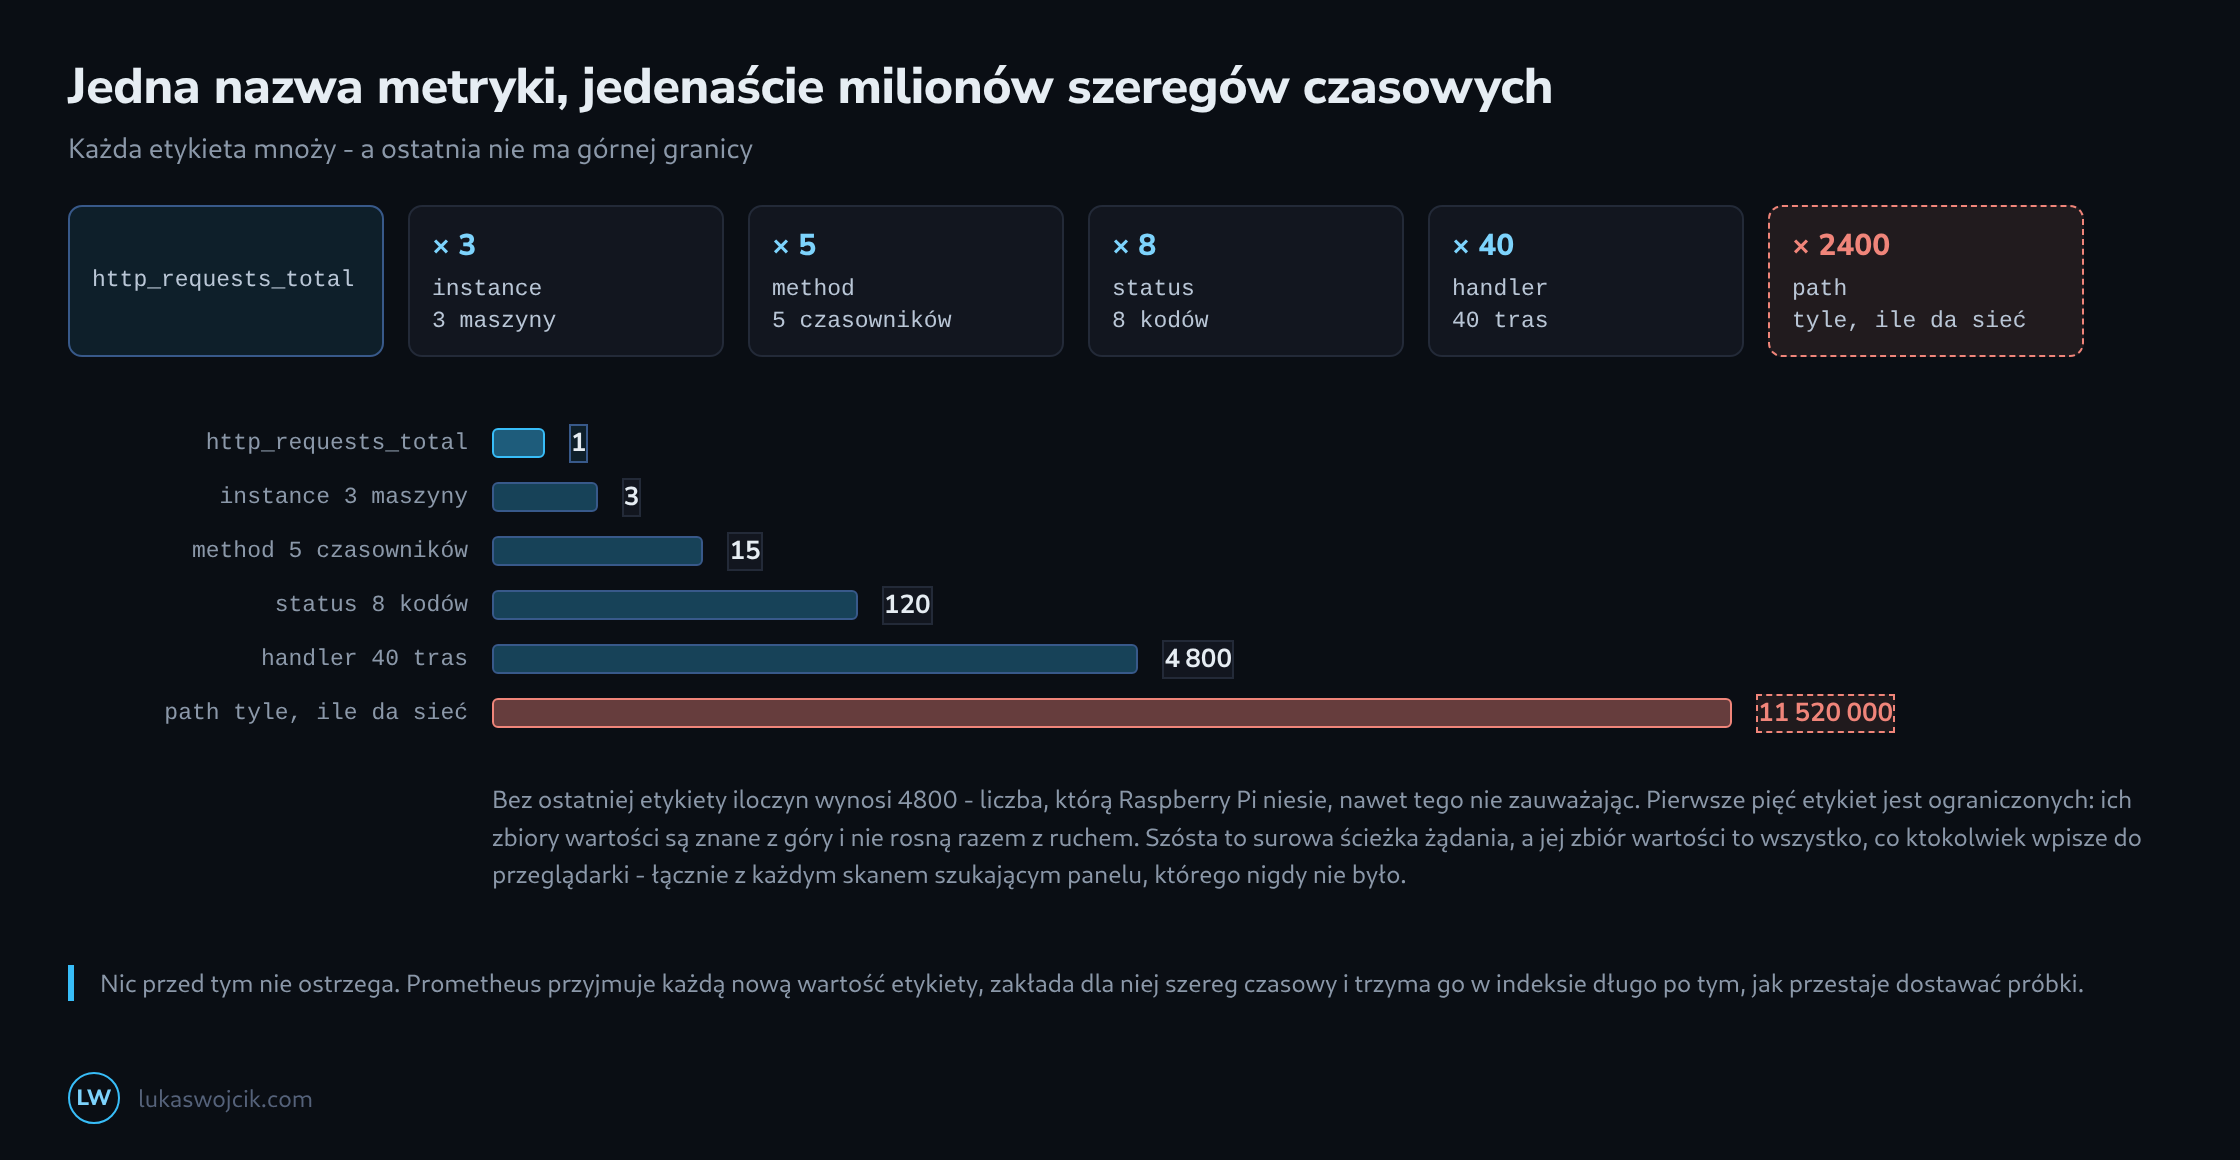
Raspberry Pi z Prometheusem wymiaruje się zwykle liczbą eksporterów, a to zła jednostka. Prometheus nie przechowuje metryk; przechowuje jeden szereg czasowy na każdą odrębną kombinację wartości etykiet, a liczba tych kombinacji jest iloczynem.
Iloczyn zachowuje się inaczej niż suma. Szósty eksporter dokłada kilkaset szeregów. Szósta etykieta przy istniejącej metryce zwielokrotnia wszystko, co już było.
Etykiety ograniczone i nieograniczone
Użyteczne rozróżnienie nie dotyczy tego, ile wartości ma etykieta dzisiaj, tylko tego, czy jej zbiór wartości jest znany z góry. method ma pięć wartości i za rok też będzie miała pięć. status ma tuzin. instance rośnie, gdy dochodzi maszyna – a o tym ktoś decyduje.
Surowa ścieżka żądania ma tyle wartości, ile jest napisów, i rośnie najszybciej wtedy, gdy witryna jest atakowana: każdy skan szukający /wp-admin, /.env i /phpmyadmin zakłada trwały szereg czasowy – w monitoringu obserwującym witrynę, która tych stron w ogóle nie ma.
| Etykieta | Wartości | Ograniczona przez |
|---|---|---|
job, instance |
garstka | istniejące maszyny |
method, status |
5 do 12 | specyfikację HTTP |
handler, route |
dziesiątki | trasy w programie |
path (surowa) |
nieograniczona | nic – rośnie razem ze skanerami |
user_id, email |
nieograniczona | nic, i nie należy do żadnego monitoringu |
container_id, pod |
nieograniczona w czasie | nic – nowa wartość przy każdym wdrożeniu |
Ostatni wiersz jest podstępny, bo liczba szeregów żyjących w danej chwili pozostaje mała. Nieograniczenie rośnie indeks, który musi pamiętać każdy szereg, jaki kiedykolwiek istniał w okresie przechowywania. Wdrożenie co godzinę ze świeżym identyfikatorem kontenera daje monitoring, który z tygodnia na tydzień jest wolniejszy, podczas gdy panel nie pokazuje niczego niezwykłego.
Ile to kosztuje w praktyce
Pamięć jest granicą wiążącą na długo przed dyskiem. Blok główny trzyma każdy aktywny szereg wraz z indeksem w pamięci, rzędu kilku kilobajtów na szereg, a zapytanie po wielu szeregach potrzebuje miejsca ponadto.
Awaria nie przychodzi stopniowo. Prometheus rośnie, aż jądro go sprzątnie, startuje od nowa, odtwarza dziennik zapisu, rośnie znowu i znowu zostaje sprzątnięty – zwykle w ciągu minut od pierwszego większego zapytania panelu. To, co wygląda na zepsuty eksporter, jest metryką, która trzy wdrożenia temu dostała etykietę.
Trzy zapytania, które to znajdują
# które nazwy metryk niosą najwięcej szeregów
topk(10, count by (__name__)({__name__=~".+"}))

# ile różnych wartości ma etykieta, dla jednej metryki
count(count by (path) (http_requests_total))

# szeregi w bloku głównym łącznie i jak szybko rosną
prometheus_tsdb_head_series
delta(prometheus_tsdb_head_series[1h])
Pierwsze zapytanie nazywa metrykę, drugie etykietę, a trzecie mówi, czy problem jest rozmiarem, czy wyciekiem. Liczba szeregów w bloku głównym rosnąca stale, choć nic się nie dokłada, to fluktuacja – a fluktuacja to zawsze etykieta zmieniająca się wbrew temu, co powinna.
Warto puścić te zapytania raz na zdrowej instalacji, choćby po to, by wiedzieć, jak wygląda stan normalny. Liczba bez odniesienia nie jest diagnozą.
Usunięcie etykiety to jeden wiersz
Najtańsze zaradzenie działa przy odpytywaniu, zanim cokolwiek zostanie zapisane. Blok metric_relabel_configs usuwa etykietę z napływających próbek, a wszystko dalsze kurczy się o czynnik, który ta etykieta wnosiła.
scrape_configs:
  - job_name: 'app'
    static_configs:
      - targets: ['app:9100']
    metric_relabel_configs:
      - regex: 'path|user_id|container_id'
        action: labeldrop
Usunięcie to nie to samo co zagregowanie: szeregi poszczególnych ścieżek znikają, a liczniki, które trzymały, wtapiają się w szeregi pozostałe. Zwykle i tak o to chodziło – mało kto ogląda liczbę żądań na ścieżkę, a kto ogląda, chce ją pogrupowaną po trasie, a nie po adresie.
Gdzie szczegół naprawdę się liczy, odpowiedzią jest ograniczenie go u źródła: etykietować po handler albo po znormalizowanym szablonie trasy zamiast po surowej ścieżce, żeby z /produkt/12345 i /produkt/12346 powstał jeden szereg zamiast dwóch.
Reguła dla nowych metryk
Zanim dojdzie etykieta, warto zapytać, jaki ma zbiór wartości i kto o nim rozstrzyga. Jeśli odpowiedź wskazuje człowieka albo plik konfiguracyjny, etykieta jest ograniczona. Jeśli wskazuje odwiedzającego, żądanie albo identyfikator – nie jest, a dowiadujemy się o tym później, od Pi, na którym Prometheus już nie wstaje.
To samo pytanie rozstrzyga przy okazji stronę ochrony danych, bo etykiety nieograniczone to dokładnie te, które oznaczają osoby. Adres e-mail w etykiecie metryki jest jednym tchem problemem kardynalności i problemem ochrony danych, a oba rozwiązuje niewpisywanie go tam.
Pytania i odpowiedzi
Czy krótszy okres przechowywania pomaga przy braku pamięci?
Tylko na część problemu. Blok główny w pamięci obejmuje jedynie ostatnie dwie do trzech godzin, niezależnie od tego, czy okres przechowywania wynosi dwa tygodnie, czy rok; krótszy okres ogranicza jednak to, jak bardzo fluktuacja powiększa indeks starszych bloków, a przez to przyspiesza zapytania obejmujące długie okresy. Z tego samego powodu prometheus_tsdb_head_series nie spada zaraz po labeldrop, lecz dopiero wtedy, gdy stare szeregi wypadną z bloku głównego przy jednej z kolejnych kompakcji.
Co chroni przed tym, by nowa etykieta ponownie unieruchomiła Pi?
Chronią przed tym trzy zabezpieczenia, które działają w różnych miejscach. Żadne z nich nie zastępuje pytania z artykułu, zadawanego przed każdą nową etykietą, ale razem sprawiają, że przeoczona odpowiedź kosztuje jedno zadanie (job), a nie całą maszynę.
sample_limitdla każdego zadania. Jeśli cel pometric_relabel_configsdostarcza więcej próbek, niż wolno, Prometheus odrzuca całe odpytanie i ustawia dla tego celuupna 0. Z pełzającej śmierci z braku pamięci robi się w ten sposób widocznie niedostępny cel, a pozostałe zadania działają dalej. Punktem odniesienia dla limitu jestscrape_samples_post_metric_relabeling, zapisywane przez Prometheusa samodzielnie dla każdego celu, z dużym zapasem ponad dzisiejszą wartość.- Reguła alarmowa na przyrost. Zapytanie
delta(prometheus_tsdb_head_series[1h])z artykułu, opatrzone progiem, zgłasza wyciek, zanim pamięci zacznie brakować. - Limit pamięci dla kontenera. Jeśli Prometheus działa w Dockerze, jądro po osiągnięciu limitu kończy wyłącznie Prometheusa, a nie dowolny inny proces na Pi. W Raspberry Pi OS wymaga to włączonej grupy kontrolnej pamięci.
Źródła
Powiązane artykuły