English
 Deutsch
 Polski
Tutorial: Zarządzanie przestrzenią dyskową: Wyszukiwanie największych plików przez SSH w Ubuntu/Debian

Spis treści
Prawie pełny system plików wymaga diagnozy przed porządkowaniem. Duże pojedyncze pliki są jedną z przyczyn; znaczenie mogą mieć również liczne małe pliki, usunięte pliki nadal otwarte lub właściwości systemu plików. Poniższe polecenia sprawdzają zajętość w Ubuntu i Debianie. Nie usuwają plików.
Najpierw właściwy system plików
Po połączeniu SSH ścieżka bezwzględna określa badany obszar. Przykładowa ścieżka wymaga zastąpienia istniejącym katalogiem. df opisuje system plików zawierający katalog, a nie tylko sam katalog.
df -h -- "/sciezka/do/katalogu"
df -i -- "/sciezka/do/katalogu"
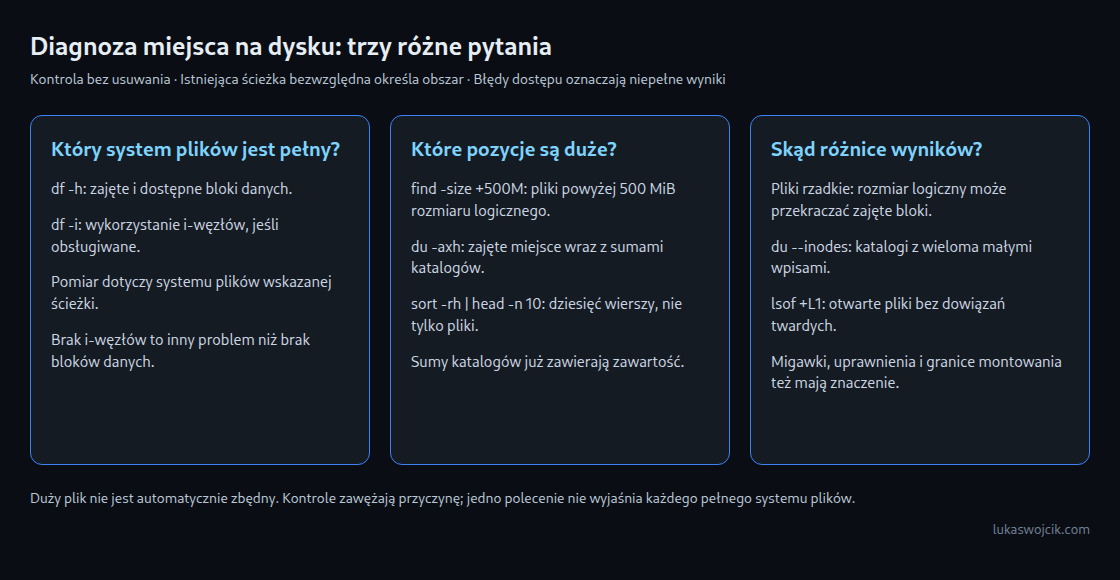
df -h pokazuje zajętość w czytelnych jednostkach binarnych. df -i pokazuje wykorzystanie i-węzłów, jeśli jest obsługiwane. I-węzły przechowują metadane systemu plików; brak dostępnych i-węzłów może uniemożliwić tworzenie plików mimo wolnych bloków danych.
Pliki większe niż 500 MiB
find "/sciezka/do/katalogu" -xdev -type f -size +500M -exec ls -lh -- {} +-type f wybiera zwykłe pliki. GNU find interpretuje M jako 1 048 576 bajtów, więc +500M oznacza rozmiar powyżej 500 MiB, a nie 500 dziesiętnych MB. Porównanie dotyczy rozmiaru logicznego. Plik rzadki może mieć duży rozmiar logiczny, zajmując niewiele bloków.
-xdev zapobiega przechodzeniu do innych systemów plików. -exec ls -lh -- {} + przekazuje nazwy znalezionych plików partiami bezpośrednio do ls. Pokazuje szczegóły, ale nie tworzy rankingu rozmiarów. Cudzysłowy obsługują spacje w ścieżce. Błędy uprawnień wymagają uwagi, ponieważ niedostępne katalogi oznaczają niepełne wyniki.
Sortowanie zajętych bloków przez du
du -axh -- "/sciezka/do/katalogu" | sort -rh | head -n 10du -a obejmuje pliki i katalogi; -h formatuje rozmiary, a -x pozostaje w jednym systemie plików. sort -rh sortuje czytelne rozmiary malejąco, a head -n 10 ogranicza wynik do dziesięciu wierszy. Wartości katalogów zawierają już zawartość. Sumowanie wszystkich wierszy policzyłoby te same dane wielokrotnie. To lista największych pozycji, nie wyłącznie pojedynczych plików.
Potok służy do interaktywnego przeglądu. Znaki nowego wiersza w nazwach plików mogą zakłócać prezentację; automatyczne przetwarzanie wymaga rekordów rozdzielanych znakiem NUL. Duże skany i sortowanie zajmują czas, obciążają wejście/wyjście i mogą potrzebować miejsca tymczasowego. Odpowiedni katalog początkowy ogranicza ten koszt.
Gdy liczby się różnią
df i du mierzą różne wielkości. Rozbieżność jest wskazówką, a nie dowodem jednej przyczyny. Niedostępne ścieżki, różne granice montowania, migawki, zarezerwowane miejsce oraz rozliczanie bloków przez system plików również mogą mieć znaczenie.
du --inodes -x --max-depth=1 -- "/sciezka/do/katalogu" | sort -nr
lsof -nP +L1
du --inodes pomaga znaleźć katalogi z wieloma wpisami systemu plików, również z licznymi małymi plikami. lsof +L1 pokazuje otwarte pliki mające mniej niż jedno dowiązanie twarde. W Linuksie plik usunięty z katalogu może zajmować bloki aż do zwolnienia ostatniej otwartej referencji. Widoczność procesów zależy od uprawnień; lsof może wymagać osobnej instalacji.
Pytania i odpowiedzi
Czy du pomija wiele małych plików?
Nie. Sumy katalogów uwzględniają zawartość, a du --inodes uzupełnia wynik o liczbę wpisów. Wyszukiwanie dużych pojedynczych plików może przeoczyć tę przyczynę, lecz sumowanie katalogów nie ma takiego ogólnego ograniczenia.
Czy każdy duży plik można usunąć?
Nie. Baza danych, plik aplikacji lub kopia zapasowa może być duża i nadal potrzebna. Porządkowanie zależy od przeznaczenia, retencji i procedur aplikacji. W przypadku logów lepszym rozwiązaniem jest skonfigurowana rotacja lub obsługiwane ponowne otwarcie niż przypadkowe usuwanie aktywnych plików.
Czy te kontrole wyjaśniają każdy pełny dysk?
Nie. Limity, migawki, metadane systemu plików lub inny pełny punkt montowania mogą wymagać dalszych sprawdzeń. Punktem wyjścia są faktycznie dotknięta ścieżka i właściwy system plików.
Powiązane artykuły