

 English
 Deutsch
 Polski
Tutorial: Ein JSON prüfen, bevor es in ein Tag wandert

Management Summary
JSON ist ein verbreitetes Format zum Austausch beschrifteter Informationen zwischen Programmen, etwa Kaufbeträgen und Produktdaten für die Analyse. Eine sauber formatierte Meldung kann trotzdem falsche Werte enthalten oder bei der Verarbeitung Angaben verlieren. Der Beitrag erklärt den Unterschied zwischen lesbaren Daten und Daten, die zu den Erwartungen des Empfängers passen. Doppelte Feldnamen oder sehr lange Zahlenkennungen zeigen, warum Inhaltsprüfung vor der Übernahme in Geschäftsberichte wichtig ist.
Inhalt
- Mit dem tatsächlichen JSON-Text beginnen
- Doppelte Namen vor dem Informationsverlust ablehnen
- Kennungen passend zum Empfängerschema erhalten
- Ein lokaler Prüfer mit klaren Zusatzregeln
- Fehlermeldungen am Original lesen
- Was jq belegt und was nicht
- Danach den Vertrag des Tags oder der API prüfen
- Fragen und Antworten
- Quellen
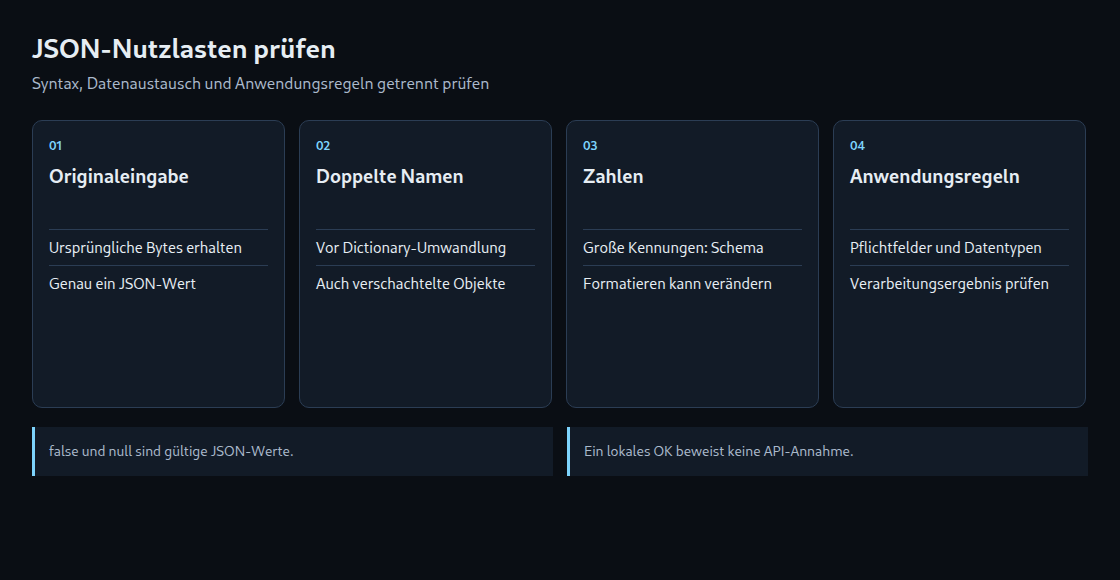
Eine JSON-Nutzlast kann syntaktisch gültig sein und trotzdem den falschen Wert übertragen. Drei getrennte Prüfungen helfen: den Originaltext parsen, Risiken beim Datenaustausch erkennen und die Regeln der empfangenden Anwendung prüfen. Formatieren allein deckt diese Aufgaben nicht vollständig ab.
Die folgenden Beispiele laufen lokal. Der Prüfer akzeptiert genau einen JSON-Wert, weist doppelte Objektnamen zurück und erhält Dezimalwerte ohne vorherige Umwandlung in binäre Gleitkommazahlen. Ein Tag-Manager oder Analysedienst wird dabei nicht angesprochen.
Mit dem tatsächlichen JSON-Text beginnen
JSON ist ein Datenformat, kein ausführbares JavaScript. Objektnamen und Zeichenketten benötigen doppelte Anführungszeichen. Kommentare, abschließende Kommas, undefined, NaN und Infinity gehören nicht zur JSON-Grammatik. Die Wertkategorien sind Objekt, Array, Zeichenkette, Zahl, Wahrheitswert und null. Ein Dokument darf auch nur aus einem einzelnen Wert wie false oder 42 bestehen. Datums- und Kennungsformate gehören zum Anwendungsschema.
Ein Apostroph innerhalb einer doppelt eingerahmten Zeichenkette ist gültig. Ein ungeschützter Zeilenumbruch innerhalb der Zeichenkette ist ungültig; die Escape-Sequenz \n stellt einen Umbruch dar. Parser erzeugen unterschiedliche Fehlermeldungen. Eine feste Anzahl „lauter“ und „stiller“ Fehler hilft deshalb wenig.
Vor dem Formatieren bleibt die ursprüngliche Antwort oder Datei erhalten. Ein Formatierer kann fehlerhaftes JSON ablehnen, doppelte Namen verwerfen oder Zahlen anders darstellen. Ein Fehler an Position null kann durch eine Byte-Reihenfolge-Marke, HTML statt JSON, eine leere Eingabe oder ein anderes unerwartetes Anfangszeichen entstehen. Die Position allein beweist keine BOM.
Doppelte Namen vor dem Informationsverlust ablehnen
RFC 8259 empfiehlt eindeutige Namen innerhalb jedes Objekts. Empfänger behandeln Doppelungen unterschiedlich: Häufig bleibt der letzte Wert erhalten, möglich sind aber auch Ablehnung oder Weitergabe aller Paare. Nach der Umwandlung in ein gewöhnliches Dictionary kann der verworfene Wert bereits fehlen.
{"a":{"x":1},"a":{"y":2}} wiederholt beispielsweise den Namen a, obwohl sich die Pfade zu den Endwerten, a.x und a.y, unterscheiden. Eine Suche nach mehrfachen Blattpfaden eines Streaming-Parsers erkennt diesen Fall nicht zuverlässig. Derselbe Name in zwei getrennten Objekten ist dagegen keine Doppelung innerhalb eines Objekts. Der Prüfer verwendet Pythons object_pairs_hook vor dem Aufbau jedes Dictionarys, auch bei verschachtelten Objekten und maskierten Namen.
Kennungen passend zum Empfängerschema erhalten
JavaScripts Number verwendet binäre Gleitkommazahlen. Jede ganze Zahl im geschlossenen Bereich von −(2^53−1) bis 2^53−1 ist sicher darstellbar. Außerhalb sind einzelne ganze Zahlen weiterhin darstellbar, aber nicht mehr alle benachbarten Werte unterscheidbar. Das folgende Node.js-Beispiel zeigt eine veränderte letzte Ziffer.
const parsed = JSON.parse('{"id":9007199254740993}');
console.log(parsed.id); // 9007199254740992
console.log(Number.isSafeInteger(parsed.id)); // false
const exact = JSON.parse('{"id":"9007199254740993"}');
console.log(exact.id); // "9007199254740993" as a string
Eine Zeichenkette erhält diese Kennung, wenn die empfangende API Zeichenketten erlaubt. Verlangt die API eine Zahl, gelten deren dokumentierte Darstellung und Grenzen. Jede Kennung bedingungslos in Text umzuwandeln kann eine gültige Anfrage ungültig machen. Ein regulärer Ausdruck zum Zählen von Ziffern ist keine vollständige Genauigkeitsprüfung: Negative Werte und Exponenten können fehlen, Zahlenzeichenketten mit Zahlen verwechselt werden.
Ein lokaler Prüfer mit klaren Zusatzregeln
Die Datei benötigt nur die Python-Standardbibliothek. Nach dem Speichern als check_json.py lautet der Aufruf python3 check_json.py payload.json. Rückgabecode 0 bedeutet bestandene lokale Prüfungen, Rückgabecode 1 eine Ablehnung. Der Dateiinhalt wird nicht ausgegeben.
import json
import sys
from decimal import Decimal, InvalidOperation
from pathlib import Path

MAX_BYTES = 1_048_576  # Local example policy, not a JSON limit.

def unique_object(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError("duplicate object member")
        result[key] = value
    return result

def reject_constant(value):
    raise ValueError("non-JSON numeric constant")

def check(raw):
    if len(raw) > MAX_BYTES:
        raise ValueError("example size limit exceeded")
    # Strict UTF-8; this example also rejects a leading BOM.
    text = raw.decode("utf-8")
    if text.startswith("\ufeff"):
        raise ValueError("leading BOM rejected by local policy")
    value = json.loads(text, object_pairs_hook=unique_object,
                       parse_float=Decimal, parse_constant=reject_constant)
    # Reject lone UTF-16 surrogates for interoperable Unicode text.
    def visit(x):
        if isinstance(x, str):
            x.encode("utf-8")
        elif isinstance(x, dict):
            for key, item in x.items():
                visit(key)
                visit(item)
        elif isinstance(x, list):
            for item in x:
                visit(item)
    visit(value)
    return value

if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("Usage: python3 check_json.py payload.json")
    try:
        with Path(sys.argv[1]).open("rb") as stream:
            raw = stream.read(MAX_BYTES + 1)
        check(raw)
    except json.JSONDecodeError as exc:
        print(f"Syntax error: line {exc.lineno}, column {exc.colno}",
              file=sys.stderr)
        raise SystemExit(1)
    except (OSError, ValueError, UnicodeError, RecursionError,
            InvalidOperation, OverflowError):
        print("Rejected: encoding, duplicate, value or resource policy",
              file=sys.stderr)
        raise SystemExit(1)
    print("OK: JSON plus the example's interoperability checks")
Die Grenze von einem Mebibyte, die Ablehnung einer führenden BOM und die Ablehnung einzelner Surrogatzeichen sind ausdrücklich zusätzliche Regeln für Datenaustausch und Ressourcenverbrauch. Nicht jede dadurch abgelehnte Eingabe verletzt die JSON-Grammatik. Auch der Parser besitzt Implementierungsgrenzen. Das Beispiel ist kein vollständiger Schutz vor schädlichen Eingaben.
Pythons Standarddecoder akzeptiert NaN und Infinity als Erweiterungen; parse_constant verhindert das hier. Decimal erhält dezimale Eingaben für die Prüfung, ganze Zahlen bleiben Python-Ganzzahlen. Beides beweist nicht, dass ein späterer JavaScript-Empfänger oder eine externe API denselben Wert darstellen kann.
Fehlermeldungen am Original lesen
Python liefert bei einem Syntaxfehler Zeile und Spalte. JavaScript-Fehlermeldungen unterscheiden sich nach Engine und Version. Das Herauslesen eines englischen Wortes „position“ ist keine portable Schnittstelle. Zeichenpositionen, UTF-16-Codeeinheiten und Bytepositionen dürfen nicht vermischt werden. Tabulatoren und Umbrüche machen auch eine selbst gesetzte Fehlermarkierung mit dem Zeichen ^ unzuverlässig.
Die lokale Sichtung rund um die ursprüngliche Fehlerstelle hilft. Produktionsprotokolle sollten keine vollständigen Nutzlasten mit personenbezogenen Daten oder Zugangsdaten ausgeben. Die Syntaxmeldung zeigt die Stelle des Parserabbruchs; der eigentliche Fehler kann davor liegen.
Was jq belegt und was nicht
jq -e . ist keine reine Gültigkeitsprüfung: Die gültigen Werte false und null erzeugen einen Rückgabecode ungleich null. jq liest üblicherweise außerdem einen Strom von JSON-Werten. Eine erfolgreiche Verarbeitung beweist deshalb nicht genau ein Dokument. Leere Eingaben und Erweiterungen benötigen ausdrückliche Regeln. Der Python-Prüfer oben legt diese Regeln offen.
Das Zahlenverhalten hängt von jq-Version und Build-Optionen ab. Das Erhalten eines Zahlenliterals und die Umwandlung bei Rechenoperationen sind verschiedene Dinge. Eine pauschale Garantie für jede Ausgabe seit Version 1.7 ist falsch. Für Genauigkeitsprüfungen ersetzt eine formatierte Kopie nicht das Original.
Danach den Vertrag des Tags oder der API prüfen
Eine bestandene lokale Prüfung bestätigt weder Pflichtfelder noch Ereignisnamen, Währung, Datumsformat oder Geschäftsregeln. Die erzeugte Nutzlast braucht zusätzlich das Schema und die dokumentierten Diagnosewerkzeuge der empfangenden Plattform. Antworten und Verarbeitungsergebnisse müssen ebenfalls beobachtet werden. Ein HTTP-Status allein belegt unter Umständen keine richtigen nachgelagerten Daten.
Bei JSON-LD wird die ausgelieferte Seite zusammen mit dem jeweiligen Typ strukturierter Daten geprüft. Ein beschädigter Block beweist nicht, dass sämtliche anderen Blöcke unlesbar sind. Gültige Syntax garantiert auch keine erweiterten Suchergebnisse. Bei Tag-Vorlagen sind Importprüfung und Laufzeitverhalten getrennte Aufgaben; der Fehlerzeitpunkt hängt vom tatsächlichen Format und der Plattform ab.
Fragen und Antworten
Wie verhält sich JSON.parse im Browser bei doppelten Namen?
Es meldet keinen Fehler und behält den letzten Wert. Aus {"a":1,"a":2} wird ein Objekt mit a = 2, und nichts im Ergebnis zeigt, dass es einen ersten Wert gab. Ein Tag, das die Nutzlast im Browser liest, sieht die Doppelung also nie; deshalb lohnt die Prüfung am Originaltext vor dem Parsen.
Welche Werte verändert JSON.stringify beim Erzeugen einer Nutzlast stillschweigend?
Mehrere, und nur in einem Fall entsteht ein Fehler. Code, der eine Nutzlast in JavaScript zusammenbaut, etwa in einer benutzerdefinierten Variablen, kann auf diese Fälle treffen:
NaN,Infinityund-Infinitywerden zunull. Eine fehlgeschlagene Umrechnung kommt so als gültiges JSON an.- Eigenschaften mit dem Wert
undefined, einer Funktion oder einem Symbol fallen in Objekten weg; in Arrays werden sie zunull. Ein Pflichtfeld kann dadurch fehlen, ohne dass eine Meldung erscheint. - Ein
Date-Objekt wird zu einer Zeichenkette im ISO-Format in UTC. Erwartet der Empfänger ein anderes Datumsformat oder die Ortszeit, passt der Wert nicht. MapundSetwerden zu leeren Objekten.- Ein
BigIntlöst einen TypeError aus. Das ist der einzige laute Fall.
Der Prüfer aus dem Artikel erkennt davon nur, was im Text sichtbar bleibt. Ein fehlendes Feld oder ein null an falscher Stelle fällt erst gegen das Schema des Empfängers auf.
Warum liest der Prüfer Dezimalzahlen als Decimal statt als float?
Weil float jede Dezimalzahl in einen Binärwert umrechnet und viele Dezimalbrüche dabei nur angenähert werden. Der Betrag 19,99 wird als float zu einem Wert knapp darunter, der bei der Ausgabe meist wieder als 19.99 erscheint, beim Rechnen aber abweicht; bekannt ist 0.1 + 0.2, das 0.30000000000000004 ergibt. Ab 16 signifikanten Stellen kann ein Binärwert ein Literal nicht mehr zuverlässig wiedergeben; die Kennung 9007199254740993 aus dem Artikel zeigt das in JavaScript.
Decimal übernimmt das Literal so, wie es geschrieben ist. Damit lassen sich Regeln am geschriebenen Wert prüfen, etwa höchstens zwei Nachkommastellen bei einem Betrag; Decimal("19.990") hat drei, obwohl es denselben Zahlenwert beschreibt. Ob ein späterer Empfänger dieselbe Genauigkeit hat, bleibt dabei offen, wie der Artikel festhält.
Lässt sich eine zu große Kennung nach JSON.parse noch retten?
Nicht aus dem geparsten Objekt. Die Zahl darin ist bereits auf den nächsten darstellbaren Wert gerundet, aus 9007199254740993 wurde 9007199254740992, und keine spätere Umwandlung kennt die ursprüngliche Ziffer. Erhalten bleibt der Wert nur, wenn er vor dem Parsen aus dem Originaltext gelesen wird oder die Quelle ihn von vornherein als Zeichenkette liefert.
Quellen
Verstehen durch Ausprobieren
Eine Minute: Findest Du den Denkfehler?
Warum ist dieses JSON ungültig?
{"event":"page_view","value":42,}JSON erlaubt kein abschließendes Komma. Entferne es. Gültige Syntax sagt noch nichts darüber, ob die Anwendung diese Felder erwartet.
Ein Problem, ein nachvollziehbarer Weg
Mein JSON macht Probleme
- Verstehen: JSON prüfen
- Ausprobieren: JSON formatieren
- Mit einem kleinen Beispiel beginnen und Syntaxfehler finden. Danach prüfen, ob Werte und Datentypen zur Anwendung passen – gültige Syntax allein reicht dafür nicht.
Passend dazu


