English
 Deutsch
 Polski
Zwei GTM-Container-Exporte vergleichen: Normalisieren vor dem Diff und was ein Zeilenvergleich nicht zeigt

Inhalt
Zwei Ausgaben derselben Konfiguration zu vergleichen ist der schnellste Weg herauszufinden, was jemand geändert hat, und der erste Versuch liefert fast immer ein unbrauchbares Ergebnis. Es sind mehrere hundert abweichende Zeilen, von denen eine zählt und der Rest das Dateiformat mit sich selbst reden lässt.
Alles Folgende handelt vom Abstand zwischen diesen beiden Zahlen – wovon er gefüllt ist, wie er verschwindet und was auch danach unsichtbar bleibt.
Wovon der Abstand gefüllt ist
Ausgaben werden erzeugt, und Erzeuger sind zu nichts verpflichtet. Dieselbe Konfiguration, zweimal ausgegeben, kann sich in der Reihenfolge der Objektschlüssel unterscheiden, in Kennungen, die beim Ausgeben vergeben werden, in einem Fingerabdruck, der ein Zeitstempel ist, und darin, ob die Datei mit einem Zeilenumbruch endet. Nichts davon ist eine Änderung; alles davon ist ein Unterschied.
| Quelle des Rauschens | Wie es aussieht | Wie es verschwindet |
|---|---|---|
| Schlüsselreihenfolge | ganze Blöcke gelten als geändert | jq -S . sortiert die Schlüssel rekursiv |
| Fingerabdrücke, Zeitstempel | eine geänderte Zeile je Objekt | die Felder vor dem Vergleich löschen |
| Beim Ausgeben vergebene Kennungen | jeder Verweis weicht ab | ebenso – oder über Namen vergleichen |
| Einrückung | alles weicht ab | jq formatiert beide Seiten gleich |
| Zeilenenden | jede Zeile weicht ab und sieht gleich aus | dos2unix oder die Option des Vergleichswerkzeugs |
| Minimierung | eine Zeile weicht ab und sagt nichts | neu formatieren, dann vergleichen |
Die Zeile mit den Zeilenenden kostet eine Stunde, weil die beiden Zeilen auf dem Bildschirm genau gleich aussehen. Eine Datei, die durch einen Windows-Editor gegangen ist, unterscheidet sich von ihrem Ursprung in jeder einzelnen Zeile, und jeder dieser Unterschiede ist unsichtbar.
Erst normalisieren, dann vergleichen
Die Abhilfe ist eine Verarbeitungskette und kein besseres Vergleichswerkzeug. Beide Dateien laufen durch dieselbe Normalisierung, die flüchtigen Felder werden entfernt, und erst danach werden die Ergebnisse verglichen – dann enthält der Vergleich, was sich geändert hat, und sonst nichts.
norm() {
  jq -S 'walk(if type == "object"
              then del(.exportTime, .fingerprint, .accountId, .containerVersionId)
              else . end)' "$1"
}

diff <(norm alt.json) <(norm neu.json)
walk steigt in jedes Objekt hinab, die Felder verschwinden also überall, wo sie vorkommen, und nicht nur auf der obersten Ebene. -S sortiert die Schlüssel jedes Objekts und beseitigt damit allein die größte Rauschquelle. Was beides übersteht, ist eine Änderung, die jemand gemacht hat.
Drei Ebenen, drei verschiedene Antworten
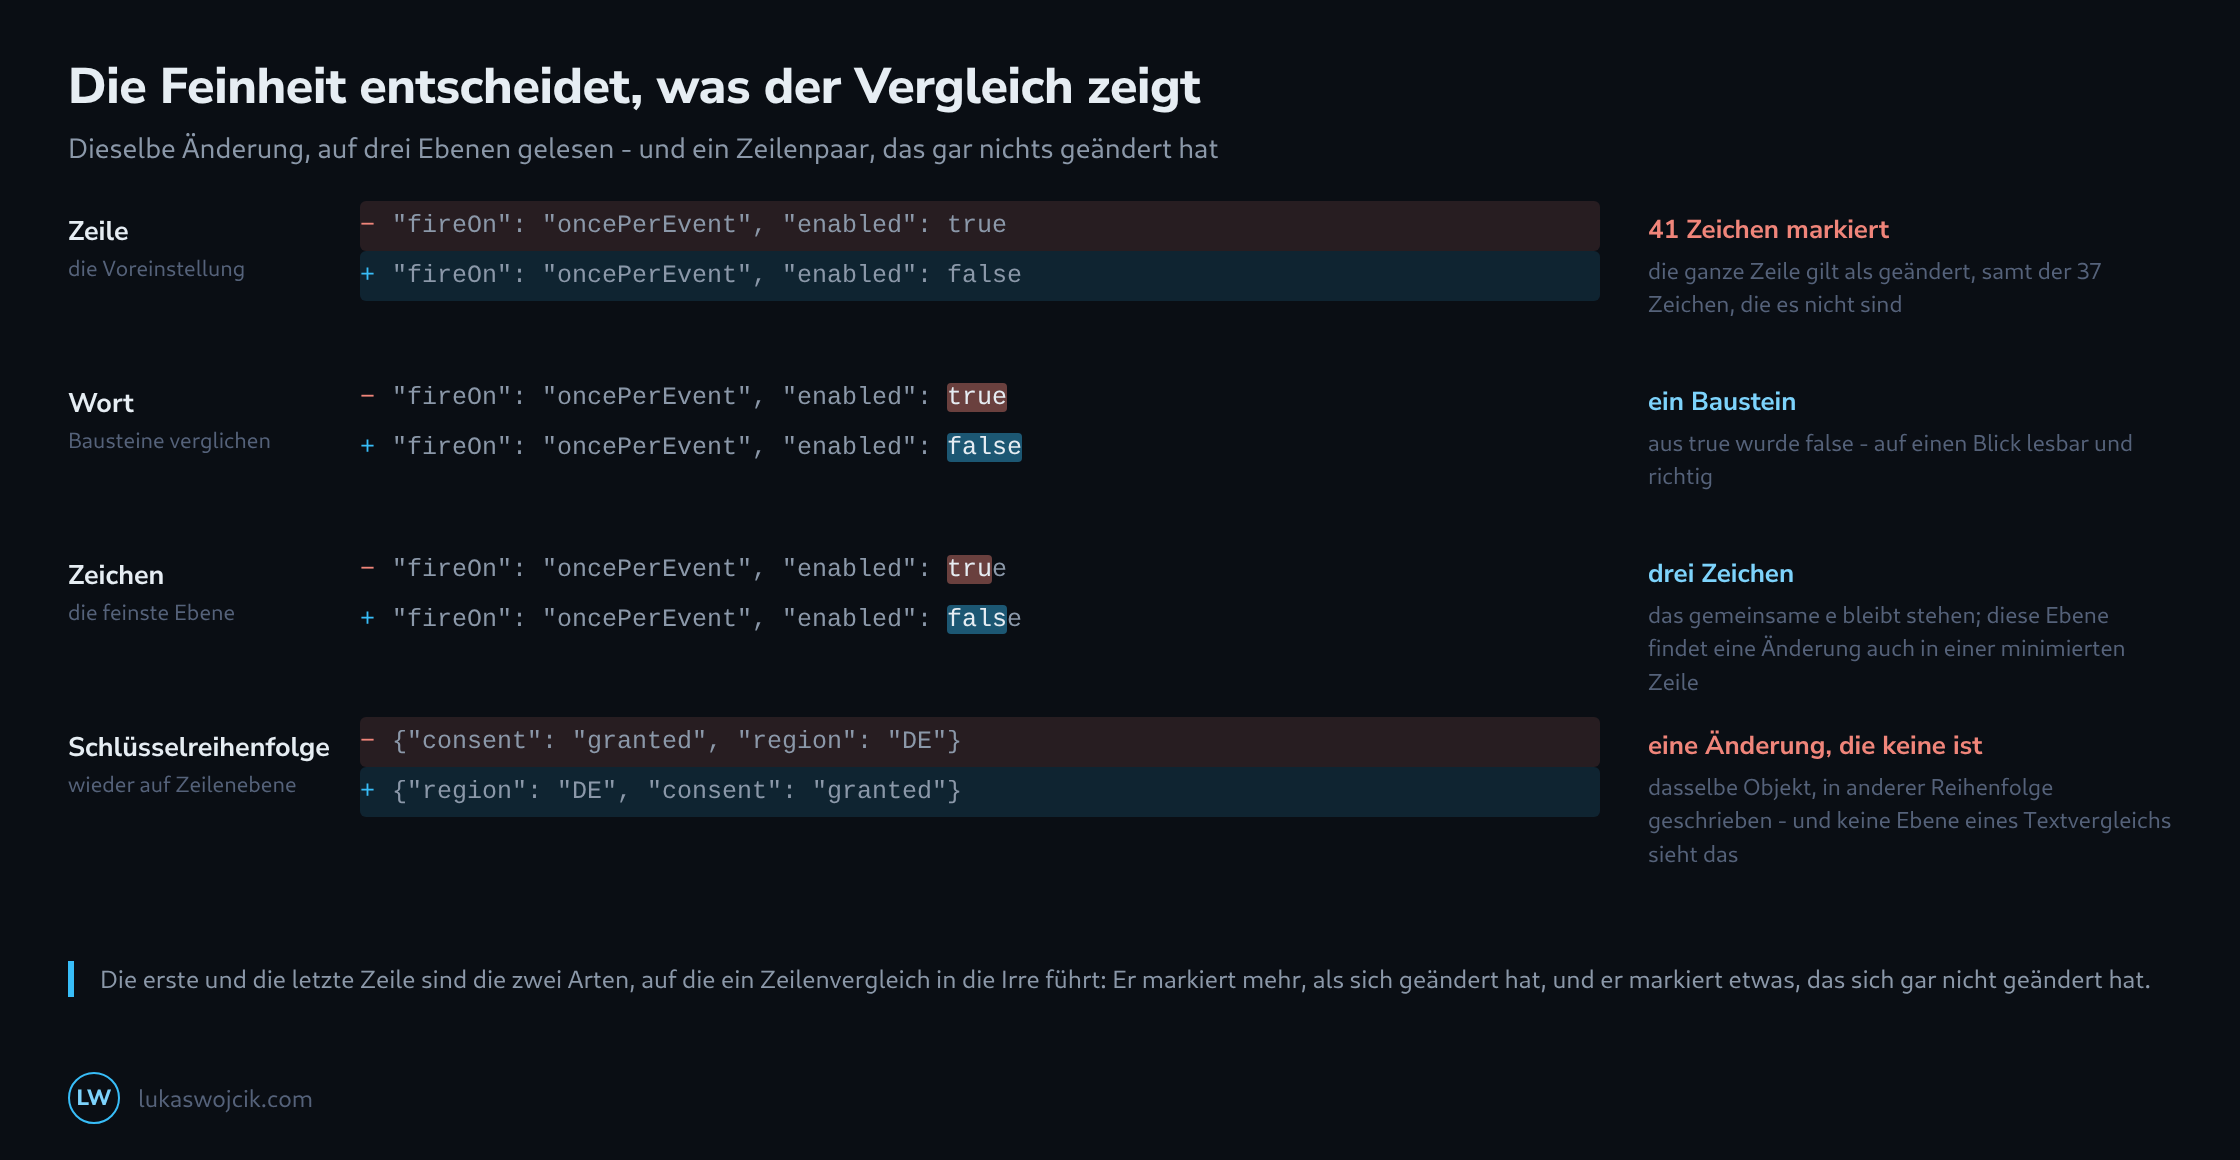
Zeile, Wort und Zeichen sind keine Güteklassen, sondern verschiedene Fragen. Ein Zeilenvergleich beantwortet, welche Zeilen nicht gleich sind, und das ist die richtige Frage für Quelltext, wo eine Zeile ungefähr eine Anweisung ist. Es ist die falsche Frage für eine JSON-Datei mit einem Objekt je Zeile und vollends unbrauchbar für eine minimierte, in der das ganze Dokument eine einzige Zeile ist.
Die Wortebene vergleicht Bausteine und macht eine Änderung an einem Wert lesbar. Die Zeichenebene ist feiner, als zum Lesen nötig wäre, und genau das Richtige, wenn die Zeile lang ist: In einer minimierten Containerausgabe kann nur ein Zeichenvergleich auf den einen umgekippten Wahrheitswert zeigen.
Was keine Ebene zeigt
Ein Textvergleich sieht Text. Drei Arten von Änderung bleiben deshalb unsichtbar, gleich wie fein die Auflösung wird. Ein verschobener Block erscheint als Löschung an einer und als Ergänzung an anderer Stelle, ohne dass etwas die beiden verbindet. Eine umbenannte Variable, die an zwölf Stellen vorkommt, erscheint als zwölf einzelne Änderungen statt als eine Absicht. Und ein Wert, der den Typ gewechselt hat, ohne das Aussehen zu wechseln – aus "1" wird 1 -, ist ein Unterschied von zwei Zeichen mit Folgen, die keine Hervorhebung vermittelt.
Der umgekehrte Fall steht in der vierten Zeile des Diagramms: zwei Dateien, die sich in jeder Zeile unterscheiden und dasselbe Objekt beschreiben. Ein Vergleich von Text kann immer nur Fragen über Text beantworten – und die Frage, die tatsächlich gestellt wird, ob sich die Konfiguration geändert hat, ist eine Frage über Struktur.
Was stattdessen zu vergleichen ist, wenn es auf die Antwort ankommt
Bei allem, was ein Schema hat, ist der ehrliche Vergleich der zwischen zerlegten Objekten und nicht der zwischen Dateien. jq kann das unmittelbar: Zwei Dokumente sind gleich oder sie sind es nicht, und die Antwort ist ein einzelner Wahrheitswert, den Formatierung, Schlüsselreihenfolge und Leerraum nicht berühren.
# ist es überhaupt dasselbe Objekt?
jq -e --slurpfile b <(norm neu.json) '. == $b[0]' <(norm alt.json) >/dev/null && echo "gleich"

# welche Schlüssel der obersten Ebene weichen ab?
jq -n --slurpfile a alt.json --slurpfile b neu.json \
  '($a[0] | keys) as $ka | ($b[0] | keys) as $kb
   | { nur_alt: ($ka - $kb), nur_neu: ($kb - $ka) }'
Dem Zeilenvergleich bleibt damit die Aufgabe, die er gut kann: einem Menschen zu zeigen, was ein anderer getan hat, in einer Form, die sich liest wie die Datei, die er bearbeiten wird. Er beantwortet sehr gut, worauf zu schauen ist, und überhaupt nicht, ob etwas dasselbe ist – und der meiste Ärger mit ihm kommt daher, dass ihm die zweite Frage gestellt wird.
Fragen und Antworten
Lässt sich auf diesem Weg auch ein Testcontainer mit dem Live-Container vergleichen?
Ja, aber die Normalisierung allein genügt dafür nicht. Innerhalb eines Containers behalten Tags, Trigger und Variablen ihre Nummern von Version zu Version; zwischen zwei Containern stimmen tagId, triggerId und variableId nicht zwingend überein, und dann weicht jeder Verweis ab. Dazu kommt die containerId, die in jedem Tag, jedem Trigger und jeder Variablen steht und zwischen zwei Containern immer verschieden ist. Dieses Feld gehört deshalb zu denen, die vor dem Vergleich gelöscht werden, neben accountId und containerVersionId.
Heikel ist, woran diese Verweise hängen. Ein Tag nennt seine Trigger in firingTriggerId und blockingTriggerId nur über deren Nummer. Wer die Kennungen einfach löscht, entfernt mit dem Rauschen auch die Angabe, welcher Trigger ein Tag auslöst, und der Vergleich wird leiser und zugleich blind. Über Namen zu vergleichen heißt hier, in jedem Tag die Triggernummern vor dem Vergleich durch die Namen der Trigger zu ersetzen. Variablen brauchen diesen Schritt nicht, weil sie in den Parametern ohnehin mit ihrem Namen in doppelten geschweiften Klammern stehen. Der eingebaute Trigger für alle Seiten fehlt in der Triggerliste; seine Nummer ist in jedem Container dieselbe und darf stehen bleiben.
Danach bleibt die Reihenfolge. jq -S sortiert Objektschlüssel, aber keine Listen, und stehen die Tags in den beiden Dateien in anderer Reihenfolge, gelten ganze Blöcke als geändert. sort_by(.name) auf die Listen der Tags, Trigger und Variablen behebt das. Tiefer sollte die Sortierung nicht reichen: In einer RegEx-Tabelle gewinnt die erste passende Zeile, dort ist die Reihenfolge Inhalt.
Gehört der normalisierte Export in eine Versionsverwaltung?
Ja, neben der unveränderten Datei. Die normalisierte Fassung macht jeden Commit zu einer Liste echter Änderungen; die Originaldatei bleibt die, die sich wieder importieren lässt, denn die Normalisierung ist zum Lesen gebaut und nicht zum Zurückspielen. Eine Zeile *.json text eol=lf in der Datei .gitattributes verhindert außerdem, dass Git beim Auschecken unter Windows die Zeilenenden umschreibt und damit die teuerste Zeile der Tabelle selbst erzeugt.
Passend dazu