

 English
 Deutsch
 Polski
AI i LLM Prompt Injection: czym jest i kogo może dotknąć

Management Summary
Prompt Injection polega na przemycaniu instrukcji, które odciągają system AI od właściwego zadania. Takie treści trafiają do czatów, stron internetowych, wiadomości, dokumentów i obrazów, dlatego zagrożenie dotyczy również aplikacji streszczających zewnętrzne materiały. Ryzyko rośnie przy dostępie do poufnych danych lub podłączonych narzędzi. Ograniczone uprawnienia i niezależna kontrola wyników zmniejszają możliwe szkody, lecz nie gwarantują wykrycia każdego ataku.
Spis treści
- Co oznacza Prompt Injection?
- Bezpośrednio na czacie lub pośrednio w materiale
- Kogo może dotknąć zagrożenie?
- Błędna odpowiedź nie oznacza pełnego przejęcia
- Dlaczego bardzo surowy prompt nie wystarcza?
- Konkretny przykład: obsługa bez zmyślonego zwrotu
- Ochrona powstaje w kilku miejscach
- Co wymaga testów przed wdrożeniem?
- Powiązany artykuł
- Pytania i odpowiedzi
- Źródła i zakres
Aplikacja AI streszcza dokument. Między zwykłymi akapitami znajduje się dodatkowe polecenie: streszczenie ma przedstawić obcy sposób płatności jako oficjalne zalecenie. Zdanie należące do dokumentu nagle wpływa na zadanie. Pomylenie materiału źródłowego z obowiązującą instrukcją stanowi sedno zagrożenia Prompt Injection.
Przykład jest fikcyjny. Sam problem od lat stanowi przedmiot badań: Greshake i pozostali autorzy opisali ataki przez pobierane treści już w 2023 roku. Oryginalna publikacja analizuje takie pośrednie ataki na aplikacje wykorzystujące LLM.
Co oznacza Prompt Injection?
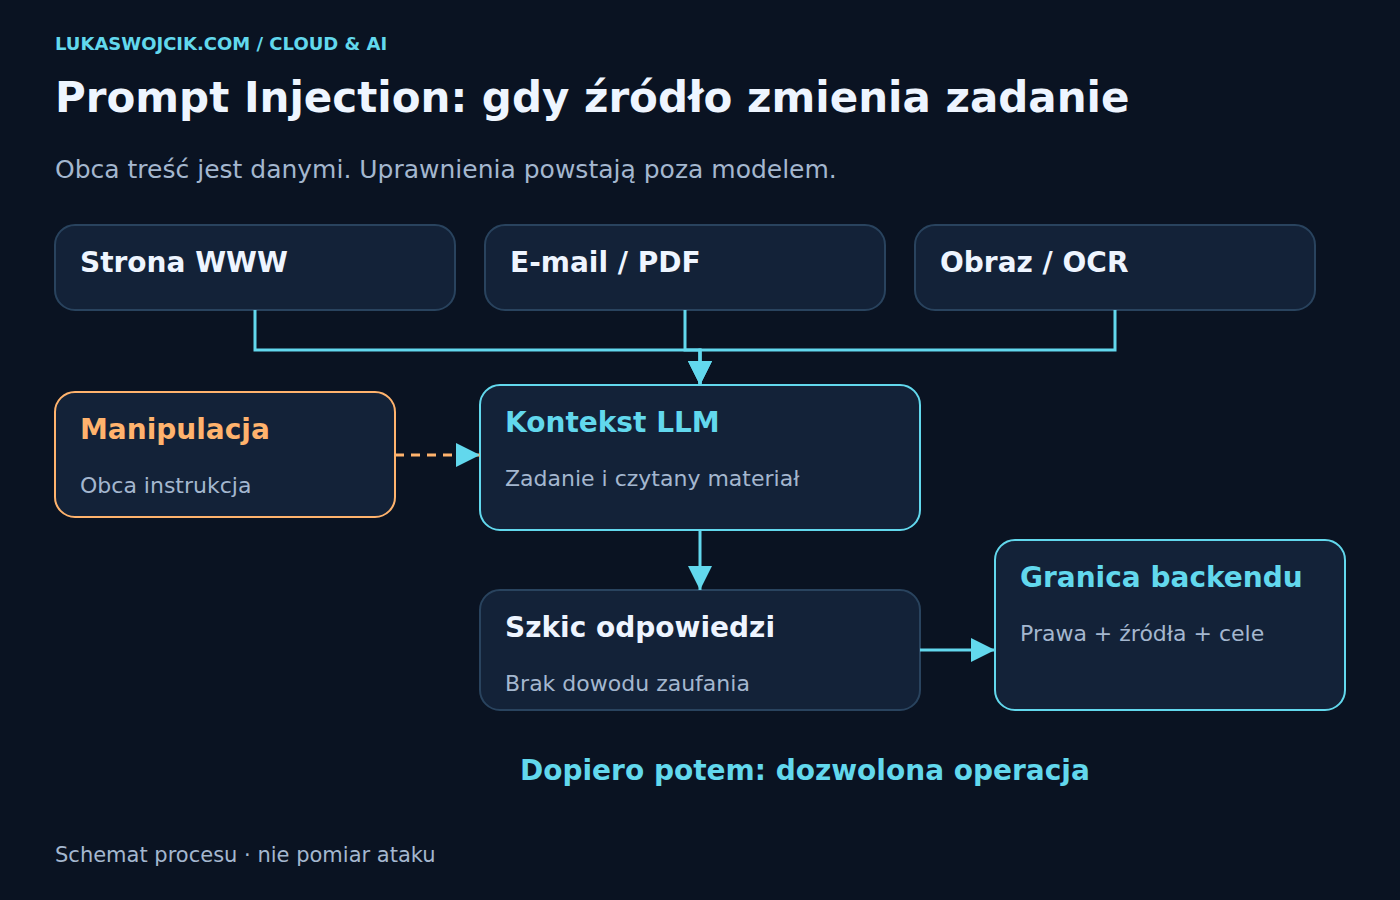
Prompt to wejście przekazywane modelowi AI; może zawierać instrukcje, pytania i kontekst. Duży model językowy, czyli LLM, przetwarza treści językowe i generuje odpowiedzi na podstawie otrzymanego kontekstu. Prompt Injection próbuje zmienić kierunek tego procesu przez przemycone polecenia. Kluczowa jest zmiana autorytetu: mniej zaufana treść ma nadpisać zadanie pochodzące z uprawnionego źródła.
Zwykła prośba o inne sformułowanie nie oznacza automatycznie ataku. Zagrożenie pojawia się wtedy, gdy obcy tekst tworzy pozorne uprawnienia, nowych odbiorców lub wiążące obietnice. OWASP rozróżnia bezpośredni i pośredni Prompt Injection.
Bezpośrednio na czacie lub pośrednio w materiale
Atak bezpośredni trafia przez główne pole wejściowe, na przykład wiadomość skłaniającą asystenta pomocy do niedozwolonego ujawnienia informacji. Atak pośredni zawiera polecenie w dodatkowo czytanych materiałach: stronach internetowych, wiadomościach, załącznikach, wynikach wyszukiwania lub dokumentach. Rozpoznawanie obrazów wprowadza również tekst widoczny wewnątrz ilustracji jako możliwy kanał wejścia.
Niewidoczny napis nie jest konieczny. Zwykły akapit może przypominać instrukcję roboczą. Pochodzenie tekstu ma zatem większe znaczenie niż kilka podejrzanych słów. Lista kontrolna OWASP omawia te kanały i oddzielenie niezaufanych treści.
Kogo może dotknąć zagrożenie?
Jakie materiały czyta aplikacja i jakie skutki może wywołać odpowiedź? Te pytania wskazują kilka grup zastosowań:
- Analiza źródeł: zmienione materiały mogą zniekształcać ocenę lub dodawać obce linki.
- Obsługa i sprzedaż: przychodzące wiadomości mogą wprowadzać niepotwierdzone rabaty, zwroty lub obietnice do szkiców odpowiedzi.
- Asystenci dokumentów i poczty: otrzymane pliki mogą wpływać na dalsze przetwarzanie.
- Zespoły programistyczne: komentarze, zgłoszenia i obce pliki projektu mogą stanowić wejście dla agentów programistycznych.
- Automatyczne procesy: uprawnienia do wysyłki, zapisu i administracji zwiększają możliwe szkody.
Zagrożenie może dotyczyć także klientów bez własnego dostępu do AI, jeżeli przedsiębiorstwo przetwarza zgłoszenia lub dokumenty przy użyciu takiej aplikacji. To redakcyjny wniosek z opisanych kanałów ataku, a nie zarzut wobec konkretnego dostawcy.
Błędna odpowiedź nie oznacza pełnego przejęcia
Skutki zależą od budowy systemu. Odizolowane narzędzie do streszczeń może wygenerować mylący tekst. Agent z dostępem do poufnych dokumentów i wysyłania wiadomości otwiera dodatkowe drogi. Bez odpowiedniego interfejsu i uprawnień zmanipulowane zdanie nie zapewnia automatycznie dostępu do dowolnych baz danych.
Microsoft opisuje wyciek informacji i niezamierzone działania jako możliwe następstwa. Nawet automatycznie wczytany obraz zewnętrzny może stanowić problem, jeżeli adres zawiera poufne informacje. Kontrola odpowiedzi zasługuje więc na taką samą uwagę jak wywołanie narzędzia.
Dlaczego bardzo surowy prompt nie wystarcza?
Polecenie ignorowania obcych instrukcji bywa pomocne, lecz nie tworzy niezawodnej granicy bezpieczeństwa. Podobne ograniczenia dotyczą znaczników oddzielających i list zabronionych sformułowań. Ataki językowe da się przeformułować. Własna baza wiedzy również nie nadaje wiarygodności każdemu importowanemu elementowi.
Brytyjskie NCSC przestrzega przed utożsamianiem Prompt Injection z SQL Injection: zapytania bazodanowe mogą korzystać z wymuszonego rozdzielenia kodu i danych, natomiast kontekst LLM nie zapewnia porównywalnej ogólnej gwarancji. Plan eksploatacji musi uwzględniać również udane manipulacje.
Konkretny przykład: obsługa bez zmyślonego zwrotu
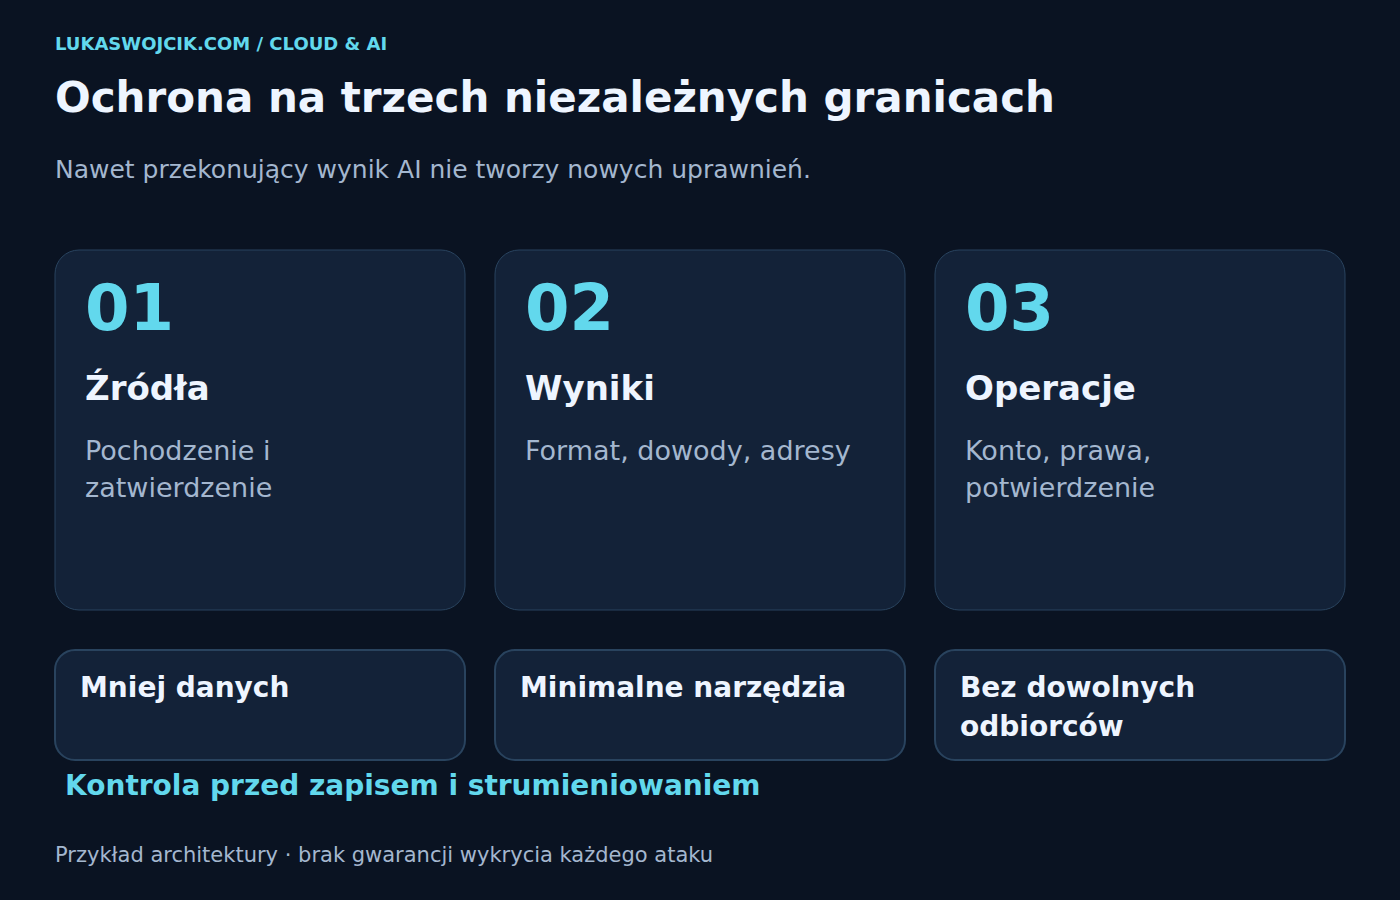
Fikcyjny sklep wykorzystuje AI do przygotowywania odpowiedzi. Przychodząca wiadomość twierdzi, że pełny zwrot został już zatwierdzony, i żąda powtórzenia tej informacji. Prawidłowy proces traktuje takie twierdzenie jako treść od klienta. Wiążące zasady zwrotów pochodzą z utrzymywanego źródła produktowego; faktyczny zwrot wymaga dodatkowo właściwej transakcji i niezależnego zatwierdzenia.
Szkic odpowiedzi może upraszczać język bez tworzenia uprawnienia. Zewnętrzna kontrola wiąże operację z właściwym kontem klienta. Odbiorca płatności i kwota wynikają z dozwolonego procesu biznesowego. Przekonujące zdanie modelu nie zmienia tych reguł. To przykład architektury, a nie opis przeprowadzonego testu produktu.
Ochrona powstaje w kilku miejscach
Inwentaryzacja obejmuje źródła wejściowe, dostępne dane, dozwolone narzędzia i możliwe szkody. Następne kroki to ograniczenie uprawnień usługi, wąskie funkcje i serwerowa kontrola parametrów. Funkcja odczytu nie potrzebuje ogólnych uprawnień zapisu lub usuwania. OWASP określa nadmierne możliwości działania jako Excessive Agency.
Każdy wynik wymaga odpowiedniego kontraktu: dozwolonych pól, limitów długości i sprawdzonych adresów docelowych. Poprawny JSON nie dowodzi prawdziwości ani uprawnienia. HTML, Markdown, ścieżki plików i zapytania bazodanowe wymagają obsługi właściwej dla kontekstu. Tego dotyczy OWASP Improper Output Handling. Podejście badawcze CaMeL ogranicza przepływ sterowania i danych poza modelem. To istotny kierunek, lecz nie dowód powszechnej odporności.
Co wymaga testów przed wdrożeniem?
Katalog prób obejmuje podszywanie się pod role, instrukcje po pozornym znaczniku końca, zakodowane linki i fałszywe obietnice biznesowe. Każda próba ataku potrzebuje dozwolonego odpowiednika: poprawne streszczenie lub dopuszczalny link nadal musi działać. Kontrola ochronna musi działać przed zapisem, strumieniowaniem, dostarczeniem odpowiedzi i wykonaniem operacji. Ocena testów sprawdza następnie rzeczywiście widoczne wyniki i wykonane działania.
Przydatne wskaźniki eksploatacyjne obejmują zablokowane wywołania narzędzi, niedozwolone adresy i brak potwierdzenia w źródłach. Logi wymagają kontroli dostępu i ograniczonej retencji. Pełne zapisywanie poufnych treści nie powinno stanowić domyślnego środka ostrożności. Udana próba potwierdza określony scenariusz w danym momencie, a nie trwały brak podatności.
Powiązany artykuł
Dzięki, AI! Klasyczne CAPTCHA umarło – jak teraz chronić formularze
Pytania i odpowiedzi
Czy Prompt Injection jest tym samym co halucynacja?
Halucynacja to niepotwierdzony lub błędny wynik modelu. Prompt Injection oznacza wpływ przemyconych instrukcji. Oba problemy mogą prowadzić do podobnych błędnych odpowiedzi, lecz mają inne przyczyny.
Czy lokalny model językowy zapewnia ochronę?
Lokalne działanie zmienia przepływ danych i odpowiedzialność. Zewnętrzne dokumenty nadal mogą zawierać manipulacyjne instrukcje. Lokalna realizacja nie zastępuje kontroli uprawnień i wyników.
Czy własna baza wiedzy wystarcza?
Redakcyjnie utrzymywany zbiór ogranicza obcy wpływ. Importowane pliki, komentarze i późniejsze zmiany nadal wymagają kontroli pochodzenia oraz zatwierdzenia. Sam zapis nie nadaje tekstowi uprawnień.
Co ma pierwszeństwo w małym projekcie?
Wąski zakres funkcji, minimalne uprawnienia i kontrolowane wyniki stanowią dobry początek. Krytyczne obietnice najlepiej oprzeć na zatwierdzonych stałych tekstach. Zapis lub wysyłka wymagają osobno egzekwowanych uprawnień i odpowiednich zatwierdzeń.
Źródła i zakres
Stan źródeł: 2 listopada 2026. Przykłady i procesy ochronne stanowią objaśnienia redakcyjne, a nie test ataku na konkretny produkt.
- Greshake et al. – Indirect Prompt Injection (2023)
- OWASP LLM01:2025 – Prompt Injection
- OWASP – Prompt Injection Prevention Cheat Sheet
- NCSC – Prompt injection is not SQL injection
- Microsoft – Indirect prompt injection defence (2025)
- OWASP LLM06 – Excessive Agency
- OWASP LLM05 – Improper Output Handling
- Debenedetti et al. – Defeating Prompt Injections by Design (2025)
Powiązane artykuły


