

 English
 Deutsch
 Polski
Tutorial: Eine GTM-Namenskonvention festlegen und im bestehenden Container durchsetzen

Management Summary
Eine Namenskonvention gibt den Bausteinen im Google Tag Manager einheitliche, verständliche Bezeichnungen. In einer umfangreichen Messkonfiguration wird dadurch schneller erkennbar, welche Aufgabe ein Element erfüllt. Das erleichtert Zusammenarbeit, Pflege und Prüfung. Die Umbenennung bestehender Elemente ist jedoch mehr als sprachliches Aufräumen: Andere Bausteine können sich auf die Namen beziehen. Eine nachvollziehbare Zuordnung alter und neuer Bezeichnungen erhält den Zusammenhang und hilft, die bisherige Messfunktion beim Wechsel zu bewahren.
Inhalt
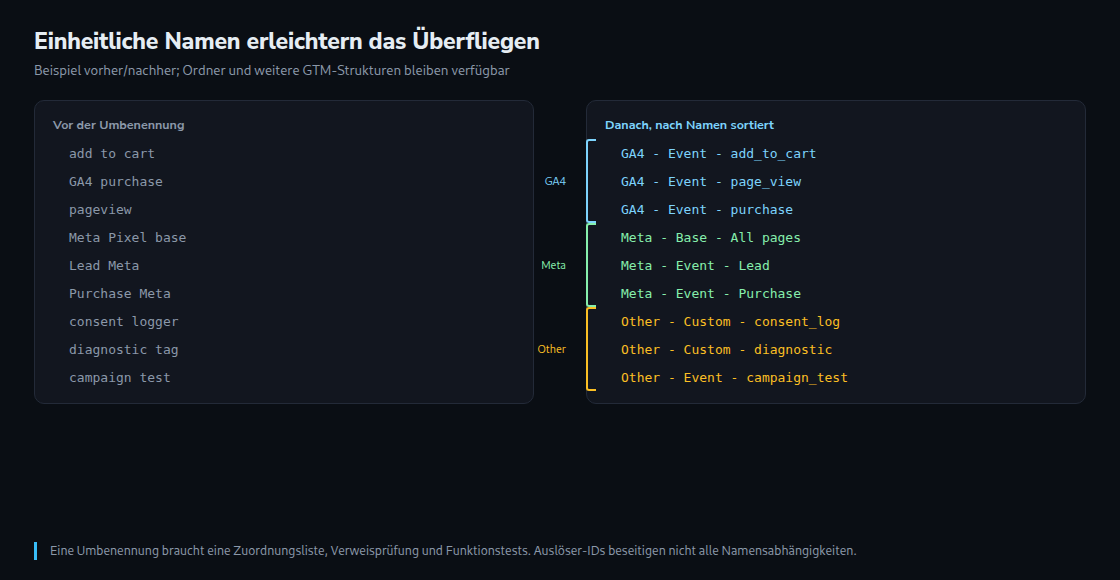
Eine einheitliche Namenskonvention erleichtert das Überfliegen, Suchen und Prüfen eines großen Google-Tag-Manager-Containers. Namen ergänzen Ordner, Elementtypen und die Arbeitsbereichsoberfläche. Das erste Wort ist nicht die einzige Ordnungsmöglichkeit. Eine sinnvolle Umstellung macht den Zweck der Elemente klarer und erhält das bisherige Messverhalten.
Ein kleines, eindeutiges Schema
Ein mögliches Schema verwendet drei Abschnitte für Tags und zwei für Auslöser sowie benutzerdefinierte Variablen. Das ist eine Projektentscheidung und keine GTM-Vorgabe. Das folgende Beispiel nutzt in allen Sprachfassungen gemeinsame englische Präfixe, damit derselbe Prüfer zu allen Beispielen passt.
GA4 - Event - add_to_cart
Meta - Event - purchase
Ads - Linker - All pages

CE - add_to_cart
PV - checkout
Click - header_cta

DLV - ecommerce.items
JS - item_list
Const - GA4 measurement ID
LT - country_code
CE steht hier für Custom Event (benutzerdefiniertes Ereignis), PV für Page View (Seitenaufruf), DLV für Data Layer Variable (Datenschichtvariable) und LT für Lookup Table (Zuordnungstabelle). JS bezeichnet in dieser Konvention eine benutzerdefinierte JavaScript-Variable. Diese Kürzel benötigen eine dokumentierte Bedeutung; GTM leitet daraus keinen Elementtyp ab.
Der einheitliche Trenner lautet - . Bei alphabetischer Namenssortierung stehen gemeinsame Präfixe beieinander. Gemischte Trenner erschweren die Einheitlichkeit, zerstören aber keine Sortierung. Im letzten Abschnitt bleibt ein relevanter technischer Bezeichner wie add_to_cart erhalten. Eine fachlich unabhängige Variable muss diesen Ereignisnamen nicht enthalten.
Die Plattform am Anfang passt zu einer nach Zielsystem organisierten Arbeit. Bei mehreren Websites kann die Website wichtiger sein; dafür braucht der Prüfer entsprechende Regeln. Ein Anzeigename wählt weder die Tag-Vorlage noch das versendete Ereignis aus. Alte Namen wie „GA4 Config“ sind deshalb keine verlässliche Angabe des heutigen Vorlagentyps. Auch Googles Oberflächenänderungen von 2026 sprechen gegen starre Annahmen über Menüs.
Mehr als nur das Präfix prüfen
Ein vollständiger Export des vorgesehenen Arbeitsbereichs bildet den Ausgangsstand. Ein Teilexport kann Abhängigkeiten auslassen und taugt nicht als Beleg für den vollständigen Containerzustand. Eine ContainerVersion enthält mehr als drei Listen; dieser Prüfer betrachtet bewusst nur Tags, Auslöser und benutzerdefinierte Variablen.
Das folgende Python-3-Beispiel wird als naming-audit.py gespeichert. Ein erlaubtes Präfix genügt nicht: GA4 - fällt wegen fehlender Abschnitte durch. Der Prüfer liest einen Oberflächenexport mit containerVersion oder eine direkte ContainerVersion-Antwort der API. Eingabefehler liefern Exitcode 2, Namensbefunde liefern 1 und eine abgeschlossene Namensprüfung ohne Befund liefert 0.
import json
import re
import sys
from pathlib import Path

# Project convention, not a Google requirement.
PREFIXES = {
    "tag": {"GA4", "Google", "Meta", "Ads", "LinkedIn", "TikTok", "Other"},
    "trigger": {"CE", "PV", "Click", "Form", "Timer", "Visible", "Other"},
    "variable": {"DLV", "JS", "Const", "LT", "URL", "Cookie", "Other"},
}
SEGMENTS = {"tag": 3, "trigger": 2, "variable": 2}
REF = re.compile(r"\{\{([^{}]+)\}\}")


def audit(document):
    if not isinstance(document, dict):
        raise ValueError("Expected a JSON object")
    version = document.get("containerVersion", document)
    if not isinstance(version, dict) or not version.get("containerId"):
        raise ValueError("Expected a container version with containerId")
    report = {"counts": {}, "violations": [], "references": []}
    for kind, allowed in PREFIXES.items():
        entities = version.get(kind, [])
        if not isinstance(entities, list):
            raise ValueError(f"{kind}: expected an array")
        report["counts"][kind] = len(entities)
        for index, entity in enumerate(entities):
            if not isinstance(entity, dict):
                raise ValueError(f"{kind}[{index}]: expected an object")
            name = entity.get("name")
            parts = name.split(" - ") if isinstance(name, str) else []
            valid = (len(parts) == SEGMENTS[kind]
                     and parts[0] in allowed
                     and all(part and part == part.strip()
                             and not any(ord(c) < 32 for c in part)
                             for part in parts))
            if not valid:
                report["violations"].append({
                    "kind": kind, "id": entity.get(kind + "Id"),
                    "index": index, "name": name,
                })

    def walk(value, path):
        if isinstance(value, dict):
            for key, child in value.items():
                walk(child, path + [key])
        elif isinstance(value, list):
            for index, child in enumerate(value):
                walk(child, path + [index])
        elif isinstance(value, str):
            for match in REF.finditer(value):
                report["references"].append({
                    "path": path, "kind": "braces", "name": match.group(1)
                })
            if path and path[-1] == "tagName":
                report["references"].append({
                    "path": path, "kind": "tagName", "name": value
                })
    walk(version, [])
    return report


def main():
    if len(sys.argv) != 2:
        print("Usage: python3 naming-audit.py export.json", file=sys.stderr)
        return 2
    try:
        document = json.loads(Path(sys.argv[1]).read_text(encoding="utf-8-sig"))
        report = audit(document)
    except (OSError, UnicodeError, ValueError) as exc:
        print(f"Input error: {exc}", file=sys.stderr)
        return 2
    print(json.dumps(report, ensure_ascii=False, indent=2))
    return 1 if report["violations"] else 0


if __name__ == "__main__":
sys.exit(main())python3 naming-audit.py export.json > naming-report.jsonDer JSON-Bericht enthält alle Namensbefunde und mögliche Referenzen mit einem strukturierten Fundpfad, der die genaue Stelle im Export zeigt. Die JSON-Dekodierung vor der Suche erfasst auch maskierte Klammern. Eine Begrenzung auf die ersten 30 Treffer entfällt. Erfasst werden Zeichenfolgen mit {{...}} und tagName; wörtliche Klammern, Notizen und dynamisch zusammengesetzte Namen benötigen weiterhin Einordnung. Das Verfahren ist weder ein GTM-Parser noch ein Beweis für vollständig aufgelöste Abhängigkeiten.
Die Namensprüfung klärt außerdem nicht, ob ein „DLV“-Element wirklich eine Datenschichtvariable ist, ob ein Tag noch benötigt wird oder ob eine Kampagne funktioniert. Das sind Aufgaben der fachlichen Prüfung. Ein altes Datum, unbekannter Name oder pausiertes Tag ist ein Prüfhinweis und keine automatische Löschentscheidung.
Verweise gesondert kontrollieren
Auslöserzuweisungen verwenden Felder wie firingTriggerId und blockingTriggerId. Daraus folgt keine generelle Folgenlosigkeit von Tag-Umbenennungen. Zusätzlich benötigen die Sequenzverweise unter setupTag[].tagName und teardownTag[].tagName eine Kontrolle im tatsächlichen Export; der Feldname allein ersetzt keine Prüfung des bezeichneten Ziels. Tag-Anzeigenamen können außerdem in Monitoring-Metadaten eingehen.
Variablenverweise enthalten Namen in doppelten geschweiften Klammern, auch in benutzerdefiniertem HTML und JavaScript. Für eine Umbenennung in der Oberfläche, ein API-Update und einen bearbeiteten JSON-Import lässt sich kein identisches Aktualisieren sämtlicher Verweise voraussetzen. Der vorgeschlagene Ablauf erfasst je Element eine Zeile mit Typ, ID, altem Namen und neuem Namen, benennt in einem getrennten Arbeitsbereich um und prüft den anschließenden Export. Automatische Referenzanpassungen müssen dort tatsächlich erkennbar sein.
Eine Vorher-Nachher-Liste der Referenzen hilft, reicht aber nicht aus. Ein unverändert alter Name kann weiterhin defekt sein; eine beabsichtigte Abweichung kann korrekt sein. Der inhaltliche Vergleich umfasst zusätzlich Auslöserbedingungen, Tag-Parameter, Tag-Reihenfolgen, Einwilligungseinstellungen, Pausenstatus und Code. Globales Suchen und Ersetzen kann versendete Werte oder beliebigen Code verändern und eignet sich daher nicht als Umbenennungsverfahren.
Umstellung und Abnahme
- Vollständigen Ausgangsexport, Containerkennung und Version beziehungsweise Arbeitsbereich festhalten.
- Präfixe, Bedeutung der Abschnitte und Ausnahmen vereinbaren; eine Umbenennungsliste anhand der IDs erstellen.
- Umbenennungen möglichst in einem eigenen Arbeitsbereich von Löschungen und Funktionsänderungen trennen.
- Nach Übernahme anderer Arbeitsbereichsänderungen Konflikte lösen und betroffene Vergleiche wiederholen.
- Vollständigen Ergebnisexport prüfen; betroffene Tags, Auslöser, Variablen und Tag-Reihenfolgen in der Vorschau testen.
- Abgenommene Änderungen vor der Veröffentlichung in der Versionsbeschreibung festhalten.
Die Vorschau führt den Entwurf auf einer verbundenen Website aus; Test-Tags können dabei reale Anfragen versenden. Eine Testumgebung mit passenden Testzielen verhindert eine Vermischung des Umbenennungstests mit Produktionsmessungen. Der Status „ausgelöst“ allein beweist keine korrekten Zieldaten. Zur Prüfung gehören die erwarteten Parameterwerte und Netzwerkanfragen.
Ein eigener Arbeitsbereich erleichtert Prüfung und Rücknahme, doch Container-Versionen bilden einen gemeinsamen Verlauf. Das Wiederherstellen einer älteren Version kann auch spätere unabhängige Änderungen zurücknehmen. Für die geplante Rücknahme sind Abhängigkeiten deshalb ebenso zu berücksichtigen wie bei der Umstellung.
Fragen und Antworten
Gehören integrierte Variablen zur Namensprüfung?
Nein. Integrierte Variablen wie Page URL werden getrennt von benutzerdefinierten Variablen verwaltet und stehen in einer Version unter builtInVariable. Die Namensregeln benennen diese Standardeinträge nicht um. Verweise auf integrierte Variablen können trotzdem im Bericht auftauchen.
Lässt sich die Prüfung automatisieren?
Die API-Methode accounts.containers.versions.live liefert die veröffentlichte ContainerVersion direkt und akzeptiert den Bereich tagmanager.readonly. Erforderlich sind API-Aktivierung, OAuth-Autorisierung und Zugriff auf das betreffende Konto beziehungsweise den Container; ein Dienstkonto ist eine unterstützte Möglichkeit. Leserechte vermeiden unnötige Schreibbefugnisse, ersetzen aber nicht den angemessenen Umgang mit Exporten und Zugangsdaten.
Die Live-Version enthält keine unfertigen Änderungen aus Arbeitsbereichen. Eine Arbeitsbereichsprüfung benötigt die entsprechenden Listen-Endpunkte einschließlich aller Ergebnisseiten oder einen vollständigen Arbeitsbereichsexport. Monatliche Prüfungen sind ein möglicher Rhythmus; für die Durchsetzung der Konvention ist eine Kontrolle vor jeder Veröffentlichung oft hilfreicher.
Wo gehört die Konvention hin?
Ein gepflegtes Teamdokument mit Verweis aus den Containernotizen sowie passenden Element- und Versionsnotizen lässt sich besser verwalten als ein künstliches Tag, das niemals auslösen darf. Ausnahmen gehören in dieselbe Dokumentation und in die Prüfkonfiguration. Ein Notiz-Tag außerhalb der Namensregeln würde sonst bei jedem Prüflauf erneut auffallen.
Quellen
- Google Tag Manager: Ordner
- Google Tag Manager: Container exportieren und importieren
- Google Tag Manager API: Tag-Ressource, SetupTag und TeardownTag
- Google Tag Manager: Benutzerdefinierte Tags
- Google Tag Manager: Benutzerdefinierte Variablentypen für Websites
- Google Tag Manager: Arbeitsbereiche
- Google Tag Manager: Container in der Vorschau prüfen
- Google Tag Manager API: ContainerVersion-Ressource
- Google Tag Manager API: versions.live
- Google Tag Manager API: Autorisierung
- Google Tag Manager API: Container-Ressource
- Google Tag Manager: Ankündigung zu Google Tag und Tag Manager
- Google Tag Manager: Änderungen an Google Tag und Tag Manager, 20. August 2026
- Google Tag Manager API: tags.list und Ergebnisseiten
Passend dazu


