English
 Deutsch
 Polski
Tutorial: Ustalenie konwencji nazw GTM i wprowadzenie jej w istniejącym kontenerze

Spis treści
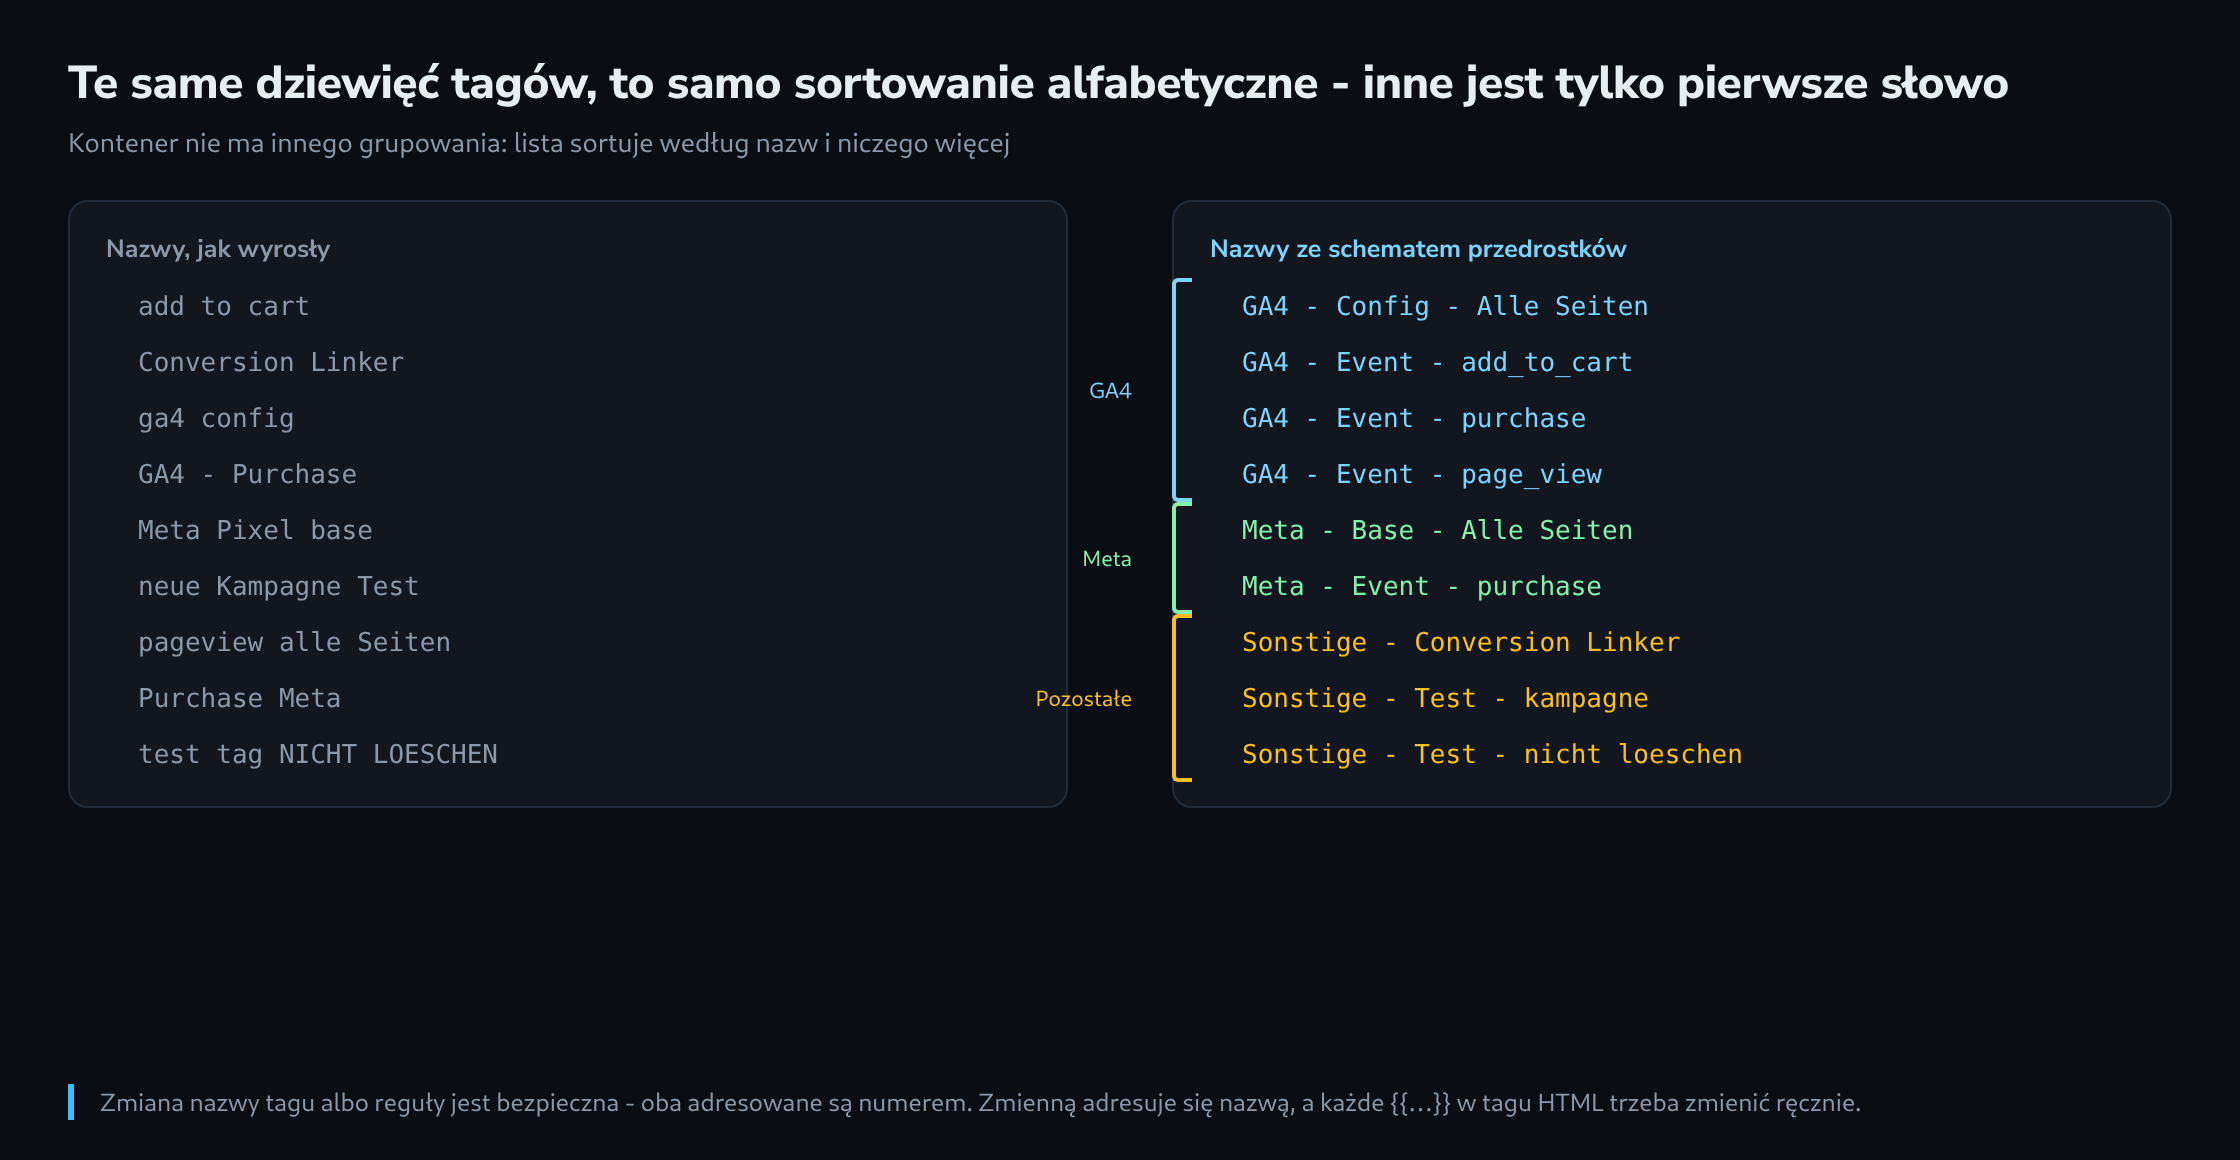
Kontener menedżera tagów nie ma folderów, które coś znaczą, ani typów, które grupują, ani wyszukiwania rozumiejącego strukturę. Ma listę posortowaną alfabetycznie, a ta lista stanowi cały interfejs do odnajdywania.
Przez to pierwsze słowo każdej nazwy jest jedynym istniejącym grupowaniem. Konwencja nie jest więc zamiłowaniem do porządku – jest różnicą między tagiem w trzy sekundy a trzystoma liniami do przeczytania.
Dlaczego nazwa jest jedynym porządkiem
Foldery istnieją i warto ich używać, lecz nie zmieniają nic w dwóch miejscach, w których nazwa jest naprawdę czytana: w polu wyszukiwania i w odwołaniu wewnątrz innego elementu. Reguła pojawia się pod tagiem pod własną nazwą, zmienna pojawia się w polu pod własną nazwą, a żadne z nich nie pokazuje, w którym folderze leży.
Sama lista jest drugim powodem. Sortowanie jest domyślnie alfabetyczne według nazwy, więc wszystko, co ma pojawiać się razem, musi zaczynać się od tych samych znaków. To warunek brzegowy, a nie upodobanie, a konwencja go pomijająca wytwarza nazwy opisowe i bezużyteczne.
Trzeci punkt wyznacza kierunek schematu: nazwy sortują się od lewej do prawej. Najważniejsze rozróżnienie należy więc na przód, a najdrobniejszy szczegół na koniec. Które rozróżnienie jest najważniejsze, to jedyne pytanie warte omówienia przed pierwszą nazwą – dla większości kontenerów jest nim platforma, bo od niej pytanie zwykle się zaczyna.
Konwencja przeżywająca trzysta tagów
Wystarczą trzy człony rozdzielone jednolicie. Więcej członów wygląda dokładniej i zostaje skrócone przez tego, komu się spieszy.
Tagi       <Platforma> - <Rodzaj> - <Co>
           GA4 - Event - add_to_cart
           GA4 - Config - Alle Seiten
           Meta - Event - purchase
           Sonstige - Conversion Linker

Reguly     <Rodzaj> - <Warunek>
           CE - add_to_cart
           PV - kasse
           Klick - cta-kopfbereich

Zmienne    <Zrodlo> - <Nazwa>
           DLV - ecommerce.items
           JS - artikelliste
           Const - GA4 Mess-ID
           LT - laendercode
Skróty rodzajów reguł i zmiennych są zamierzone. Są dość krótkie, by ciekawa część nazwy pozostała widoczna w wąskiej kolumnie, i skracają słowa, których używa sam interfejs (Custom Event, Page View, Data Layer Variable) – nikt nie musi więc uczyć się drugiego słownictwa.
Dwie zasady trzymają to razem pod presją. Rozdzielnik jest zawsze ten sam – spacja, myślnik, spacja – bo mieszanina myślników i dwukropków rozbija sortowanie w sposób trudny do zauważenia. A ostatni człon nosi nazwę techniczną dokładnie: tag do zdarzenia add_to_cart nazywa się add_to_cart, a nie Add to Cart – wyszukanie nazwy zdarzenia znajduje wtedy tag, regułę i zmienną za jednym razem.
Sprawdzenie zasobu
Eksport kontenera to plik JSON z trzema listami w środku, a sprawdzenie trzystu nazw wobec schematu jest krótkim skryptem, a nie popołudniem.
import json, re, sys

VORSATZ = {
    "tag":      re.compile(r"^(GA4|Meta|Ads|LinkedIn|TikTok|Sonstige) - "),
    "trigger":  re.compile(r"^(CE|PV|Klick|Formular|Timer|Sichtbar|Sonstige) - "),
    "variable": re.compile(r"^(DLV|JS|Const|LT|URL|Cookie|Sonstige) - "),
}

daten = json.load(open(sys.argv[1]))["containerVersion"]

for art, muster in VORSATZ.items():
    posten = daten.get(art, [])
    fehlt  = [p["name"] for p in posten if not muster.match(p["name"])]
    print(f"{art:9s} {len(posten) - len(fehlt):3d} von {len(posten):3d} nach Schema")
    for name in sorted(fehlt):
        print(f"            {name}")
Z pierwszego przebiegu wychodzą zwykle dwie trzecie zgodne ze schematem i jedna trzecia niezgodna – a ta jedna trzecia rozpada się na trzy grupy wymagające odmiennego potraktowania.
Nazwy po prostu stare po zmianie nazwy trzymają się schematu i nic więcej się nie dzieje. Nazwy opisujące coś, co nie jest już w użyciu – tag dla porzuconej platformy – są osobnym znaleziskiem i należą na listę do skasowania, a nie do przemianowania. A nazwy z osobą albo datą w środku – Test Anna 03.02. – to te do obejrzenia w pierwszej kolejności, bo zwykle oznaczają coś, co nigdy nie miało zostać.
Zmiana nazw bez rozerwania odwołania
Tutaj siedzi nierówność i to ona jest powodem, dla którego masowa zmiana nazw wymaga sprawdzenia krzyżowego.
Tagi i reguły są wewnętrznie adresowane numerem. Zmiana ich nazw nie zmienia niczego w innym miejscu, a reguła uruchamiająca tag robi to dalej pod każdą nazwą.
Przy zmiennych jest inaczej, bo zmienną adresuje się jej nazwą w podwójnych nawiasach klamrowych. GTM przy zmianie nazwy uzupełnia te odwołania w całym kontenerze – pole z {{DLV - artikel}} idzie razem, a według zgodnych źródeł branżowych także nawiasy zapisane jako tekst w tagu HTML niestandardowym albo w zmiennej JavaScript niestandardowej. Pomoc Google tego zachowania nie opisuje; czy zadziałało w danym kontenerze, pokazuje porównanie przed i po.
# znalezc wszystkie odwolania nazwowe w eksporcie przed zmiana nazw
grep -o '{{[^}]*}}' export.json | sort | uniq -c | sort -rn | head -30
Puszczenie tego przed i po jest całą siatką bezpieczeństwa. Lista adresowanych nazw powinna być identyczna poza tymi celowo zmienionymi, a każda niezamierzona różnica to odwołanie prowadzące teraz w próżnię – co GTM przy podglądzie i publikacji zgłasza jako błąd „Unknown variable”.
Wykonanie w jednym obszarze roboczym
Zmiana nazw dwustu elementów to jedna zmiana z dwustoma wpisami i należy do własnego obszaru roboczego z trzech powodów.
Powstająca z niej wersja jest pojedynczym wpisem w historii kontenera – i dokładnie tego potrzebuje koleżanka oglądająca listę zmian za pół roku. Obszar roboczy dzielony przez zmianę nazw ze zmianą merytoryczną czyni obie trudniejszymi do sprawdzenia i niemożliwymi do osobnego wycofania.
Podgląd działa wewnątrz obszaru roboczego dalej, więc cały kontener da się przed publikacją raz przejść – a przejść należy celowo każdy niestandardowy tag HTML, bo tam odwołania stoją w kodzie jako ciągi znaków i tam widać, czy zmiana nazwy je objęła.
A kontener da się wyeksportować z obszaru roboczego przed publikacją, co daje plik do porównania z poprzednim. Dwa eksporty, jeden grep i pytanie, czy coś się rozpadło, zostaje rozstrzygnięte bez zgadywania.
Utrzymanie tego stanu
Konwencja rozpada się w tempie, w jakim ludzie w pośpiechu coś dodają, a trzy nawyki hamują to mocniej niż dokument.
Skrypt sprawdzający należy tam, gdzie działa sam z siebie. Raz w miesiącu wobec świeżego eksportu wystarczy, a wynik jest krótki: albo wszystko pasuje, albo wymienia trzy elementy dołożone od ostatniego przebiegu.
Schemat należy do kontenera, a nie do wiki. Element notatkowy – tag, który nigdy nie działa, nazwany 0 - Namensschema, aby sortował się na górę – niesie konwencję tam, gdzie osoba właśnie coś nazywająca i tak patrzy.
A listę do skasowania z przeglądu warto odrobić, zamiast odłożyć. Kontener z czterdziestoma wstrzymanymi tagami, których nikt nie rozpoznaje, to kontener, w którym konwencja zostanie znowu pominięta, bo lista jest już nieczytelna – a najszybszą drogą do listy czytelnej jest lista krótsza.
Pytania i odpowiedzi
Czy zmienne dostarczane przez sam GTM, takie jak Page URL, też muszą trzymać się schematu?
Nie, i nawet nie mogą. Zmienne wbudowane (Built-in Variables), takie jak Page URL czy Click Classes, noszą nazwy nadane przez Google; da się je włączać i wyłączać, ale nie da się zmienić ich nazw. W eksporcie kontenera znajdują się na osobnej liście builtInVariable, a nie pod variable, więc skrypt sprawdzający sam je pomija. Na liście odwołań z grep wprawdzie się pojawiają, ale przed zmianą nazw i po niej pozostają takie same i nie zakłócają porównania.
Czy comiesięczne sprawdzenie da się uruchamiać bez każdorazowego ręcznego eksportu kontenera?
Tak, przez Tag Manager API. Zwraca ono opublikowaną wersję kontenera z tymi samymi listami tag, trigger i variable, które zawiera eksport. Różnica leży w opakowaniu: eksport z interfejsu umieszcza wersję pod kluczem containerVersion, a odpowiedź API jest samą wersją. Skrypt wymaga więc jedynie drobnej zmiany w miejscu, w którym wczytuje plik.
Do dostępu wystarczy konto usługi z uprawnieniem do odczytu (Read) kontenera i zakres tagmanager.readonly. Uprawnienia do zapisu są przy sprawdzaniu zbędne i lepiej, żeby ich nie było: zadanie, które niczego nie może zmienić, niczego też nie zepsuje. Konto usługi dodaje się w zarządzaniu użytkownikami kontenera przez podanie jego adresu e-mail, tak samo jak osobę.
Pozostaje jedna różnica w porównaniu z eksportem: opublikowana wersja nie pokazuje tego, co właśnie powstaje w otwartych obszarach roboczych. Sprawdzenie także nieopublikowanych nazw wymaga dodatkowego odczytu obszarów roboczych, które API również udostępnia.
Czy przy kontenerze obsługującym kilka witryn na początek nazwy powinna trafić witryna?
Tylko wtedy, gdy większość pytań kierowanych do kontenera zaczyna się od witryny. Platforma stoi na początku, bo od niej zwykle zaczyna się wyszukiwanie; przy kontenerze dla kilku witryn tym punktem wyjścia może być witryna. Liczy się to, żeby wybór zapadł raz i obowiązywał wszystkie elementy, bo schemat zaczynający się raz od platformy, a raz od witryny, rozbija sortowanie tak samo jak mieszane rozdzielniki.
Powiązane artykuły