English
 Deutsch
 Polski
Automatyzacja walidacji zdarzeń GA4 i Meta CAPI w BigQuery

Spis treści
- 1. Architektura rozwiązania: Dwustrumieniowe śledzenie zdarzeń
- 2. Przygotowanie schematu BigQuery krok po kroku
- 3. Budowa zapytania walidującego SQL krok po kroku
- 4. Konfiguracja automatycznego powiadamiania krok po kroku
- 5. Podsumowanie i wartość architektoniczna
- Pytania i odpowiedzi
- Źródła
- Kontrola w praktyce: uzgodnienie zamówień z eksportem sklepu
- Przygotowanie pliku CSV Analytics w BigQuery
- Kontrola praktyczna: tablica items przed wysłaniem
Precyzyjna atrybucja konwersji w nowoczesnym marketingu cyfrowym wymaga równoległego przesyłania zdarzeń: po stronie klienta (w przeglądarce) za pomocą Google Analytics 4 (GA4) oraz po stronie serwera za pomocą Meta Conversions API (CAPI). Ograniczenia przeglądarek, mechanizmy Intelligent Tracking Prevention (ITP), blokerom reklam oraz wahania sieciowe często powodują jednak rozbieżności pomiędzy strumieniami danych z przeglądarki i serwera. Wdrożenie zautomatyzowanego potoku walidacji zdarzeń w Google BigQuery pozwala zespołom inżynierii danych na codzienne monitorowanie spójności konwersji, wykrywanie utraconych transakcji w codziennym przebiegu oraz sprawdzanie, czy oba strumienie niosą ten sam klucz deduplikacji.
1. Architektura rozwiązania: Dwustrumieniowe śledzenie zdarzeń
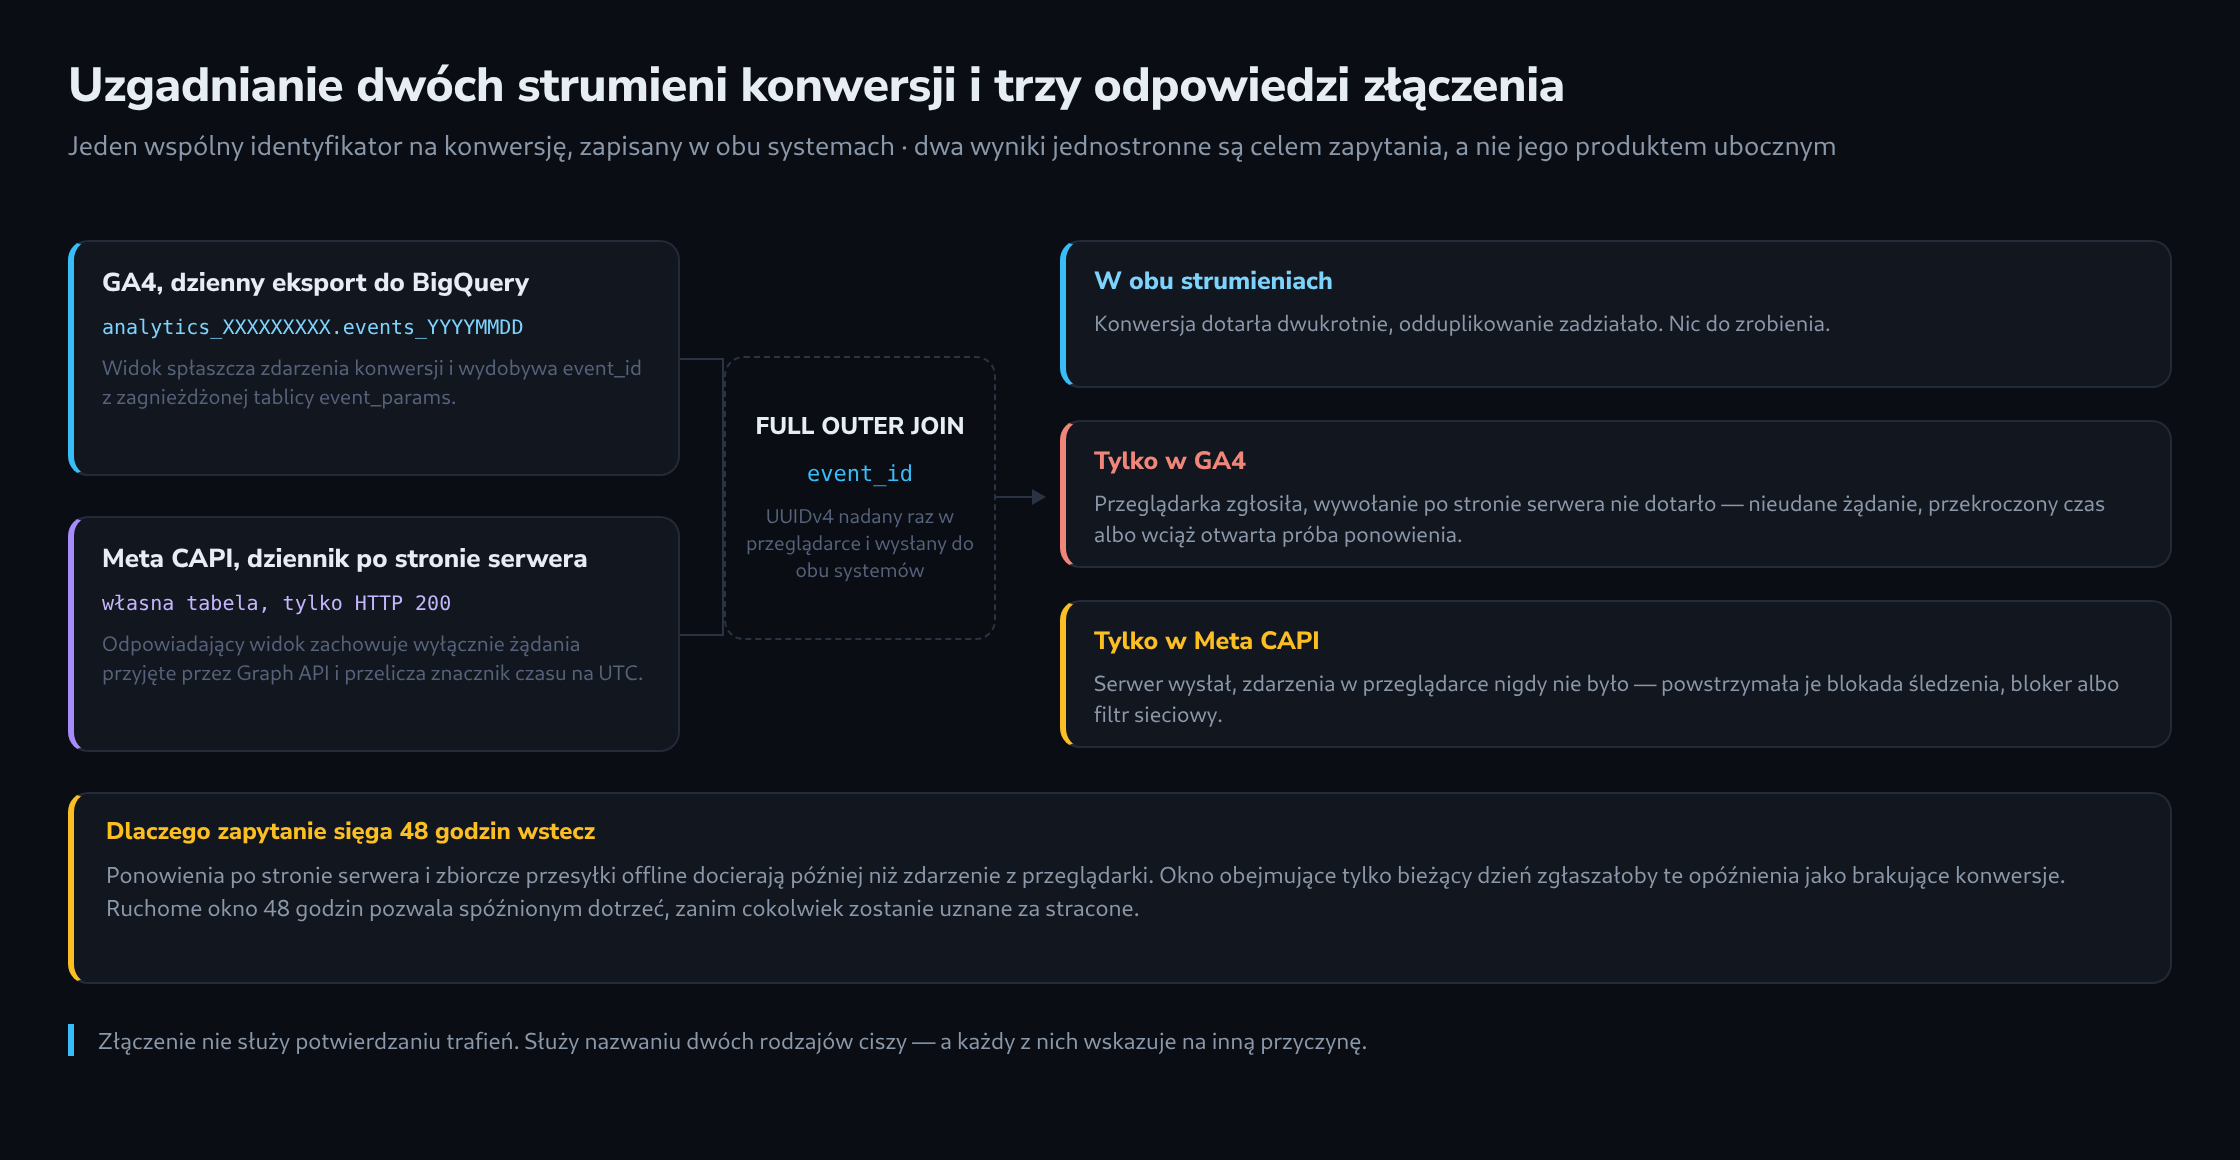
Uzgodnienie strumieni danych GA4 i Meta CAPI wymaga zastosowania wspólnego, niezmiennego identyfikatora kryptograficznego w obu systemach. Model walidacji opiera się na trzech kluczowych elementach:
- Klucz deduplikacji (
event_id/transaction_id): Każde zdarzenie konwersji wygenerowane w aplikacji internetowej musi otrzymywać unikalny ciąg UUIDv4. Ciąg ten jest przesyłany równocześnie jako parametr niestandardowy w GA4 (event_id) oraz jako natywny parametrevent_idw ładunku danych Meta CAPI. - Codzienny eksport GA4 do BigQuery: Surowe strumienie zdarzeń są automatycznie eksportowane do zestawu danych
analytics_XXXXXXXXX.events_YYYYMMDD. - Serwerowa tabela logów Meta CAPI: Dedykowana tabela w BigQuery (zasilana np. przez tagi logujące po stronie serwerowego Google Tag Managera lub własne punkty końcowe webhook), w której zapisywane są wszystkie wychodzące żądania CAPI oraz kody odpowiedzi HTTP.
2. Przygotowanie schematu BigQuery krok po kroku
Aby umożliwić dokładne złączenie danych w języku SQL, oba strumienie muszą zostać znormalizowane do postaci widoków przejściowych (staging views):
- Ekstrakcja konwersji GA4: Utworzenie w BigQuery dedykowanego widoku, który rozkłada zagnieżdżone zdarzenia konwersji GA4 (takie jak
purchaselubgenerate_lead) i wyodrębnia parametrevent_idz tablicyevent_params. - Ekstrakcja logów serwerowych Meta CAPI: Utworzenie odpowiedniego widoku na podstawie tabeli logów serwerowych, filtrowanego pod kątem udanych odpowiedzi HTTP 200 z Meta Graph API, ze standaryzacją znacznika czasu do strefy UTC.
- Partycjonowanie okna czasowego: Ponieważ ponowne próby wysyłki po stronie serwera lub nocne importy wsadowe mogą opóźnić dotarcie danych CAPI, zapytania weryfikujące muszą analizować ruchome, 48-godzinne okno czasowe, co eliminuje fałszywe alarmy o brakujących konwersjach.
3. Budowa zapytania walidującego SQL krok po kroku
Poniższe produkcyjne zapytanie SQL wykonuje operację FULL OUTER JOIN pomiędzy znormalizowanymi strumieniami konwersji GA4 i Meta CAPI, kategoryzując każdą transakcję w celu ujawnienia cichej utraty danych:
WITH ga4_events AS (
    SELECT
        event_date,
        TIMESTAMP_MICROS(event_timestamp) AS ga4_event_time,
        (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'event_id') AS event_id,
        event_name
    FROM
        `project_id.analytics_XXXXXXXXX.events_*`
    WHERE
        _TABLE_SUFFIX BETWEEN FORMAT_DATE('%Y%m%d', DATE_SUB(CURRENT_DATE(), INTERVAL 5 DAY))
            AND FORMAT_DATE('%Y%m%d', DATE_SUB(CURRENT_DATE(), INTERVAL 1 DAY))
        AND event_name IN ('purchase', 'generate_lead')
),
capi_events AS (
    SELECT
        DATE(event_timestamp) AS event_date,
        event_timestamp AS capi_event_time,
        event_id,
        event_name AS capi_event_name
    FROM
        `project_id.meta_capi_logs.outbound_events`
    WHERE
        DATE(event_timestamp) BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 5 DAY) AND CURRENT_DATE()
        AND http_status_code = 200
)
SELECT
    COALESCE(g.event_id, c.event_id) AS event_id,
    g.event_name AS ga4_name,
    c.capi_event_name AS capi_name,
    CASE
        WHEN g.event_id IS NOT NULL AND c.event_id IS NOT NULL THEN 'MATCHED_BOTH'
        WHEN g.event_id IS NOT NULL AND c.event_id IS NULL THEN 'MISSING_IN_META_CAPI'
        WHEN g.event_id IS NULL AND c.event_id IS NOT NULL THEN 'MISSING_IN_GA4_BROWSER'
    END AS reconciliation_status
FROM
    ga4_events g
FULL OUTER JOIN
    capi_events c
    ON g.event_id = c.event_id
WHERE
    DATE(COALESCE(g.ga4_event_time, c.capi_event_time)) = DATE_SUB(CURRENT_DATE(), INTERVAL 3 DAY);
4. Konfiguracja automatycznego powiadamiania krok po kroku
W celu pełnego zautomatyzowania nadzoru operacyjnego bez konieczności ręcznego uruchamiania zapytań SQL, należy skonfigurować harmonogram i alerty:
- Zapytanie harmonogramowane (Scheduled Query): W konsoli BigQuery przejść do sekcji
Schedule > Create Scheduled Query. Ustawić codzienną dawkę wykonania na godzinę 06:00 UTC (po zakończeniu nocnego eksportu GA4) i zapisać wyniki w tabeli monitorującejanalytics_validation.daily_capi_reconciliation. - Widok kontroli progu błędu: Utworzenie zapytania agregującego, które oblicza dzienny procent rozbieżności:
SELECT COUNTIF(reconciliation_status != 'MATCHED_BOTH') / COUNT(*) * 100 AS error_rate_pct FROM `analytics_validation.daily_capi_reconciliation`; - Polityka alarmowa Cloud Monitoring: W usłudze Google Cloud Monitoring utworzyć wskaźnik oparty na logach z wykonania zapytania harmonogramowanego. Należy skonfigurować politykę alarmową, która automatycznie wyśle powiadomienie na webhook Slack lub PagerDuty, jeśli wskaźnik rozbieżności przekroczy poziom 5,0% w dowolnym 24-godzinnym oknie.
5. Podsumowanie i wartość architektoniczna
Co da się osiągnąć dzięki temu poradnikowi: Wdrożenie w pełni zautomatyzowanego potoku walidacji SQL i powiadamiania w BigQuery, który codziennie porównuje zdarzenia przeglądarkowe GA4 z logami serwerowymi Meta Conversions API przy użyciu unikalnych kluczy deduplikacji.
Wynikająca z tego wartość: Zespoły analityki oraz marketingu efektywnościowego uzyskują pełną przejrzystość i wiarygodność danych o konwersjach. Rozbieżności spowodowane błędami skryptów, restrykcjami Safari ITP, blokerami reklam lub awariami punktów końcowych po stronie serwera są sygnalizowane przy codziennym przebiegu. Ponadto weryfikacja spójności parametrów event_id w obu kanałach pokazuje, czy zdarzenia serwerowe niosą ten sam identyfikator co zdarzenia GA4 wysłane z przeglądarki. To jeden z warunków, by Meta rozpoznała zdarzenie piksela i zdarzenie CAPI tej samej konwersji jako duplikat na podstawie tego identyfikatora i nazwy zdarzenia, o ile piksel wysyła ten sam identyfikator. Sama deduplikacja odbywa się po stronie Meta i zapytanie jej nie sprawdza.
Pytania i odpowiedzi
Czy dla event_id należy utworzyć w GA4 wymiar niestandardowy?
Do uzgadniania nie. Eksport do BigQuery zawiera w event_params każdy wysłany parametr, zarejestrowany czy nie. W raportach taki wymiar niewiele by dał: prawie każda wartość występuje tylko raz, a przy wymiarach o bardzo wielu wartościach raporty zbierają rzadsze z nich w wierszu „(other)”.
Jak uwzględnić w zapytaniu ruchome okno 48 godzin?
Zapytanie z sekcji 3 czyta w tym celu po obu stronach szerszy okres, niż ocenia:
- Odczyt obu stron z kilku dni: tabel dziennych GA4 z ostatnich pięciu dni i logów CAPI od tego samego dnia aż do bieżącego dnia włącznie.
- Złączenie nadal po event_id, ale ocenie podlega tylko dzień kalendarzowy UTC sprzed trzech dni. Przy uruchomieniu o 06:00 UTC od jego najmłodszego zdarzenia minęły 54 godziny, więc transmisje CAPI opóźnione w granicach okna 48 godzin zdążyły już dotrzeć. Młodsze dni zostają ocenione w kolejnych uruchomieniach.
- Granica według znaczników czasu zamiast tabel dziennych. _TABLE_SUFFIX i event_date podążają za strefą czasową usługi GA4, a event_timestamp i przeliczone na UTC znaczniki czasu CAPI nie. W usłudze ustawionej na czas środkowoeuropejski zakup tuż po północy trafiłby w przeciwnym razie do innej tabeli dziennej GA4 niż jego wpis CAPI według daty UTC i pojawiłby się jako brakujący w dwóch dniach, raz po każdej stronie. Tabele dzienne wyznaczają więc tylko zakres odczytu, a oceniany dzień wynika ze znacznika czasu zdarzenia.
Dzienny wskaźnik rozbieżności odnosi się zatem do dnia, którego zdarzenia mają już za sobą te 48 godzin, a nie do dnia poprzedniego, który wciąż się uzupełnia.
Jak zgoda wpływa na wskaźnik rozbieżności?
Potencjalnie mocniej niż awarie techniczne, do których wykrywania zbudowano nadzór. W wielu wdrożeniach zdarzenie CAPI wychodzi tylko przy zgodzie na ciasteczka marketingowe, podczas gdy GA4 w trybie zaawansowanym Consent Mode także przy odmowie wysyła zdarzenie bez ciasteczek, które pojawia się w eksporcie. Każda konwersja bez zgody marketingowej trafia wtedy do tabeli monitorującej jako MISSING_IN_META_CAPI, choć wszystko działa zgodnie z założeniami. Jeśli udział takich zdarzeń przekracza 5,0%, wskaźnik trwale leży powyżej progu alarmowego z sekcji 4.
Rozwiązaniem jest pole, które eksport dostarcza przy każdym zdarzeniu: privacy_info.ads_storage. Dołączone do części zapytania dotyczącej GA4 oddziela luki oczekiwane od nieoczekiwanych, o ile zgoda dla Meta jest powiązana z tą samą kategorią co ad_storage. Zdarzenia z wartością 'No’ dostają własny status i nie wchodzą do wskaźnika błędów; wartości puste w tym polu wymagają osobnej decyzji, bo nie oznaczają tego samego co odmowa.
Kontrola w praktyce: uzgodnienie zamówień z eksportem sklepu
Narzędzie Porównanie przychodów sklepu i GA4 porównuje dwa pliki CSV lokalnie. Wspólnym kluczem jest identyfikator zamówienia. Dane osobowe klientów nie są potrzebne: wystarczą ID zamówienia, kwota i waluta.
- Przygotowanie eksportów dla tego samego okresu i strefy czasowej, z identycznym traktowaniem podatków, dostawy i zwrotów. Pozycje towarów i zwroty wymagają wcześniejszego zsumowania do uzgodnionej kwoty na zamówienie.
- Wybór separatora i znaku dziesiętnego dla każdego pliku, wczytanie i przypisanie kolumn ID, kwoty i waluty. Zera na początku identyfikatora pozostają zachowane.
- Wybór liczby miejsc dziesiętnych i jawnej tolerancji na zamówienie. Bez przeliczania walut.
- Kontrola osobnych grup: brak po jednej stronie, powtórzone ID, inna waluta i kwota poza tolerancją.
- Eksport wyniku i sprawdzenie konkretnych zamówień w systemach źródłowych.
Powtórzone ID są oznaczane zamiast sumowania: ponowne wysłanie zakupu, eksport pozycji i wiersz zwrotu wymagają odmiennej interpretacji. Ujemne kwoty są akceptowane jako liczby, lecz definicja biznesowa nadal musi się zgadzać. Brak zamówienia w Analytics może wynikać ze zgody, momentu pomiaru, filtrów lub błędów zbierania; sam w sobie nie dowodzi wadliwego tagu. Zerowa różnica nie potwierdza eksportu wszystkich zamówień. Narzędzie nie sumuje kwot w różnych walutach.
Definicje wynikają z wybranego eksportu i dokumentacji ecommerce GA4. Schemat Data API rozróżnia ID transakcji i metryki przychodu; ogólny przychód całkowity nie musi odpowiadać kwocie zamówienia sklepu.
Przygotowanie pliku CSV Analytics w BigQuery
Pomocnik eksportu w porównywarce przychodów tworzy zapytanie o zakupy dla istniejącego dziennego eksportu GA4. Projekt, zbiór danych, daty i precyzja zaokrąglania są wprowadzane lokalnie. Strona nie wykonuje SQL ani nie żąda dostępu do BigQuery.
Kolumny wyniku transaction_id, amount i currency odpowiadają polom porównania. Każdy zarejestrowany zakup pozostaje wierszem. Dodatkowa liczba zdarzeń zakupu pomaga znaleźć powtarzające się identyfikatory transakcji; nie są one automatycznie sumowane ani usuwane. Brak kwoty nie jest zastępowany zerem.
- Przed eksportem sklepu uzgodnienie definicji kwoty zakupu i granic dni. Zapytanie pomija zwroty oraz nie dodaje osobno podatków i dostawy.
- Wygenerowanie SQL, walidacja w BigQuery i sprawdzenie szacowanych kosztów. Przed wykonaniem ustawienie maksymalnej liczby rozliczanych bajtów.
- Zapis całego wyniku jako lokalnego CSV. W porównaniu wybór przecinka jako separatora, kropki dziesiętnej i tej samej precyzji co w zapytaniu.
- Kontrola powtarzających się identyfikatorów i brakujących pól przed interpretacją różnic kwot. Porównanie obsługuje do 20 000 wierszy danych na plik. Identyfikatory w arkuszach powinny pozostać tekstem.
Dwa fikcyjne pliki CSV do pobrania zapewniają powtarzalny pierwszy test, po jednym przypadku w każdej z sześciu grup wyników. Są niezależne od SQL i używają dwóch miejsc dziesiętnych oraz zerowej tolerancji.
Źródła: schemat eksportu GA4, walidacja zapytań i kontrola kosztów oraz zapisywanie wyników jako CSV.
Kontrola praktyczna: tablica items przed wysłaniem
Zdarzenie e-commerce może dotrzeć do Google mimo błędnych danych produktów. GA4 E-Commerce Item Array Validator sprawdza tablicę JSON lokalnie i wskazuje konkretne pole, na przykład items[0].price. Cena zapisana w cudzysłowie, taka jak "12.50", jest zgłaszana jako błąd typu zamiast automatycznej zamiany na liczbę.
Kontrola rozróżnia błędy i uwagi. Powtórzone identyfikatory produktów mogą oznaczać warianty i nie dowodzą podwójnego zarejestrowania zakupów. Brak ceny uniemożliwia obliczenie pełnej wartości. Ilość zero pozostaje zerem, a brak ilości oznacza jeden. Suma uwzględnia cenę po rabacie, bez podatku i wysyłki. Waluta i identyfikator transakcji na poziomie zdarzenia nadal wymagają osobnej kontroli.
Przydatny przebieg pracy łączy kontrolę tablicy, sprawdzenie rzeczywistego żądania sieciowego i późniejsze uzgodnienie zamówień. Poprawna struktura nie dowodzi poprawnego zbierania ani raportowania danych. Podstawą są przewodnik Google po e-commerce oraz dokumentacja purchase.
Powiązane artykuły