English
 Deutsch
 Polski
Wzbogacanie danych w Server-Side GTM: Wyszukiwanie CRM w czasie rzeczywistym z Firestore i BigQuery

Spis treści
Wzbogacanie danych w Server-Side GTM: Wyszukiwanie CRM w czasie rzeczywistym z Firestore i BigQuery
Nowoczesne architektury marketingu cyfrowego przesyłają wartości konwersji, wartość życiową klienta (LTV) oraz marże zysku do platform reklamowych. Należą do nich Google Analytics 4 (GA4) i Meta Conversions API (CAPI). Jednocześnie rygorystyczne regulacje prawne oraz zasady bezpieczeństwa danych zabraniają ujawniania danych osobowych (PII), wskaźników scoringowych czy marż operacyjnych w warstwie DataLayer po stronie przeglądarki.
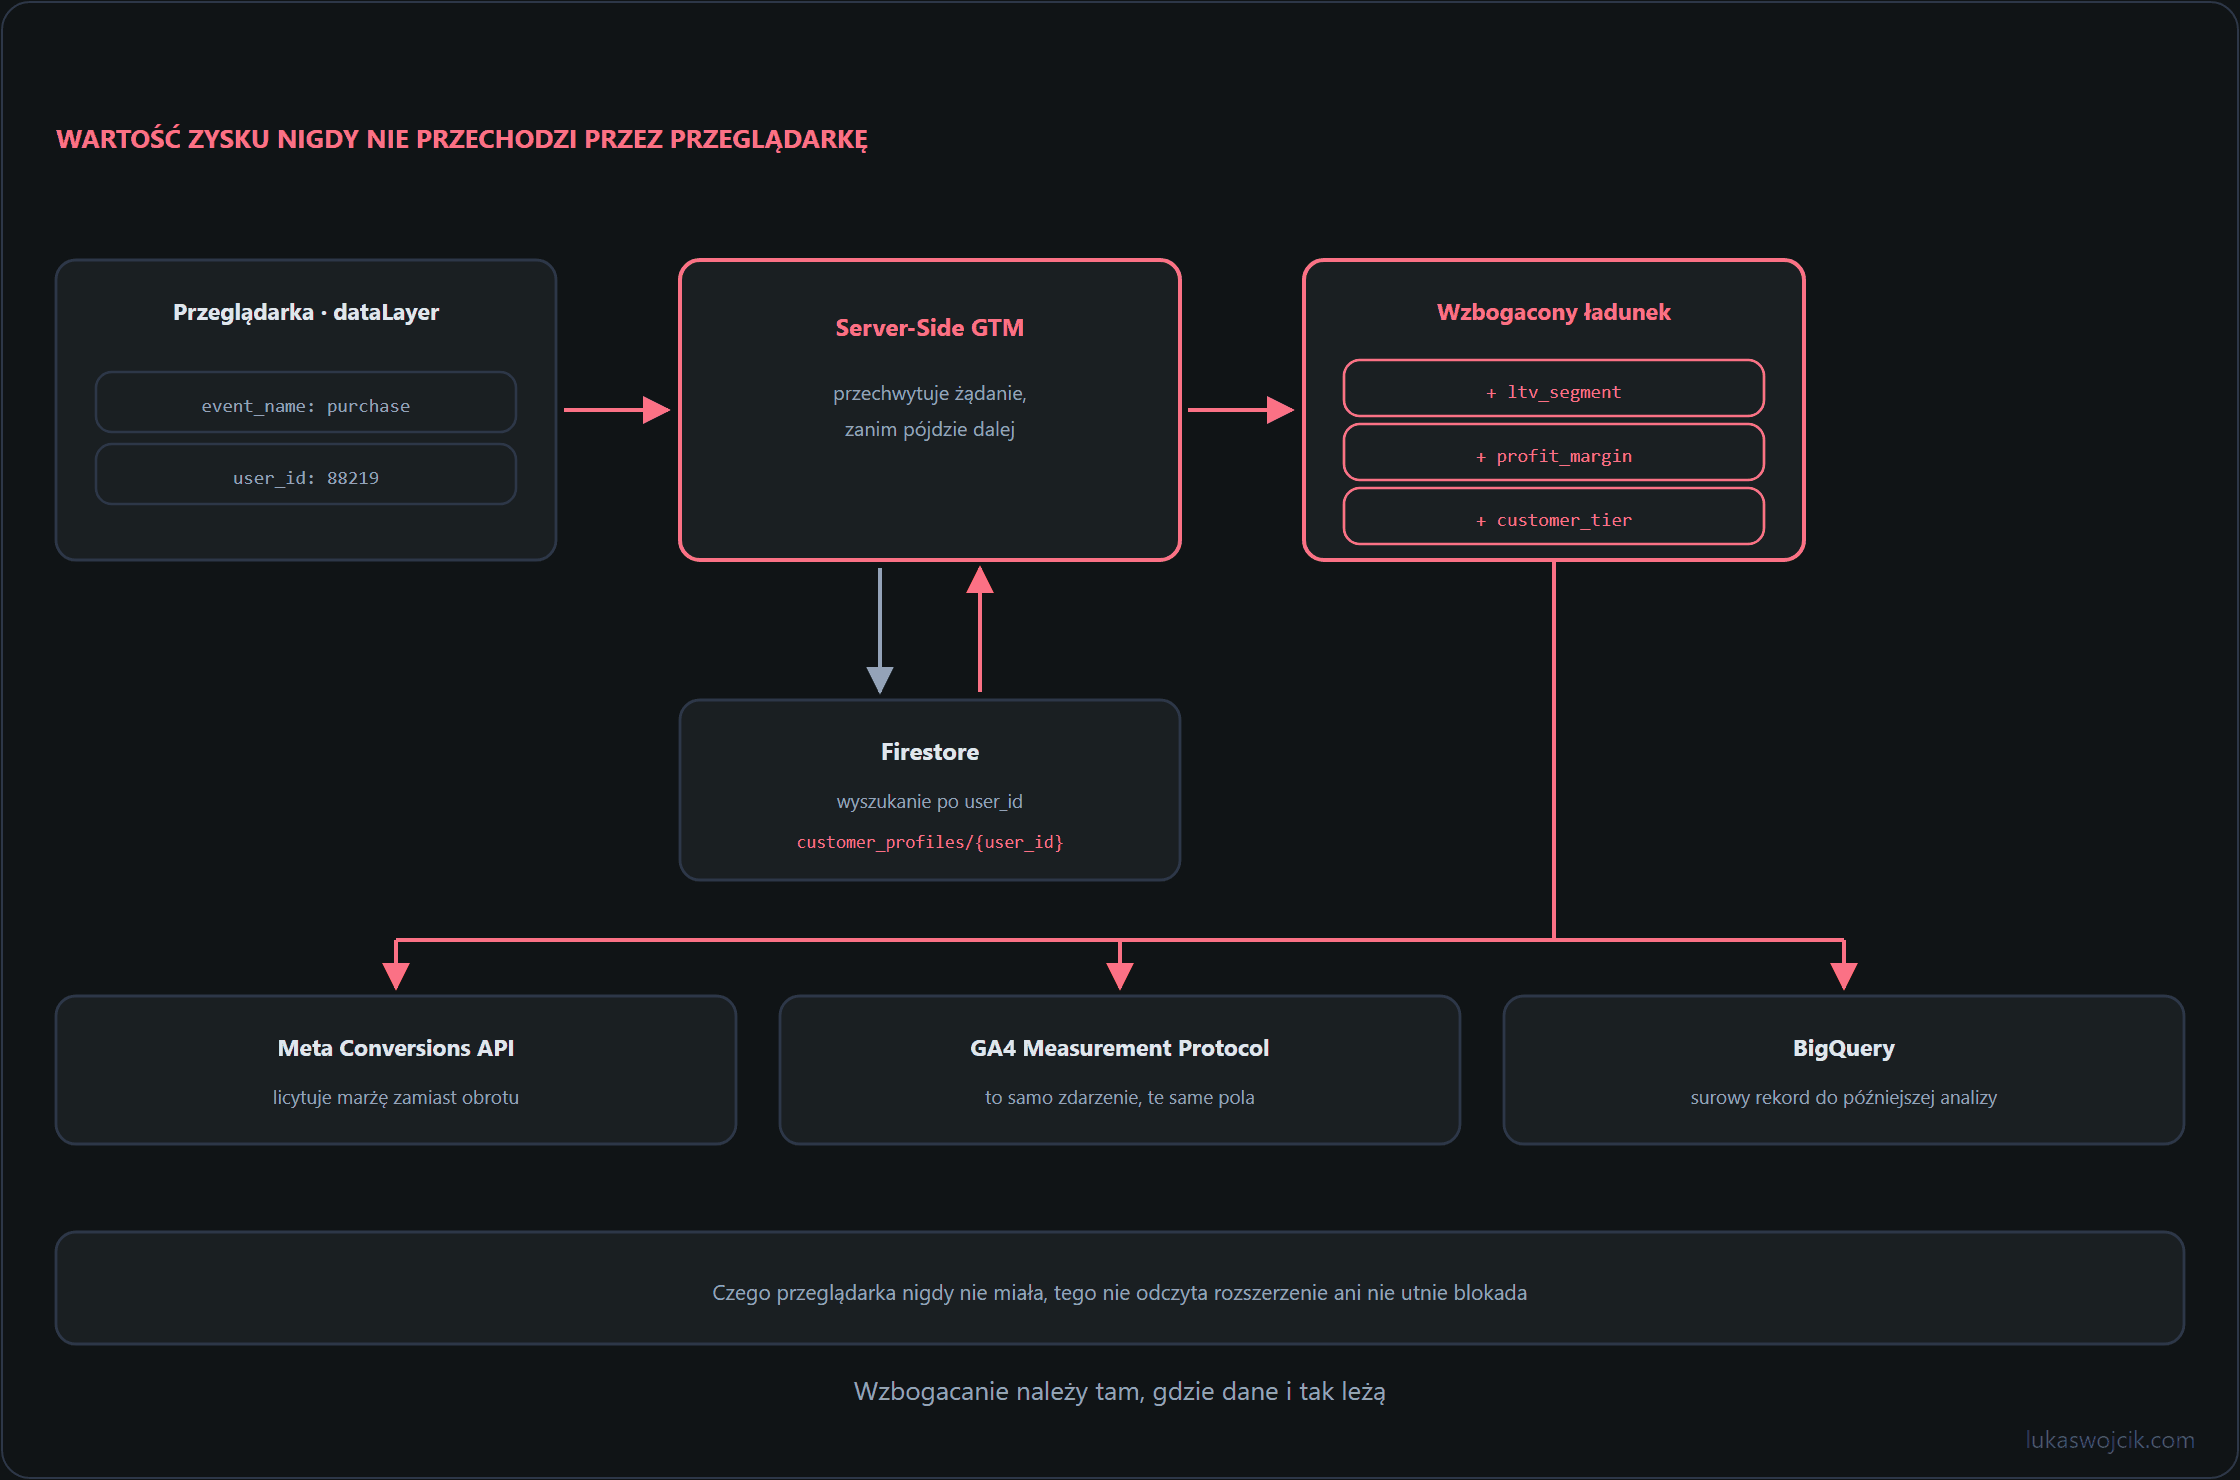
Rozwiązaniem tego problemu jest serwerowe wzbogacanie danych (Server-Side Data Enrichment). Poprzez przechwytywanie przychodzących zdarzeń analitycznych w kontenerze Server-Side Google Tag Manager (ssGTM), anonimowe identyfikatory mogą być w czasie rzeczywistym dopasowywane do baz danych przed wysłaniem pakietów do zewnętrznych systemów reklamowych.
1. Architektura chroniąca prywatność
Zamiast przesyłania poufnych atrybutów CRM bezpośrednio do przeglądarki klienta, za pomocą standardowych tagów śledzących emitowany jest wyłącznie anonimowy identyfikator — taki jak zaszyfrowane User-ID, numer klienta lub token sesji. Pakiet wysyłany po stronie klienta pozostaje całkowicie wolny od danych PII oraz krytycznych wskaźników biznesowych.
| Warstwa | Dozwolone dane | Dane chronione (Zablokowane) |
|---|---|---|
| Przeglądarka (DataLayer) | Anonimowe User-ID, Session-ID, SKU, Transaction-ID | PII (E-mail, Telefon), Marże zysku, Segmenty klienta, Scoring LTV |
| Server-Side GTM (Edge) | Zapytania w czasie rzeczywistym do API Firestore / BigQuery | Niezakodowane PII w logach lub żądaniach HTTP |
| Systemy docelowe (CAPI / GA4) | Wzbogacone atrybuty: customer_tier, profit_margin, haszowane PII | Surowe schematy baz danych lub niehaszowane dane osobowe |
2. Firestore a BigQuery w zapytaniach czasu rzeczywistego
Wybór odpowiedniego silnika bazodanowego w Google Cloud Platform (GCP) ma kluczowe znaczenie dla utrzymania niskich opóźnień w całej architekturze analitycznej:
- Google Cloud Firestore: Nierelacyjna baza dokumentowa zaprojektowana do zapytań o czasach odpowiedzi poniżej milisekundy. Stanowi rekomendowany standard dla zapytań czasu rzeczywistego w ssGTM. Atrybuty takie jak segment klienta, prawdopodobieństwo zwrotu czy marża mogą być pobierane błyskawicznie przy użyciu anonimowego identyfikatora User-ID jako klucza dokumentu.
- Google BigQuery: Hurtownia danych skalowalna do petabajtów. Choć BigQuery idealnie sprawdza się w zaawansowanych analizach i modelowaniu LTV, wyższe opóźnienia zapytań sprawiają, że silnik ten jest mniej odpowiedni do synchronicznego wzbogacania tagów. Zamiast tego BigQuery służy do okresowego wyliczania metryk klientów i eksportowania ich do bazy Firestore.
3. Kroki wdrożeniowe w Server-Side GTM
Techniczna realizacja opiera się na trzyetapowym potoku wzbogacania danych:
- Przechwycenie żądania: Przychodzące żądanie HTTP GA4 dociera do kontenera ssGTM, niosąc ze sobą anonimowy parametr
user_id. - Wykonanie zapytania do Firestore: Za pomocą dedykowanej zmiennej lub tagu asynchronicznego kontener odpytuje bazę GCP Firestore:
// Przykładowa logika zmiennej ssGTM odpytującej Firestore const firestore = require("Firestore"); const userId = getEventData("user_id"); return firestore.read("customer_profiles/" + userId).then((doc) => { return { ltv_segment: doc.ltv_segment || "standard", profit_margin: doc.profit_margin || 0.0 }; }); - Przekazanie wzbogaconego pakietu: Tagi docelowe — takie jak Meta CAPI — odczytują zasilone atrybuty ze zmiennej i przesyłają je do platformy reklamowej bez ich ekspozycji w przeglądarce użytkownika.
Podsumowanie
Serwerowe wzbogacanie danych stanowi pomost pomiędzy zgodnością z przepisami o ochronie prywatności a zaawansowaną optymalizacją marketingu. Przechowywanie poufnych danych CRM w bezpiecznych bazach Google Cloud Firestore i dynamiczne odpytywanie ich na poziomie serwera gwarantuje najwyższą jakość zasilania GA4 i Meta CAPI przy jednoczesnym wyeliminowaniu wycieków danych po stronie klienta.
Pytania i odpowiedzi
Jaką tożsamością posługuje się serwerowy kontener GTM przy odczycie z Firestore i jak wąsko da się ograniczyć jego uprawnienia?
Przy wdrożeniu na Cloud Run posługuje się kontem usługi przypisanym do tej usługi, a domyślne konto obliczeniowe jest tu najgorszym możliwym wyborem, bo bywa uprawnione znacznie szerzej, niż wymaga odczyt jednej kolekcji.
Skutek jest niewidoczny do momentu incydentu: kontener przyjmujący publiczny ruch HTTP ma prawo zapisu do bazy z danymi klientów. Nic w codziennej pracy tego nie ujawnia, bo do odczytu wystarcza mniej, a nikt nie sprawdza, do czego jeszcze te uprawnienia by wystarczyły.
Konfiguracja z minimalnym zakresem to dedykowane konto usługi i rola ograniczona do odczytu. Reguły bezpieczeństwa Firestore nie obejmują dostępu przez konto usługi, a uprawnienia IAM da się zawęzić najwyżej do całej bazy, nie do pojedynczej ścieżki dokumentów; węższy zakres daje dopiero osobna baza albo osobny projekt, w którym leżą wyłącznie atrybuty potrzebne do wzbogacania. Dodatkowo warto rozdzielić tożsamość zapisującą dane z BigQuery do Firestore od tej, którą posługuje się kontener: pierwsza pisze i nie musi odpowiadać na ruch z internetu, druga odpowiada i nie musi pisać.
Powiązane artykuły