English
 Deutsch
 Polski
Tutorial: Eksport danych z GA4 do BigQuery i pierwsze zapytanie SQL

Spis treści
Interfejs GA4 odpowiada na pytania, do których został zaprojektowany. Wszystko poza tym kształtem — sekwencja stron w sesji, kohorta zdefiniowana dwoma warunkami w określonej kolejności, metryka, której interfejs nie oferuje — trafia na ograniczenia narzędzia raportowego zbudowanego na danych wstępnie zagregowanych. Eksport do BigQuery zdejmuje ten sufit, udostępniając surowy strumień zdarzeń: jeden wiersz na zdarzenie, odpytywalny w SQL.
Poniższy przewodnik obejmuje trzy rzeczy potrzebne na start: włączenie eksportu, zrozumienie, co surowe dane zawierają, a czego nie, w porównaniu z interfejsem, oraz napisanie pierwszego zapytania rekonstruującego ścieżki użytkowników z zagnieżdżonego schematu zdarzeń.
Krok 1: Włączenie eksportu
Połączenie tworzy się w GA4 w sekcji Administracja, w obszarze połączeń z usługami, przez połączenia BigQuery. Wymaga to uprawnień do edycji usługi GA4 oraz uprawnień właściciela docelowego projektu Google Cloud z włączonym interfejsem BigQuery API. Konfiguracja pyta o projekt Cloud, lokalizację danych, strumienie danych do uwzględnienia oraz częstotliwość eksportu.
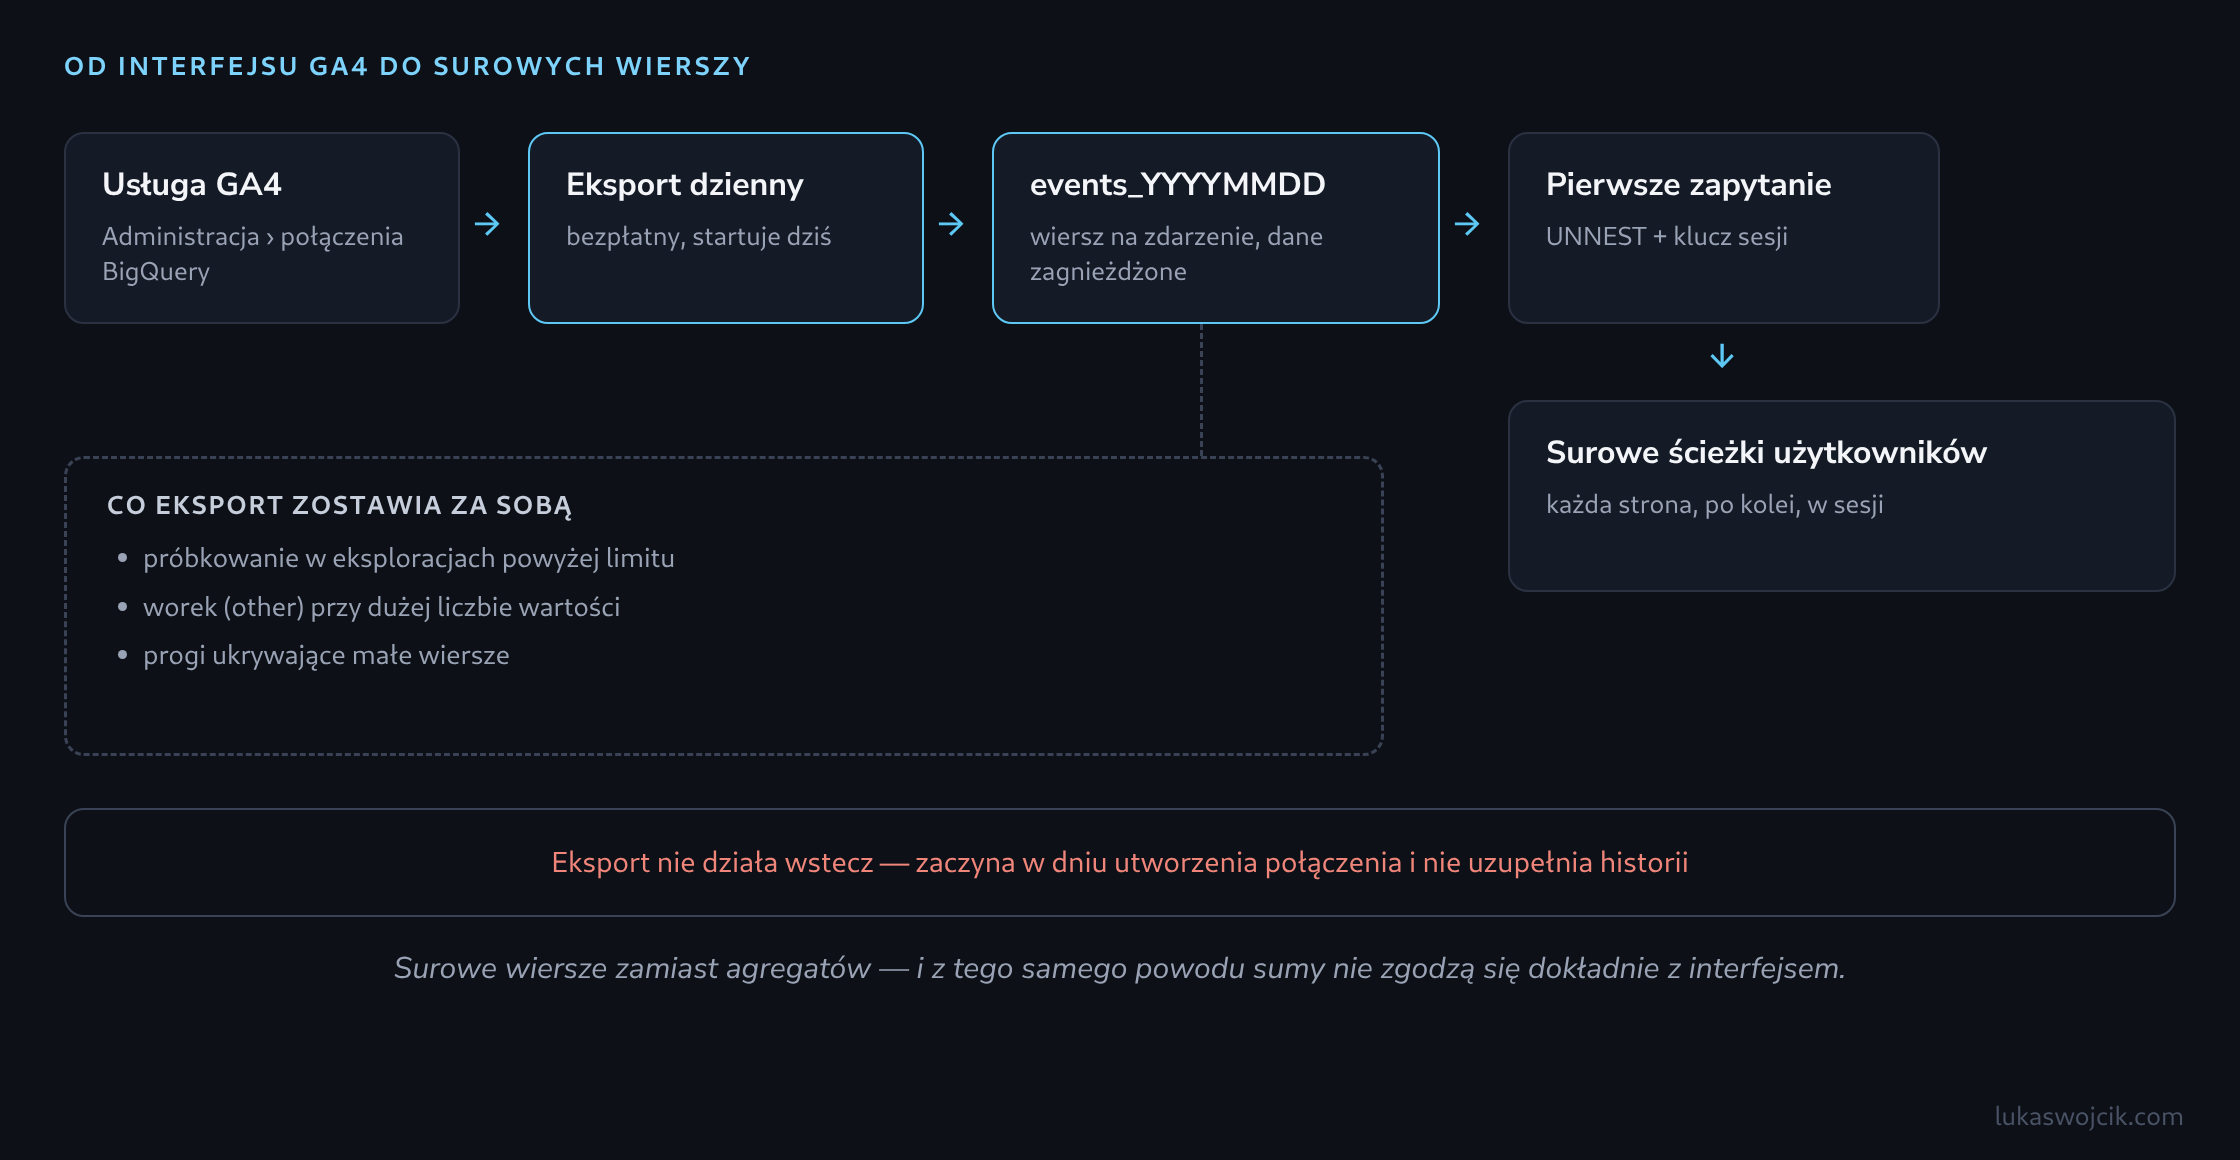
Do wyboru są dwie częstotliwości i zachowują się różnie. Dzienna zapisuje jedną tabelę na dobę, events_YYYYMMDD, zwykle dostępną następnego dnia; dla usług standardowych jest wliczona bez opłat. Strumieniowa zapisuje na bieżąco do events_intraday_YYYYMMDD i jest rozliczana według stawek BigQuery za wstawianie strumieniowe. Do poznania danych i do większości analiz wystarcza sam eksport dzienny.
Dwa ograniczenia mają znaczenie, zanim cokolwiek na tym stanie. Eksport nie działa wstecz — zaczyna w dniu utworzenia połączenia i nie uzupełnia historii, dlatego włączenie go wcześnie opłaca się nawet bez natychmiastowego zastosowania dla danych. Usługi standardowe podlegają też udokumentowanemu dziennemu limitowi eksportu wynoszącemu milion zdarzeń na dobę; jego przekroczenie może skutkować zawieszeniem eksportu, więc bieżący wolumen warto zestawić z limitem w dokumentacji Google, zanim eksport stanie się elementem nośnym.
Po stronie BigQuery bezpłatny poziom obejmuje 10 GiB przestrzeni i 1 TiB przetworzonych danych zapytań miesięcznie, co dla pojedynczej usługi eksplorowanej ręcznie jest wartością hojną.
Krok 2: Co naprawdę oznacza „bez próbkowania”
Uniknięcie próbkowania w eksporcie nie jest techniką — wynika z tego, że eksport jest niezagregowanym strumieniem zdarzeń, a nie raportem. Trzy odrębne redukcje stosowane przez interfejs są tam po prostu nieobecne:
- Próbkowanie w eksploracjach. Raporty standardowe w GA4 nie są próbkowane, natomiast eksploracje sięgają po próbkowanie, gdy zapytanie przekroczy limit zdarzeń właściwy dla danego poziomu usługi — wynik niesie wtedy stosowną informację.
- Wiersz
(other). Gdy wymiar generuje więcej odrębnych wartości, niż raport jest w stanie pomieścić, reszta zostaje zwinięta do jednego worka(other)— realny problem przy ścieżkach stron, identyfikatorach produktów czy frazach wyszukiwania. - Progi (thresholding). Przy aktywnych sygnałach Google wiersze reprezentujące bardzo niewielu użytkowników są w całości wstrzymywane, żeby nie dało się nikogo zidentyfikować, a zamiast danych pojawia się informacja o zastosowaniu progu.
Żadna z tych trzech redukcji nie dotyczy wyeksportowanych tabel. Ceną jest to, że wszystko, co interfejs nadbudowuje nad surowymi danymi — modelowane konwersje, atrybucja oparta na danych, własna definicja sesji — również tam nie występuje. Właśnie dlatego sumy z BigQuery i sumy z interfejsu nie zgodzą się dokładnie.
Krok 3: Kształt danych
Każdy wiersz to jedno zdarzenie. Osoby przychodzące z klasycznego SQL najbardziej zaskakuje to, że interesujące wartości nie są kolumnami: siedzą w event_params, powtarzalnym rekordzie par klucz-wartość, w którym sama wartość jest strukturą z osobnym polem na każdy typ.
| Pole | Typ | Co zawiera |
|---|---|---|
event_date |
STRING | Dzień w formacie YYYYMMDD, zgodny z sufiksem tabeli. |
event_timestamp |
INT64 | Mikrosekundy od epoki — klucz porządkujący wewnątrz sesji. |
event_name |
STRING | page_view, session_start, purchase oraz zdarzenia własne. |
user_pseudo_id |
STRING | Identyfikator klienta — urządzenie lub przeglądarka, nie osoba. |
event_params |
REPEATED RECORD | Pary klucz-wartość: ga_session_id, page_location, page_title i pozostałe. |
items |
REPEATED RECORD | Produkty e-commerce powiązane ze zdarzeniem. |
Sesja nie ma własnej kolumny. Rekonstruuje się ją, łącząc user_pseudo_id z parametrem ga_session_id, ponieważ identyfikatory sesji są unikalne wyłącznie w obrębie jednego klienta.
Krok 4: Pierwsze zapytanie potwierdzające, że eksport działa
Przed czymkolwiek analitycznym jedno zapytanie potwierdza, że dane napływają, a odwołanie do tabeli jest poprawne:
SELECT
  event_date,
  COUNT(*) AS events,
  COUNT(DISTINCT user_pseudo_id) AS users
FROM `project.analytics_XXXXXXXXX.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20260920' AND '20260926'
GROUP BY event_date
ORDER BY event_date;
Filtr _TABLE_SUFFIX nie jest opcjonalnym porządkowaniem. Symbol wieloznaczny events_* odwołuje się naraz do wszystkich tabel dziennych w zbiorze, a bez filtra sufiksu zapytanie skanuje całą historię eksportu — rozliczaną według odczytanych bajtów.
Krok 5: Wyciągnięcie surowych ścieżek użytkowników
Zapytaniem, którego interfejs nie potrafi zwrócić, jest pełna sekwencja stron w sesji. Odczyt wartości z event_params realizuje się podzapytaniem skalarnym po UNNEST — to konstrukcja warta zapamiętania, bo powraca w każdym zapytaniu do GA4:
WITH page_views AS (
  SELECT
    user_pseudo_id,
    (SELECT value.int_value FROM UNNEST(event_params)
      WHERE key = 'ga_session_id') AS session_id,
    event_timestamp,
    (SELECT value.string_value FROM UNNEST(event_params)
      WHERE key = 'page_location') AS page_location
  FROM `project.analytics_XXXXXXXXX.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260920' AND '20260926'
    AND event_name = 'page_view'
)
SELECT
  CONCAT(user_pseudo_id, '-', CAST(session_id AS STRING)) AS session_key,
  COUNT(*) AS page_views,
  STRING_AGG(
    REGEXP_EXTRACT(page_location, r'^https?://[^/]+([^?#]*)'),
    ' > ' ORDER BY event_timestamp
  ) AS path
FROM page_views
WHERE session_id IS NOT NULL
GROUP BY session_key
HAVING page_views > 1
ORDER BY page_views DESC
LIMIT 100;
Każdy wiersz to droga jednej sesji w kolejności, z usuniętą domeną i query stringiem, dzięki czemu identyczne strony grupują się razem. Stąd ta sama struktura odpowiada na bardziej szczegółowe pytania: ograniczenie do sesji zawierających konkretne zdarzenie, policzenie, jak często jedna strona poprzedza drugą, albo zmierzenie, ile kroków poprzedza zakup.
Pozostając w granicach
Dwie rzeczy warto ustalić, zanim te dane trafią do raportu. Liczby z eksportu nie uzgodnią się dokładnie z interfejsem GA4 i jest to założenie projektowe, a nie usterka do ścigania: interfejs nakłada na surowe dane modelowanie i własną logikę sesji, których tam nie ma. Eksport niesie też dane na poziomie zdarzeń dotyczące identyfikowalnych urządzeń, więc ta sama podstawa zgody i dyscyplina retencji, które obowiązują dla danych analitycznych, obowiązują również dla zbioru w Cloud — łącznie z tym, komu przyznawany jest dostęp do projektu.
Pytania i odpowiedzi
Czy events_* liczy zdarzenia podwójnie, gdy włączony jest eksport strumieniowy?
Z filtrem sufiksu z kroku 4 nie, bez niego być może tak. Symbol wieloznaczny events_* obejmuje także tabele events_intraday_YYYYMMDD, bo ich nazwy również zaczynają się od events_. Dla nich _TABLE_SUFFIX nie brzmi wtedy 20260926, lecz intraday_20260926.
Warunek _TABLE_SUFFIX BETWEEN '20260920' AND '20260926' wyklucza te tabele, ponieważ porównanie odbywa się znak po znaku, a litera i przy sortowaniu wypada za wszystkimi cyframi. Kto potrzebuje danych z bieżącego dnia z tabeli intraday, musi więc dołączyć ją wprost, na przykład dodatkowym warunkiem _TABLE_SUFFIX = 'intraday_20260927'.
Podwójnie zapytanie może liczyć dopiero wtedy, gdy bez filtra sufiksu albo ze zbyt szerokim wzorcem obejmie oba rodzaje tabel, a dla tego samego dnia istnieją obie. Zapytanie łączące oba źródła powinno więc dla każdego dnia liczyć tylko jedno z nich.
Czy LIMIT 100 obniża koszt zapytania?
Nie. BigQuery rozlicza bajty, które zapytanie musi odczytać, a LIMIT ogranicza jedynie wynik, gdy dane są już odczytane. Ponieważ BigQuery przechowuje dane kolumnami, oszczędzają natomiast dwa inne zabiegi: wybór tylko potrzebnych kolumn zamiast SELECT * oraz filtr na _TABLE_SUFFIX, który wyłącza z rachunku całe tabele dzienne.
Czy okres przechowywania ustawiony w GA4 dotyczy także tabel w BigQuery?
Nie. Ustawienie przechowywania danych w GA4 dotyczy danych w samym GA4. To, co raz trafiło do BigQuery, leży tam jako osobna kopia w projekcie Cloud i zostaje, dopóki nie zostanie tam usunięte. Pozostawiony sam sobie zbiór rośnie więc z dnia na dzień, a razem z nim zajmowana przestrzeń, która może w końcu przekroczyć bezpłatne 10 GiB.
Dyscyplinę retencji, której artykuł wymaga także dla zbioru, trzeba zatem ustawić w BigQuery. Służy do tego domyślny czas wygaśnięcia tabel ustawiany na zbiorze (w API pole defaultTableExpirationMs); nowe tabele dzienne są wtedy usuwane automatycznie po upływie tego okresu. Dotyczy to wyłącznie tabel utworzonych po zmianie; starsze tabele potrzebują własnego czasu wygaśnięcia albo usuwa się je ręcznie.
Czy eksport działa także bez konta rozliczeniowego w Google Cloud?
Tak, BigQuery działa wtedy jako piaskownica (sandbox), ale z dwoma ograniczeniami, które dla GA4 mają znaczenie. Tabele w piaskownicy wygasają po 60 dniach, więc eksport dzienny nigdy nie przechowuje więcej niż około dwóch miesięcy. Eksport strumieniowy nie jest tam natomiast dostępny. Do poznania danych to wystarcza; zbudowanie długiego szeregu czasowego wymaga konta rozliczeniowego, nawet jeśli wykorzystanie mieści się w ramach bezpłatnego poziomu.
Powiązane artykuły