English
 Deutsch
 Polski
Tutorial: Ein SEO- und GEO-Sichtbarkeits-Dashboard auf Basis der Search Console API

Inhalt
Die Oberfläche der Search Console beantwortet eine Suchanfrage nach der anderen. Sie zeigt die obersten Zeilen, exportiert tausend davon und bietet keinen Weg, danach zu fragen, ob die Sichtbarkeit für ein ganzes Thema steigt, während Markensuchen lediglich stabil bleiben. Diese Frage verlangt gruppierte Anfragen, und Gruppieren verlangt sowohl mehr Zeilen, als die Oberfläche herausgibt, als auch einen Ort, an dem sich die Gruppen definieren lassen.
Die folgende Anleitung baut genau das: die Daten über die Search Console API ziehen, Anfragen mit regulären Ausdrücken in Looker Studio kategorisieren und die entstehenden Cluster lesen – mitsamt einer ehrlichen Darstellung dessen, was diese Daten über direkt auf der Ergebnisseite erzeugte Antworten nicht zeigen können.
Was die API liefert und die Oberfläche nicht
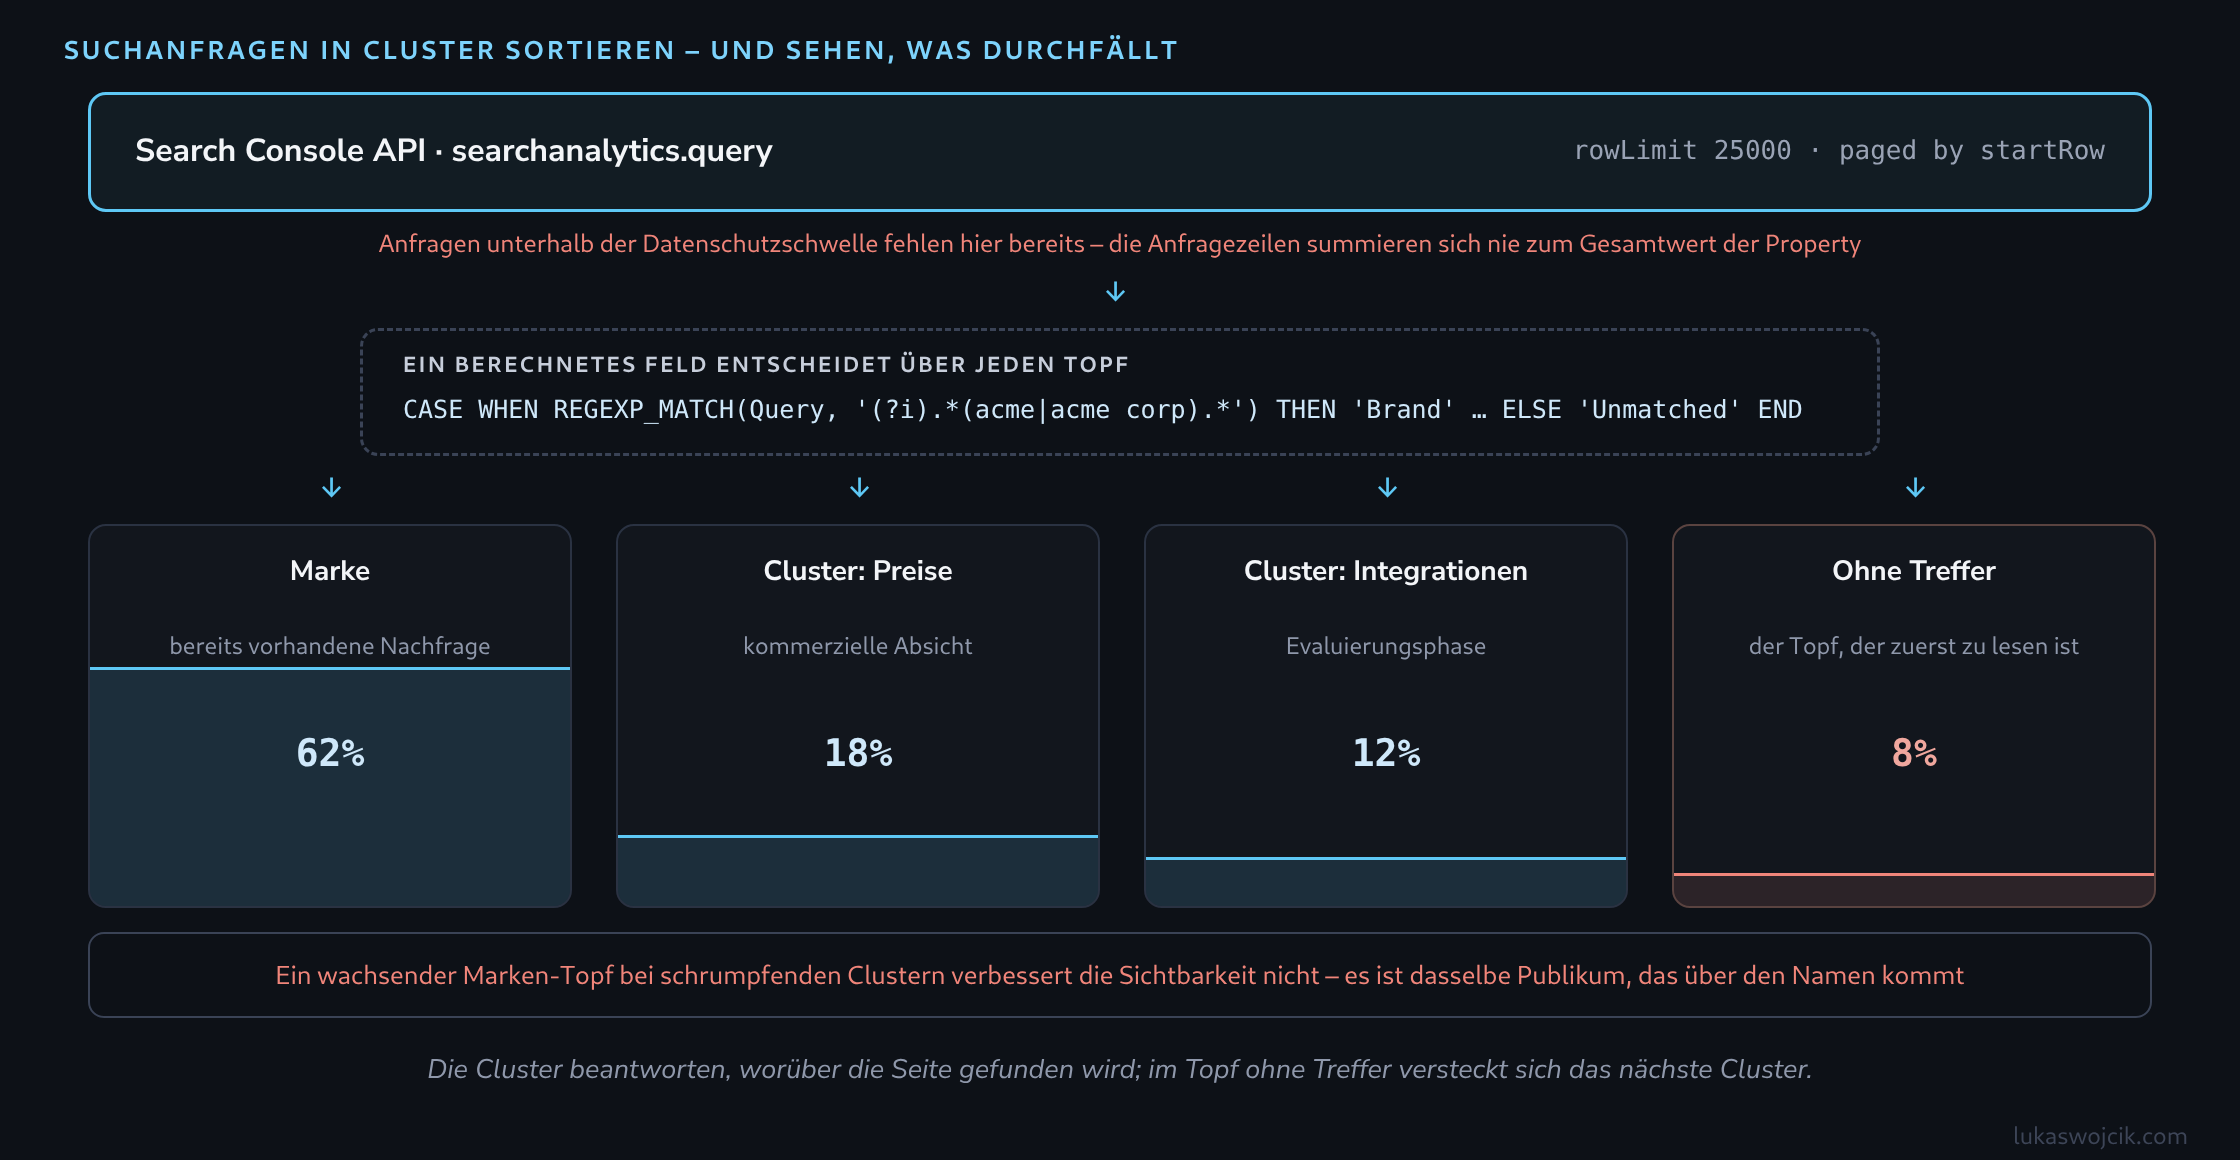
Der Leistungsbericht exportiert bis zu tausend Zeilen. Die Methode searchanalytics.query der API liefert bis zu 25.000 je Anfrage und blättert den Rest über startRow durch – das ist der Unterschied zwischen dem Kopf der Verteilung und dem langen Ende, in dem neue Themen zuerst auftauchen.
POST https://searchconsole.googleapis.com/webmasters/v3/sites/
     https%3A%2F%2Fexample.com%2F/searchAnalytics/query

{
  "startDate": "2026-07-01",
  "endDate": "2026-07-31",
  "dimensions": ["query"],
  "rowLimit": 25000,
  "startRow": 0,
  "dimensionFilterGroups": [{
    "filters": [{
      "dimension": "query",
      "operator": "includingRegex",
      "expression": "(?i)(preis|kosten|lizenz)"
    }]
  }]
}
Für ein Dashboard ruft der native Search-Console-Connector von Looker Studio dieselbe API ohne jeden Code auf – der praktische Weg, sofern die Daten nicht ohnehin in einem Warehouse landen. Eine strukturelle Einschränkung sollte vor jedem Entwurf bekannt sein: Der Connector bietet eine Tabelle auf Property-Ebene und eine auf URL-Ebene – Suchanfrage und Zielseite lassen sich nur in der Tabelle auf URL-Ebene kombinieren. Deren Zahlen sind je Seite zusammengefasst und ergeben deshalb nicht die Summen der Property-Ebene. Das ist eine Eigenschaft der Search-Console-Daten selbst und kein Fehler des Connectors, und kein berechnetes Feld umgeht sie.
Zwei Regex-Regeln, an denen das Ganze hängt
Beide Stellen, an denen sich ein regulärer Ausdruck schreiben lässt, verhalten sich anders, als es von Regex anderswo gewohnt ist.
Die Search Console verwendet RE2, ohne Lookahead und ohne Lookbehind. Der vertraute Kniff für Nicht-Marke – ein negativer Lookahead, der den Markennamen ausschließt – lässt sich schlicht nicht kompilieren. Der unterstützte Weg ist die Umkehrung des Filters selbst: ein eigener Regex-Filter auf stimmt nicht überein, mit dem Markenmuster als Ausdruck.
REGEXP_MATCH in Looker Studio verlangt, dass das Muster den gesamten Feldwert trifft, nicht einen Ausschnitt davon. Ein Muster acme trifft nur die Anfrage, die exakt das Wort acme ist; wer jede Anfrage treffen will, die es enthält, muss die Platzhalter ausschreiben:
-- Feld: Marke vs. Nicht-Marke
CASE
  WHEN REGEXP_MATCH(Query, '(?i).*(acme|acme corp|acmecorp|acme app).*')
    THEN 'Marke'
  ELSE 'Nicht-Marke'
END
Das Kennzeichen (?i) macht den Abgleich in beiden Systemen unabhängig von Groß- und Kleinschreibung. Die Markenalternation lohnt sich von Anfang an großzügig: Tippfehler, die Schreibweise mit und ohne Leerzeichen sowie der Produktname gehören in den Marken-Topf, denn jede davon, die draußen bleibt, bläht die Nicht-Marken-Zahl mit Suchen auf, die nie über Inhalte gewonnen wurden.
Aus Themen Cluster machen
Dieselbe Konstruktion, erweitert, wird zur Dimension, auf der das Dashboard aufbaut. Die Reihenfolge zählt – der erste zutreffende Zweig gewinnt, die Marke gehört also nach vorn, sonst landet eine markenbezogene Suche nach einer Funktion im Cluster dieser Funktion:
-- Feld: Anfrage-Cluster
CASE
  WHEN REGEXP_MATCH(Query, '(?i).*(acme|acmecorp).*')              THEN 'Marke'
  WHEN REGEXP_MATCH(Query, '(?i).*(preis|kosten|was kostet).*')    THEN 'Preise'
  WHEN REGEXP_MATCH(Query, '(?i).*(integrat|api|webhook|sync).*')  THEN 'Integrationen'
  WHEN REGEXP_MATCH(Query, '(?i).*(vs |alternative|vergleich).*')  THEN 'Vergleich'
  ELSE 'Ohne Treffer'
END
Einen ausdrücklichen Zweig Ohne Treffer statt einer Auffangbezeichnung zu behalten ist das, was das Feld pflegbar hält. Dieser Topf ist eine Arbeitsliste: nach Impressionen sortiert, führt er die Nachfrage auf, die die Taxonomie noch nicht abbildet – und jedes Cluster nach den ersten beiden entsteht üblicherweise aus dem Lesen dieser Liste.
Das Dashboard lesen
Mit einer Cluster-Dimension genügen drei Diagramme. Impressionen je Cluster im Zeitverlauf zeigen, ob die Sichtbarkeit breiter wird oder sich zusammenzieht. Klicks und CTR je Cluster zeigen, ob diese Sichtbarkeit zu Besuchen wird. Eine Tabelle der Anfragen ohne Treffer speist die nächste Runde der Taxonomie.
Die Falle in dieser Ansicht ist das Marken-Cluster. Markensuchen steigen mit Bekanntheit, mit Kampagnen und mit der Saison, und sie konvertieren weit besser als alles andere – ein gesund aussehender Gesamtwert kann darunter also schrumpfende Nicht-Marken-Cluster verbergen. Marke und Nicht-Marke als getrennte Linien statt als eine Sichtbarkeitssumme zu berichten hält genau das sichtbar.
Was diese Daten über generative Ergebnisse nicht sagen
Die Search Console hat keine Dimension für KI-generierte Antworten. Impressionen, die innerhalb eines generativen Ergebnisses entstanden sind, stecken in denselben Leistungsdaten wie gewöhnliche Ergebnisse, und es gibt keinen Filter, der sie trennt – jedes Dashboard, das aus dieser Quelle generative Sichtbarkeit zu messen behauptet, schließt also, statt zu messen.
Beobachtenswert ist ein informationsbezogenes Cluster, dessen Impressionen stabil bleiben oder wachsen, während Klicks und CTR zurückgehen, ohne dass ein Rankingverlust den Rückgang erklärt. Eine mögliche Erklärung ist, dass Nutzer ihre Antwort schon auf der Ergebnisseite finden. Dasselbe Muster passt aber auch zu einem geänderten Snippet oder einer anderen Mischung von Suchanfragen innerhalb des Clusters. Es ist deshalb eine Frage für die weitere Untersuchung und keine Kennzahl für generative Sichtbarkeit.
Innerhalb der Leitplanken bleiben
Drei Eigenschaften der Quelldaten begrenzen, was das Dashboard ehrlich behaupten kann. Seltene Anfragen werden aus Datenschutzgründen vollständig zurückgehalten, die Anfragezeilen summieren sich also immer auf weniger als die Property-Gesamtwerte – die Differenz ist kein abzugleichender Fehler, und Cluster-Anteile sind als Anteile der berichteten Anfragen zu lesen. Die Historie endet nach sechzehn Monaten, was einen Jahresvergleich möglich macht, aber kein zweites Jahr davon; alles Längere braucht eine eigene Ablage. Und die durchschnittliche Position ist bereits ein nach Impressionen gewichteter Durchschnitt innerhalb jeder Zeile; diese Durchschnitte über ein Cluster hinweg zu mitteln ergibt eine Zahl, die präzise aussieht und wenig bedeutet – weshalb Impressionen und Klicks die Aussage besser tragen als die Position.
Fragen und Antworten
Wie lässt sich ohne Lookahead eine zweiteilige Bedingung ausdrücken, etwa Marke und Produktnamen erfassen, Wettbewerber aber ausschließen?
Über die Reihenfolge und über getrennte Filter statt über eine Verneinung im Muster. Das ist der Ersatz, den RE2 übrig lässt, und er trägt weiter, als er zunächst aussieht.
Im berechneten Feld entscheidet der erste zutreffende Zweig. Ein Zweig für die Wettbewerber steht deshalb vor dem Zweig für Marke und Produkt: Eine Anfrage, die beide Namen enthält, landet im Wettbewerbsbereich und nicht in der Marke. Damit ist die Ausnahme ausgedrückt, ohne dass ein Muster etwas ausschließen müsste.
Beim Filtern übernimmt die Umkehrung dieselbe Aufgabe. In der API nimmt eine Filtergruppe zwei Filter auf, die zusammen gelten: einen mit includingRegex und dem Markenmuster, einen mit excludingRegex und dem Wettbewerbsmuster. In Looker Studio lässt sich ein Diagramm ebenso mit zwei Filtern belegen, einem einschließenden und einem ausschließenden. Zwei Filter statt eines Ausdrucks.
Die Reihenfolge der Zweige und die Aufteilung auf zwei Filter sind zu kommentieren, weil beides später wie ein Zufall aussieht. Ein kurzer Vermerk am Feld, welcher Zweig warum vorne steht, erspart der nächsten Person die Rekonstruktion aus den Daten.
Passend dazu