English
 Deutsch
 Polski
Conversational Analytics w Lookerze: pula tokenów i planowanie kosztów

Spis treści
Conversational Analytics odpowiada na pytania o dane Lookera w języku naturalnym. Sam rozmiar widocznej odpowiedzi nie pozwala ustalić kosztu. Punktem wyjścia są zmierzone tokeny wejściowe i wyjściowe całej instancji oraz obowiązujące warunki umowy i rozliczeń. Token jest jednostką przetwarzania tekstu lub danych, a nie stałą liczbą słów.
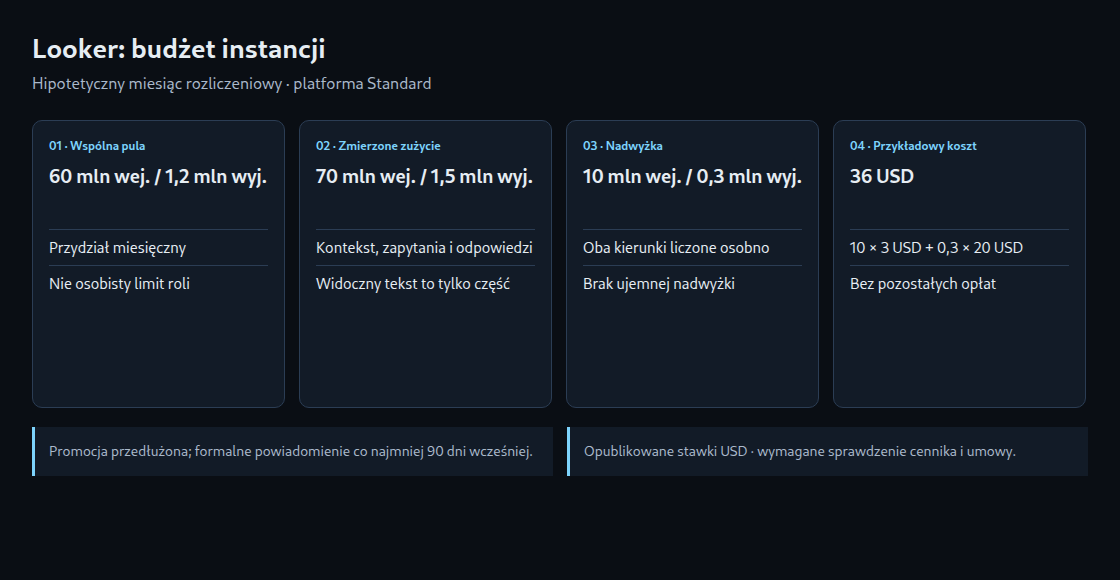
Aktualizacja z 24 października 2026: Google przedłużył okres promocyjny bez opłat za nadwyżki, w granicach uczciwego użytkowania. Aktualny cennik zapowiada formalne powiadomienie co najmniej 90 dni przed egzekwowaniem limitów i rozpoczęciem naliczania opłat. Wcześniej podany stały termin 1 października nie jest więc już wiarygodną podstawą planowania.
Wspólny przydział dla instancji
Opublikowany miesięczny przydział jest wspólny dla uwierzytelnionych użytkowników instancji. Nie stanowi osobnego limitu użytkownika Viewer, Standard ani Developer. Niewykorzystane tokeny nie przechodzą na kolejny miesiąc ani na inne produkty Data Cloud.
| Platforma / instancja | Wejście / miesiąc | Wyjście / miesiąc |
|---|---|---|
| Standard | 60 000 000 | 1 200 000 |
| Enterprise / Advanced | 300 000 000 | 6 000 000 |
| Embed / Elite | 1 200 000 000 | 24 000 000 |
| Nieprodukcyjna / dodatkowa | 6 000 000 | 120 000 |
Standard w tej tabeli oznacza poziom platformy, nie licencję użytkownika Standard. Dodanie użytkownika lub zmiana roli nie zwiększa automatycznie tej puli. Uprawnienia powinny wynikać z wykonywanego zadania.
Co obejmują pomiary
Wejście obejmuje pytanie, historię rozmowy i dostarczony kontekst. Wyjście może zawierać wygenerowane zapytania SQL lub wywołania API, wykresy i inne treści oprócz tekstu. Widoczne podsumowanie liczące 300 tokenów nie dowodzi zatem całkowitego zużycia 300 tokenów wyjściowych.
Karta Token usage w System Activity pokazuje szacowane zużycie wejściowe i wyjściowe według agenta, użytkownika i rozmowy. Aktualna dokumentacja podaje sześciogodzinne opóźnienie synchronizacji. Oznaczanie rodzaju interfejsu rozmowy zaczyna się po włączeniu funkcji w Lookerze 26.14 i nie działa wstecz. Starszy wiersz bez oznaczenia nie dowodzi braku zużycia.
Rachunek z jawnymi założeniami
Opublikowane stawki nadwyżkowe wynoszą 3 USD za milion tokenów wejściowych i 20 USD za milion wyjściowych. Poniższy rachunek dotyczy hipotetycznego miesiąca podlegającego rozliczeniu po rozpoczęciu egzekwowania limitów. Nie jest bieżącą fakturą ani pełnym oszacowaniem kosztów Lookera.
nadwyżka wejścia = max(0, miesięczne wejście - przydział wejścia)
nadwyżka wyjścia = max(0, miesięczne wyjście - przydział wyjścia)
koszt w USD     = 3 × nadwyżka wejścia / 1 000 000
                + 20 × nadwyżka wyjścia / 1 000 000
Założone zużycie instancji Standard wynosi 70 milionów tokenów wejściowych i 1,5 miliona wyjściowych. Nadwyżka to 10 milionów wejścia i 300 000 wyjścia: 30 USD plus 6 USD daje 36 USD. Kwota nie obejmuje licencji platformy i użytkowników, kosztów bazy danych ani innych osobno rozliczanych usług.
Dwadzieścia podsumowań dziennie przez 30 dni, przy założeniu 300 wszystkich tokenów wyjściowych na podsumowanie, zużywa 180 000 tokenów. To 15% puli wyjściowej Standard, a nie automatycznie 3,20 USD osobistej nadwyżki. Bez innego zużycia wyjście mieści się w przydziale. Przy wcześniejszym zużyciu 1,1 miliona tokenów wyjściowych ten sam cykl zwiększa sumę do 1,28 miliona, co oznacza 1,60 USD nadwyżki wyjściowej. Wejście nadal wymaga oddzielnego obliczenia.
Optymalizacja zadania, nie tylko długości tekstu
Krótkie pytanie może wymagać obszernego kontekstu i wygenerowanych zapytań. Długa odpowiedź nie musi być największym źródłem kosztu. Stosunek przydziałów 50:1 nie wskazuje, która pula wyczerpie się pierwsza. Decyduje rzeczywiste zużycie.
Jasne definicje pól, ograniczone tematycznie Explores i zwięzłe instrukcje agentów mogą ograniczyć zbędny kontekst i niejednoznaczność. Optymalizacja zapytań do bazy nadal ma znaczenie dla czasu wykonania i obciążenia bazy. Jej wpływ na tokeny wymaga pomiaru; stwierdzenie, że optymalizacja zapytań niczego nie zmienia, jest zbyt szerokie.
Dla rozmów z Explore Google zaleca zwykle tryb Fast. Thinking zużywa dodatkowe tokeny na widoczne kroki rozumowania, bez udokumentowanej przewagi dokładności nad Fast. Wybór powinien wynikać z celu analizy, a nie z założenia, że obszerniejsza odpowiedź musi być poprawniejsza.
Pytania i odpowiedzi
Czy regularne podsumowania zawsze są marnotrawstwem?
Nie. Stały raport lub szablon pasuje do stabilnej, wcześniej określonej treści. Adaptacyjne podsumowanie może być przydatne przy zmiennych odchyleniach lub pytaniach. Looker opisuje zaplanowane przepływy agentowe jako funkcję podglądową. Sensowne porównanie obejmuje sprawdzoną użyteczność, zużycie tokenów, utrzymanie i nakład pracy potrzebny na kontrolę wyników.
Czy wyższa rola użytkownika daje więcej tokenów?
Opublikowany model przydziela pulę według instancji i abonamentu platformy. Zmiana roli nie jest więc sposobem oszczędzania tokenów. Dodatkowo wymagają sprawdzenia indywidualne warunki umowy.
Co powinno stanowić podstawę budżetu?
Instancja i poziom abonamentu, okres pomiaru, oddzielne sumy wejścia i wyjścia, opóźnione lub brakujące pomiary, zaplanowane zadania i właściwe formalne powiadomienie o rozliczeniach. Reprezentatywny test daje lepszą podstawę niż gwarantowana liczba bezpłatnych odpowiedzi wyliczona z szacowanej liczby słów.
Powiązane artykuły