English
 Deutsch
 Polski
Rozmiar chunków i nakładka w bazie wiedzy RAG: wpływ na liczbę embeddingów, budżet tokenów i ponowne indeksowanie

Spis treści
Baza wiedzy dla asystenta AI zaczyna się od pocięcia długich dokumentów na krótkie fragmenty. O tym, jak to się dzieje, rozstrzygają dwie liczby: jak długi ma być fragment i jak daleko dwa kolejne fragmenty na siebie zachodzą. Obie wpisuje się w minutę, obowiązują dla całego zbioru i da się je później zmienić wyłącznie przez przepuszczenie wszystkiego od nowa.
I obie płaci się dwukrotnie: raz przy budowie bazy, a potem przy każdym pojedynczym pytaniu. Dlatego warto je przeliczyć, a nie zgadywać.
Jednostką miary jest token – z grubsza cząstka słowa; sto tokenów to około siedemdziesięciu słów polskiej prozy. Każdy gotowy fragment zostaje przełożony na długi ciąg liczb, który utrwala jego znaczenie. Ten ciąg nazywa się osadzeniem, a wyszukiwanie biegnie później po nim, nie po tekście.
Dlaczego zachodzenie kosztuje
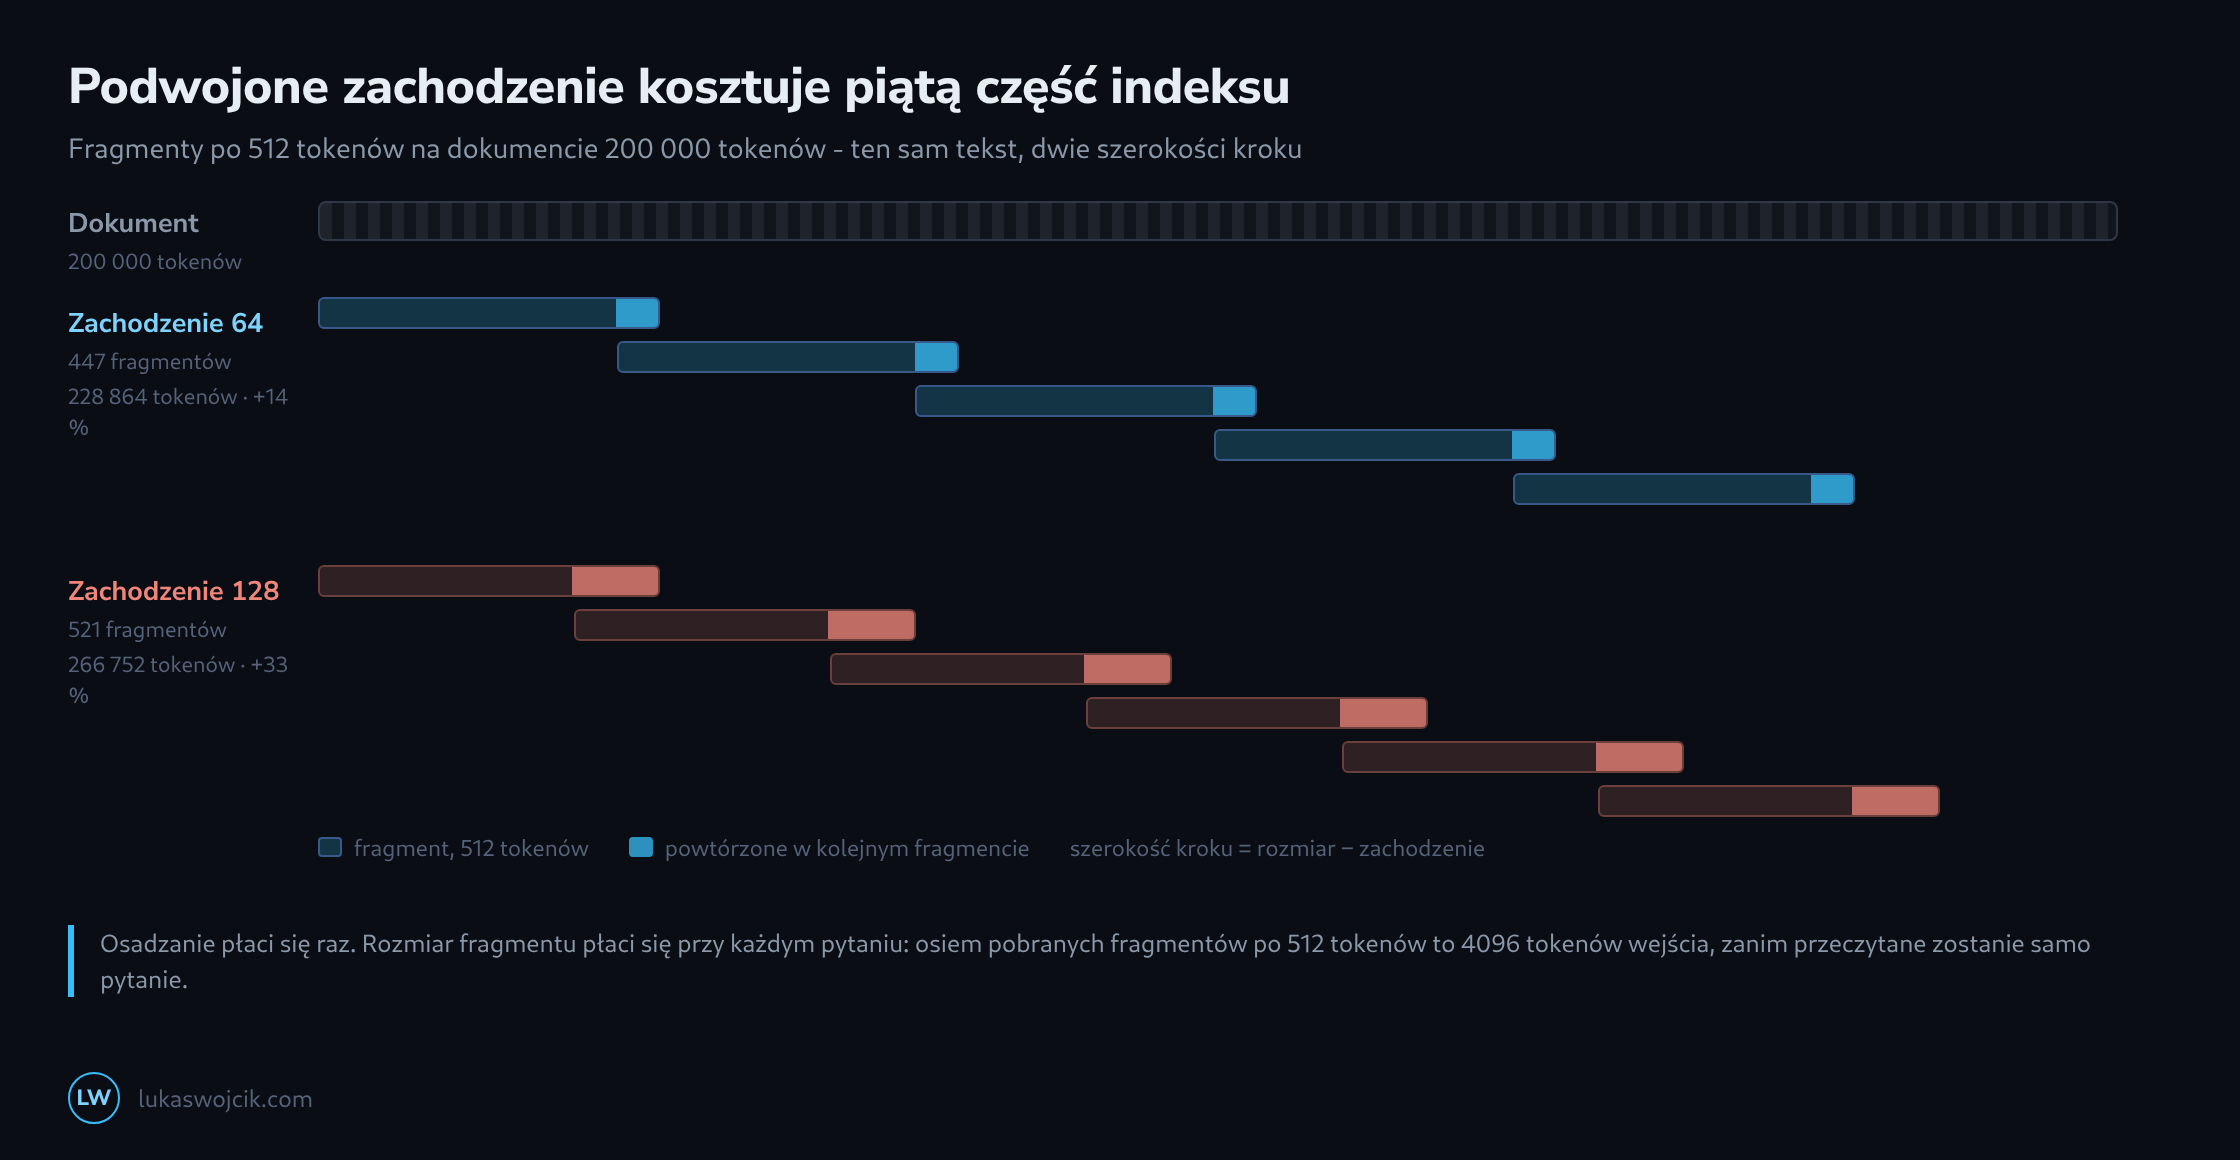
Fragmenty nie przesuwają się o pełną długość, tylko o tę część, która nie zachodzi. Przy rozmiarze fragmentu 512 tokenów i zachodzeniu 64 każdy fragment przesuwa się więc o 448. Na ten sam dokument potrzeba przez to więcej fragmentów – a ponieważ każdy odkłada się w pełnej długości, część zachodząca ląduje w pamięci dwa razy.
Tabela pokazuje, co to znaczy dla dokumentu liczącego 200 000 tokenów, przy rozmiarze fragmentu 512.
| Zachodzenie | Fragment przesuwa się o | Liczba fragmentów | Odłożone łącznie | Narzut |
|---|---|---|---|---|
| 64 tokeny (12 %) | 448 | 447 | 228 864 | +14 % |
| 128 tokenów (25 %) | 384 | 521 | 266 752 | +33 % |
| 256 tokenów (50 %) | 256 | 781 | 399 872 | +100 % |
Ostatni wiersz warto zapamiętać: zachodzenie równe połowie rozmiaru odkłada każdy token dwa razy. Narzut nie rośnie równomiernie z zachodzeniem, tylko strzela w górę, gdy tylko przesuw się zwęża. Dlatego użyteczny zakres leży między dziesięcioma a dwudziestoma procentami i dlatego wszystko powyżej jednej trzeciej wymaga powodu.
Do czego zachodzenie w ogóle służy
Sztywne cięcie rozdziela tam, gdzie kończy się licznik, a to bywa regularnie w środku zdania, w którym stoi odpowiedź. Zachodzenie sprawia, że to zdanie występuje w całości w co najmniej jednym fragmencie – i to cała jego rola.
Musi więc być tylko tak duże jak miejsce, którego nie wolno rozerwać. Dla tekstu ciągłego dwa lub trzy zdania są hojne, a dwa lub trzy zdania to około sześćdziesięciu do stu tokenów. Większe wartości wybiera się zwykle z ostrożności i płaci w pamięci, nic nie wnosząc: zdanie, które i tak mieści się w całości w jednym fragmencie, nie zmieści się bardziej w całości przez to, że stoi też w kolejnym.
Cięcie po strukturze bije cięcie po liczbie
Lepszą odpowiedzią na ten sam problem jest niedzielenie zdania w ogóle. Cięcie na nagłówkach, potem na akapitach, a dopiero potem odwrót do liczby tokenów, gdy akapit przekroczy rozmiar, odbiera zachodzeniu większość jego powodu – i tworzy fragmenty, których zawartość do siebie należy, a to przecież ma odwzorować osadzenie.
Uzupełnieniem, które nie kosztuje prawie nic, jest ścieżka nagłówków przy każdym fragmencie, dopisana przed tekstem. Fragment zaczynający się od Podręcznik > Rozliczenia > Wypowiedzenie lepiej się znajduje i lepiej czyta w instrukcji, bo niesie ze sobą kontekst, który zabrało cięcie.
Dwa rozmiary, dwa różne błędy
| Rozmiar fragmentu | Co robi dobrze | Jak zawodzi |
|---|---|---|
| 128 – 256 | dokładne wyszukiwanie, trafienie to dokładnie to miejsce | miejsce przychodzi bez zdania, które je wyjaśnia |
| 400 – 800 | akapit wraz z kontekstem, jeden temat na osadzenie | prawie wcale; to zakres roboczy |
| 1024 – 2048 | całe rozdziały, nic nigdy nie zostaje ucięte | osadzenie uśrednia kilka tematów i nie pasuje ostro do niczego |
Błąd dużych fragmentów jest tym z zewnątrz trudno widocznym. Osadzenie to jeden punkt dla całego tekstu; fragment o trzech przedmiotach leży więc gdzieś pomiędzy wszystkimi trzema i blisko żadnego. Wyszukiwanie tego nie zgłasza, po prostu wydaje coś innego, a odpowiedź powstaje z miejsca, które nie było całkiem właściwe.
Koszt, który wraca
Osadzenie zbioru jest tanie i zdarza się raz. Ale rozmiar fragmentu jest zarazem jednostką, w której mierzy się pobrany tekst – ten, który asystent dostaje przy każdym pytaniu, i za który płaci się za każdym razem. Osiem fragmentów po 512 tokenów to 4096 tokenów, które model czyta, zanim w ogóle zobaczy pytanie.
Wymiarować należy pod tę liczbę, bo mnoży się przez liczbę pytań, a nie przez rozmiar zbioru. Zmniejszenie rozmiaru fragmentu o połowę przy podwojeniu liczby pobieranych fragmentów zostawia rachunek bez zmian i podnosi dokładność; zmniejszenie go bez ruszania liczby połowi rachunek i grozi przybyciem ze zbyt małym kontekstem. Oba są decyzjami i oba stoją w tej samej linijce.
Zmiana ustawienia oznacza budowę od nowa
Granice fragmentów tkwią w osadzeniach. Inny rozmiar tworzy inne teksty, inne osadzenia i inne identyfikatory, częściowej migracji więc nie ma – zbiór osadza się od nowa, a przechowywane gdzie indziej identyfikatory wskazują fragmenty, których już nie ma.
Przemawia to za jednym nawykiem od początku: prowadzeniem dokumentów źródłowych, cięcia i osadzania jako trzech osobnych kroków i zapisywaniem wyniku pośredniego na dysk. Ponowne osadzenie jest wtedy ponownym przebiegiem ostatniego kroku na zbiorze już przygotowanym, a nie popołudniem odtwarzania, jak ten tekst w ogóle się tam znalazł.
Pytania i odpowiedzi
Czy narzut z tabeli dotyczy także innych rozmiarów fragmentu?
Tak, bo zależy wyłącznie od proporcji między zachodzeniem a rozmiarem fragmentu. Odkładana ilość to w przybliżeniu długość dokumentu razy rozmiar fragmentu podzielony przez przesuw; przy 512 tokenach i zachodzeniu 64 daje to współczynnik 512 / 448 ≈ 1,14. Fragment o 1024 tokenach z zachodzeniem 128 ma więc ten sam narzut 14 procent, a fragment o 256 tokenach z zachodzeniem 64 już 33 procent.
Czy zachodzenie kosztuje także przy każdym pytaniu, a nie tylko w pamięci?
Tak, gdy tylko sąsiednie fragmenty zostają pobrane razem, a zdarza się to częściej, niż się wydaje. Dwa sąsiednie fragmenty dzielą tekst zachodzący, więc ich osadzenia leżą blisko siebie, a pytanie pasujące do jednego często pasuje i do drugiego. Jeśli oba trafią do pobranych fragmentów, wspólna część stoi w instrukcji dwa razy i dwa razy jest opłacana.
Bardziej waży utracone miejsce. Przy ośmiu pobieranych fragmentach para sąsiednich fragmentów zajmuje dwa miejsca częściowo tą samą treścią, a fragment, który przyszedłby jako dziewiąty, wypada. Im większe zachodzenie, tym bardziej podobne do siebie są sąsiednie fragmenty i tym częstszy ten efekt; przy połowie rozmiaru fragmentu dwa sąsiednie fragmenty dzielą połowę tekstu.
Dwa zabiegi utrzymują to w ryzach. Sąsiednie trafienia z tego samego dokumentu da się przed wstawieniem do instrukcji połączyć w jeden fragment, bez podwójnej części. A wybór da się ustawić tak, by z każdej pary sąsiadujących fragmentów liczył się tylko ten lepiej oceniony, a zwolnione miejsce przypadało następnemu kandydatowi.
Jaką granicę rozmiarowi fragmentu stawia sam model osadzeń?
Twardą: każdy model osadzeń przyjmuje tylko ograniczoną liczbę tokenów, a ostatni wiersz tabeli rozmiarów przy niektórych popularnych modelach sięga tej granicy. Istotne jest to, co dzieje się po jej przekroczeniu. Vertex AI, źródło artykułu, w ustawieniu domyślnym po cichu skraca zbyt długie wejście, zamiast zgłosić błąd. Reszta fragmentu jest nadal przechowywana i dostarczana, ale nie wchodzi do osadzenia i nie da się jej znaleźć przez ten fragment.
Łatwo przeoczyć dwa dodatki. Dopisana z przodu ścieżka nagłówków też się liczy, a fragment, który przy cięciu policzono własnym tokenizerem na 512 tokenów, w tokenizerze modelu osadzeń może być dłuższy. Praca blisko granicy wymaga więc zapasu albo wyłączenia skracania, tak by zbyt długi fragment wyszedł na jaw jako błąd.
Czy zmiana jednego dokumentu wymaga ponownego osadzenia całego zbioru?
Nie; wymaga tego tylko zmiana ustawienia. Przy zmianie treści wystarczy usunąć fragmenty tego jednego dokumentu, pociąć go na nowo i osadzić nowe fragmenty. Warunkiem jest, by każdy identyfikator zawierał dokument, z którego pochodzi fragment; inaczej nie da się ustalić, które wpisy mają zniknąć.
Ile przy tym powstaje nowego, zależy od sposobu cięcia. Przy cięciu po liczbie tokenów zdanie wstawione blisko początku przesuwa wszystkie dalsze granice w dokumencie i zmienia się każdy fragment za nim. Przy cięciu na nagłówkach i akapitach zmiana zostaje w tym fragmencie, w którym zaszła; pozostałe są identyczne znak w znak.
Da się to wykorzystać. Suma kontrolna tekstu zapisana przy każdym fragmencie pozwala rozpoznać fragmenty niezmienione i zachować ich osadzenie oraz identyfikator zamiast wytwarzać je od nowa, a identyfikatory przechowywane gdzie indziej pozostają ważne. Przy cięciu po strukturze zmiana dokumentu oznacza wtedy zwykle tylko garść nowych osadzeń.
Źródła
Powiązane artykuły