English
 Deutsch
 Polski
Tutorial: Personenbezogene Daten in GA4-Seitenpfaden finden und entfernen

Inhalt
Personenbezogene Daten gelangen nicht durch eine Entscheidung in eine Analyse-Property. Sie gelangen dorthin, weil ein Formular per GET statt per POST absendet, weil ein Link zum Zurücksetzen des Passworts eine Adresse trägt oder weil ein Suchfeld das Eingetippte in die Adresse schreibt.
Nichts in der Oberfläche meldet das. Der Seitenpfad ist bloss eine Dimension, und ein Pfad mit einer Mailadresse sieht in einer Liste von viertausend aus wie jeder andere. Ihn zu finden kostet eine Abfrage und sechs Muster; ihn loszuwerden kostet zwei getrennte Massnahmen, denn das Leck und der gespeicherte Bestand sind verschiedene Aufgaben.
Was in einem Seitenpfad personenbezogen ist
Die offensichtlichen Fälle sind Mailadressen und Telefonnummern. Die weniger offensichtlichen bereiten mehr Ärger, denn sie werden gar nicht als personenbezogen erkannt.
Eine Bestellnummer ist personenbezogen, sobald sie sich in einem anderen System zu einer Person auflösen lässt – und das lässt sie sich meistens. Ein Token zum Zurücksetzen eines Passworts ist nicht personenbezogen, aber ein Geheimnis, und ein Geheimnis in einem Analysebericht steht jedem offen, der die Property lesen darf. Ein Suchbegriff ist personenbezogen, sobald Leute den eigenen Namen oder die eigene Adresse in das Suchfeld tippen – in einem Shop mit Bestellsuche täglich.
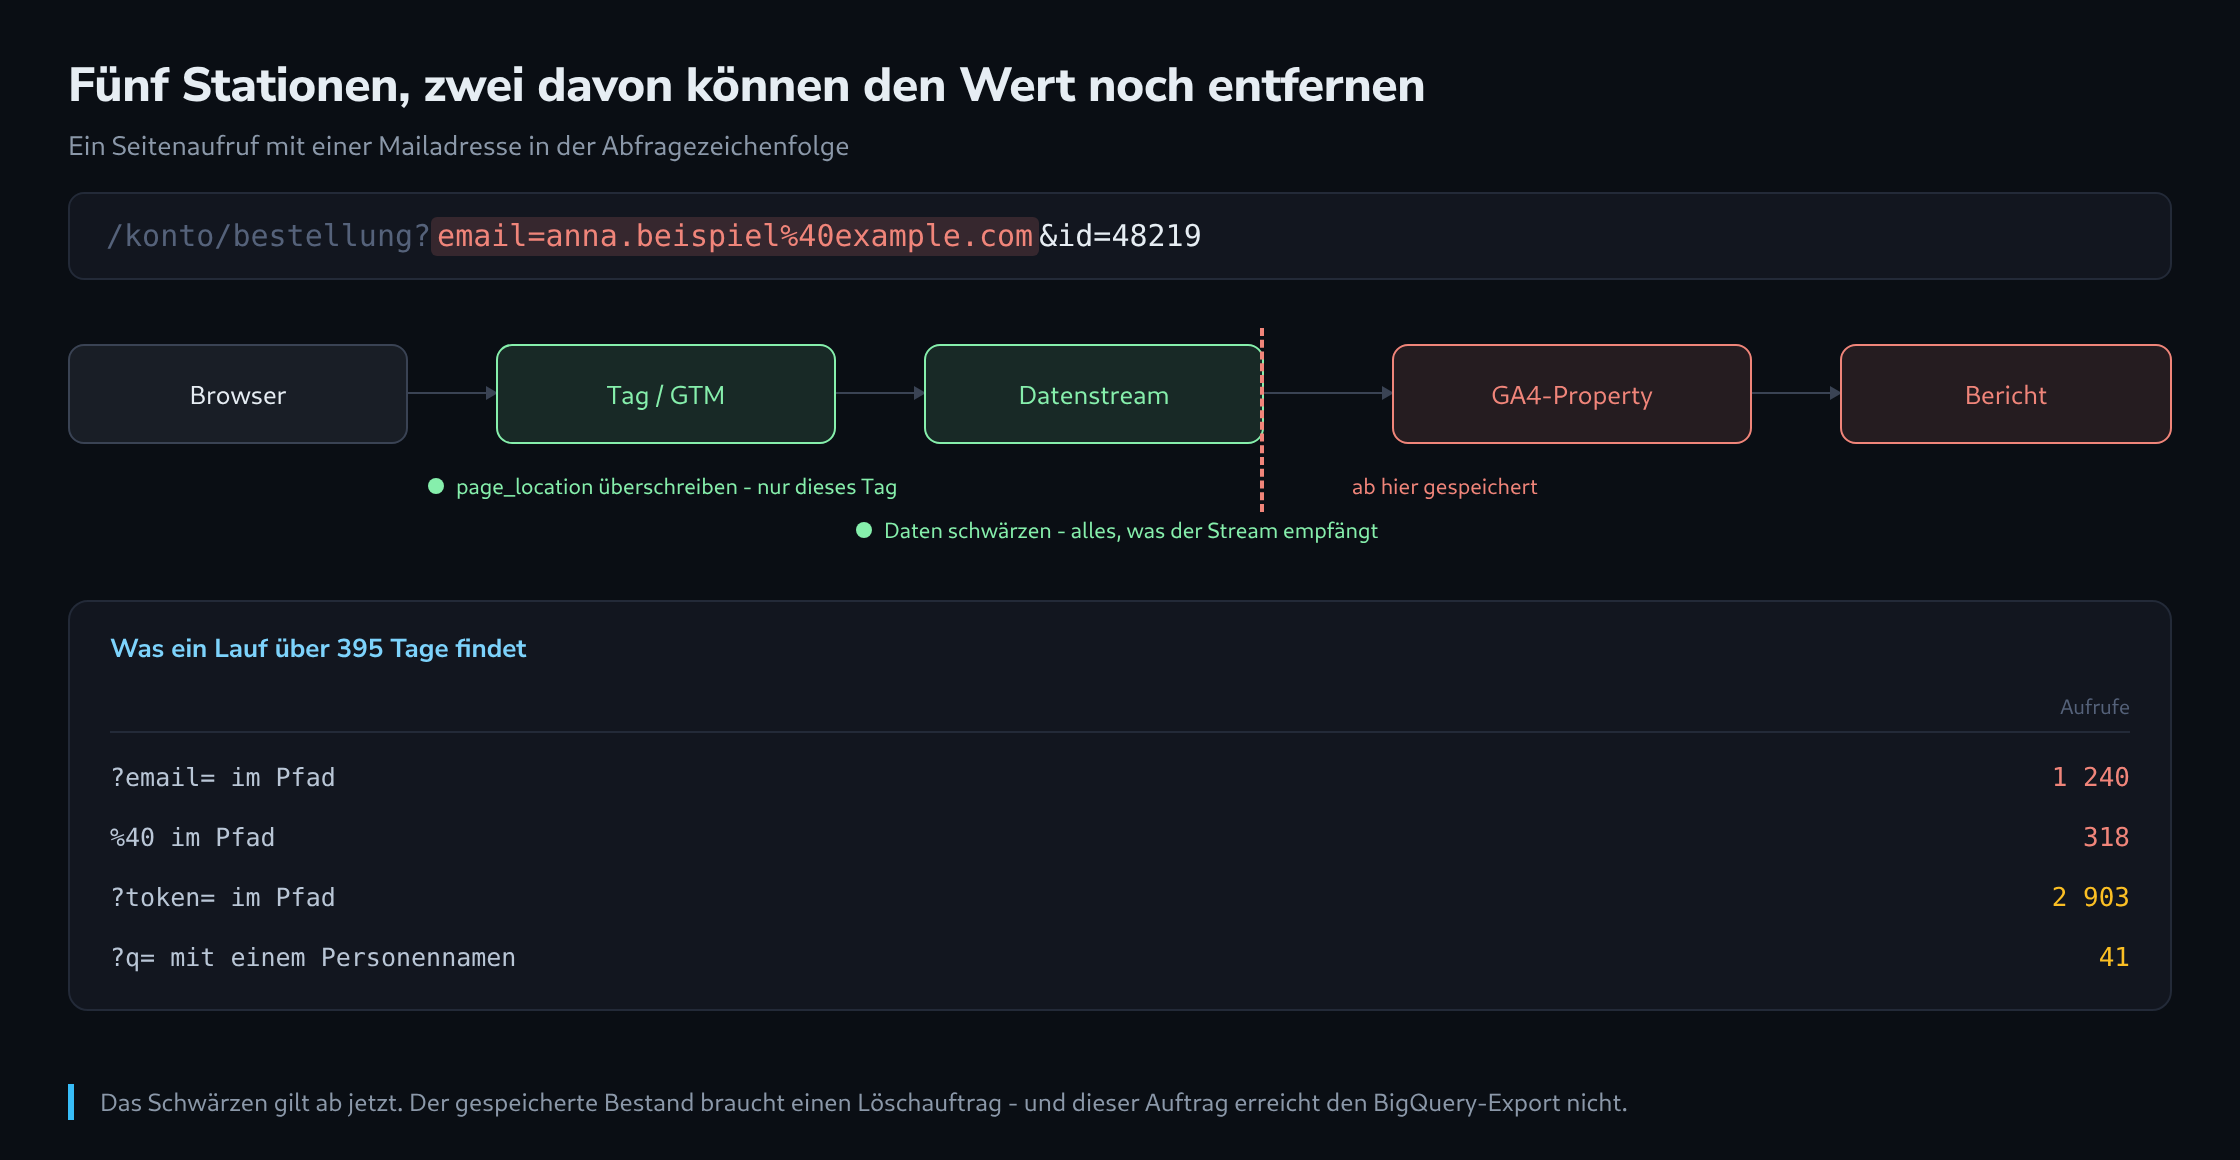
Allen gemeinsam ist der Weg über die Adresse, und die Adresse erreicht GA4 vollständig. Alles hinter dem Fragezeichen wird Teil der Seitendimension, und das Fragment hinter der Raute ist der einzige Teil, der den Browser nie verlässt.
Die Seitenpfade aus der Property holen
Die Data API liefert dieselben Dimensionen wie die Berichte, ohne deren Zeilengrenzen. Eine Anfrage über einen langen Zeitraum bringt alles zurück, was je erfasst wurde.
curl -X POST \
  "https://analyticsdata.googleapis.com/v1beta/properties/123456789:runReport" \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "dateRanges":  [{ "startDate": "395daysAgo", "endDate": "today" }],
    "dimensions":  [{ "name": "pagePathPlusQueryString" }],
    "metrics":     [{ "name": "screenPageViews" }],
    "limit": 100000,
    "orderBys": [{ "metric": { "metricName": "screenPageViews" }, "desc": true }]
  }'
Drei Einzelheiten entscheiden, ob das Ergebnis vollständig ist. Die Dimension muss die mit der Abfragezeichenfolge sein – pagePath allein schneidet genau den Teil ab, in dem die Daten üblicherweise stecken. Der Zeitraum sollte so weit zurückreichen, wie die Property Daten vorhält, denn ein vor einem halben Jahr behobenes Leck steckt weiterhin in den gespeicherten Zeilen. Und eine Property mit vielen Pfaden braucht Seitenaufteilung: Die Antwort trägt eine Zeilenzahl, und alles jenseits der Grenze verlangt eine zweite Anfrage mit Versatz.
Ein Wort zum Kontingent. Die API rechnet Marken je Property und Tag ab, und eine Abfrage über vierhundert Tage mit hunderttausend Zeilen ist nicht umsonst. Sie einmal im Quartal zu fahren, ist sinnvoll; sie beim Entwickeln in einer Schleife zu fahren, verbraucht das Tageskontingent an einem Nachmittag.
Die Muster, nach denen sich zu suchen lohnt
Sechs Muster decken fast jede Fundstelle ab, und sie gehören auf die rohe und auf die dekodierte Form des Pfads angewandt – denn eine Adresse kommt ebenso oft als %40 an wie als @.
import re, urllib.parse

MUSTER = {
    "mail":       re.compile(r"[\w.+-]+@[\w-]+\.[\w.]{2,}"),
    "mail_kod":   re.compile(r"[\w.+-]+%40[\w-]+"),
    "telefon":    re.compile(r"(?:\+|00)\d{7,15}|\b0\d{8,13}\b"),
    "schluessel": re.compile(r"[?&](?:token|hash|auth|key|sig|pwd|password)=", re.I),
    "namensfeld": re.compile(r"[?&](?:name|vorname|nachname|first|last|user)=", re.I),
    "suche":      re.compile(r"[?&](?:q|s|search|query)=", re.I),
}

def pruefe(pfad):
    formen = {pfad, urllib.parse.unquote(pfad)}
    return {name for name, m in MUSTER.items() if any(m.search(f) for f in formen)}
Die letzten beiden verlangen einen zweiten Blick, bevor etwas gemeldet wird. Ein Parameter namens name trägt oft einen Produktnamen und keine Person, und ein Suchparameter ist nur dann ein Problem, wenn Leute Personenbezogenes hineinschreiben – das klärt das Lesen von zwanzig echten Werten, nicht der Parametername.
Das Telefonmuster erzeugt die meisten Fehltreffer von allen: Bestellnummern, Artikelnummern und Daten der Form 20260920 passen allesamt auf eine lange Ziffernfolge. Es auf die Parameter einzugrenzen, in denen es auftritt, statt auf den ganzen Pfad, beseitigt das grösstenteils.
Am Stream schwärzen statt im Tag
Liegen die Fundstellen vor, wird das Leck an der frühesten beherrschbaren Stelle geschlossen. GA4 bietet das am Datenstream selbst an, und es gilt für alles, was der Stream empfängt, unabhängig davon, welches Tag gesendet hat.
Die Einstellung sitzt in der Verwaltung beim Web-Datenstream in den Tag-Einstellungen unter Daten schwärzen. Sie besteht aus zwei Teilen: einem automatischen Entfernen von allem, was wie eine Mailadresse aussieht, und einer Liste von Parameternamen, deren Werte vor dem Speichern ersetzt werden.
token, hash, auth, key, sig, pwd, password,
email, mail, e-mail, user, username,
phone, tel, mobile,
name, firstname, lastname
Diese Liste gehört an dieselbe Stelle wie die Ergebnisse des Suchlaufs und sollte nachgezogen werden, sobald der Lauf einen neuen Parameter findet. Das Schwärzen arbeitet exakt: Ein Parameter, der auf einer Seite anders geschrieben ist – e_mail statt email -, geht unberührt hindurch.
Zwei Bemerkungen zur Einordnung gegenüber den anderen Wegen. page_location im Tag-Manager zu überschreiben funktioniert auch und greift früher, aber nur für die Treffer dieses einen Tags; ein zweites Tag oder ein fest im Theme stehender gtag-Aufruf umgeht es. Das Bereinigen in einem Servercontainer ist der stärkste Weg und der einzige, der auch die Weitergabe an Werbeplattformen schützt – eine eigene Arbeit mit eigenem Artikel. Die Stream-Einstellung ist die, die zehn Minuten kostet und alles abdeckt.
Der bereits gespeicherte Bestand
Das Schwärzen gilt für Treffer von jetzt an. Es ändert nichts an den Zeilen, die bereits in der Property liegen – und genau die zählen für eine datenschutzrechtliche Frage.
Was sie entfernt, ist ein Löschauftrag, in der Verwaltung auf Ebene der Property. Der einschlägige Typ löscht ausgewählte Parameter über alle Ereignisse hinweg, und die Seitenadresse ist einer dieser Parameter.
Drei Eigenschaften dieses Verfahrens lohnen sich vor dem Auslösen zu kennen. Es hat eine Wartezeit von einigen Tagen, in der es sich zurücknehmen lässt – das ist Absicht und nützlich. Einmal angelaufen, dauert die vollständige Anwendung bis zu etwa zwei Monaten. Und es ist unumkehrbar: Die Seitendimension dieses Zeitraums ist danach fort, auch für die unbedenklichen Pfade, wenn der Auftrag den ganzen Parameter umfasste.
Was der Auftrag nicht anfasst, ist der BigQuery-Export. Daten, die vor der Löschung exportiert wurden, liegen in einem Datensatz, über den die Property keine Verfügung mehr hat, und dort sind sie eigens zu entfernen – eine UPDATE-Anweisung je Tagestabelle wie die folgende, eine DELETE-Anweisung oder eine neu gebaute Tabelle, für denselben Zeitraum.
FOR t IN (
  SELECT table_name
  FROM `projekt`.analytics_123456789.INFORMATION_SCHEMA.TABLES
  WHERE table_name BETWEEN 'events_20260101' AND 'events_20260920')
DO
EXECUTE IMMEDIATE FORMAT(r"""
UPDATE `projekt.analytics_123456789.%s`
SET event_params = ARRAY(
      SELECT AS STRUCT
        p.key,
        IF(p.key = 'page_location',
           STRUCT(REGEXP_REPLACE(p.value.string_value,
                  r'([?&](?:email|token|phone)=)[^&]*', r'\1[entfernt]')
                  AS string_value, p.value.int_value,
                  p.value.float_value, p.value.double_value),
           p.value) AS value
      FROM UNNEST(event_params) AS p)
WHERE TRUE""", t.table_name);
END FOR;
Was der Suchlauf nicht sieht
Drei Orte tragen dieselbe Art von Daten und tauchen in diesem Bericht nicht auf.
Der erste sind Ereignisparameter ausserhalb der Seitenadresse. Eine Formularmessung, die den eingegebenen Wert als Parameter sendet, legt ihn in eine benutzerdefinierte Dimension, und der obige Lauf schaut dort nie hin. Dieselbe Data-API-Abfrage mit der benutzerdefinierten Dimension anstelle des Seitenpfads findet ihn, und diese Abfrage lohnt sich für jede angemeldete Dimension einmal.
Der zweite ist das Feld für die Nutzerkennung. Eine Property, die eine Nutzerkennung empfangen soll und stattdessen eine Mailadresse bekommt, ist ein Lehrbuchverstoss und in Berichten unsichtbar, weil das Feld in den meisten davon gar nicht erscheint. Die Prüfung ist dieselbe wie überall: die echten Werte ansehen, nicht den Feldnamen.
Der dritte ist alles, was das Haus schon verlassen hat. Gingen die Treffer auch an eine Werbeplattform, ändert das Schwärzen in GA4 nichts an der Kopie, die dort ankam – und diese Plattform hat ihren eigenen Löschweg. Die Liste der Empfänger lohnt sich vor dem ersten Löschauftrag aufzuschreiben, denn der Auftrag selbst erzeugt sie nicht.
Fragen und Antworten
Kann dasselbe Leck auch über den Referrer in die Property gelangen?
Ja. Führt ein Link von einer Seite mit Daten in der Adresse auf eine andere Seite derselben Website, übergibt der Browser bei der üblichen Voreinstellung die vollständige Adresse als Referrer, und GA4 speichert sie im Parameter page_referrer der nächsten Seite. Der Suchlauf lohnt sich deshalb auch mit der Dimension pageReferrer statt des Seitenpfads, und ein Löschauftrag, der nur die Seitenadresse umfasst, lässt diese Kopie stehen. An fremde Server geht über den Referrer bei derselben Voreinstellung nur der Ursprung der Seite, solange sie keine großzügigere Referrer-Policy setzt.
Genügt es, ein Formular von GET auf POST umzustellen?
Für das Leck an dieser Stelle ja, für den Rest nicht. Mit POST stehen die Felder im Rumpf der Anfrage statt in der Adresse und erreichen damit weder GA4 noch das Zugriffsprotokoll des Servers noch den Verlauf des Browsers.
Entscheidend ist die Seite, die danach erscheint. Leitet der Server nach dem Absenden auf eine Adresse ohne die Daten weiter, bleibt diese sauber, und ein Neuladen schickt das Formular nicht ein zweites Mal ab. Hängt die Weiterleitung die Eingaben dagegen wieder an die Adresse, etwa als Bestätigung auf der Dankeseite, ist das Leck zurück, nur eine Seite später.
Die bereits gespeicherten Zeilen berührt die Umstellung nicht; sie bleiben, bis ein Löschauftrag sie entfernt. Für ein Suchfeld ist POST meist keine Lösung, weil sich Ergebnisseiten dann nicht mehr verlinken lassen. Dort bleibt es bei GET, und den Schutz übernehmen das Schwärzen und die Durchsicht echter Werte, wie im Artikel beschrieben.
Erfasst GA4 Suchbegriffe noch an einer anderen Stelle als im Seitenpfad?
Ja, sobald in der erweiterten Messung die Websitesuche eingeschaltet ist. GA4 liest dann den Suchparameter aus der Adresse und sendet zusätzlich zum Seitenaufruf ein Ereignis view_search_results, dessen Parameter search_term den Begriff ein zweites Mal trägt. Der Suchlauf aus dem Artikel sieht diese Kopie nicht, weil er nur die Seitendimension abfragt.
Dieselbe Data-API-Abfrage mit der Dimension searchTerm statt pagePathPlusQueryString bringt sie zurück, und auf ihre Werte gehören dieselben Muster angewandt. Ein Löschauftrag, der nur die Seitenadresse umfasst, lässt search_term stehen. Ob die Begriffe personenbezogen sind, entscheidet auch hier das Lesen echter Werte und nicht der Parametername.
Sind die Werte in BigQuery nach der Bereinigung sofort verschwunden?
Nicht sofort. BigQuery hält den Stand vor jeder Änderung für die Zeitreise vor, in der Voreinstellung sieben Tage, in denen er sich mit FOR SYSTEM_TIME AS OF weiter abfragen lässt, und danach noch sieben Tage als Fail-Safe, aus dem ihn nur noch der Google-Support wiederherstellen kann. Das Zeitreisefenster lässt sich je Datensatz auf das Minimum von zwei Tagen verkürzen; Snapshots, Kopien aus geplanten Abfragen und Tabellen in anderen Projekten brauchen ihre eigene Bereinigung.
Praxiskontrolle: mehrere Collect-Requests vergleichen
Der GA4-Parameter-Analyser kann mehrere Browser-Collect-Requests gemeinsam untersuchen. Je Zeile wird eine URL oder ein URL-kodierter Query-/Body-String eingetragen. Gehören Parameter zur gemeinsamen URL eines POST-Requests, macht das separate Feld für gemeinsame Parameter diesen Kontext in jeder Zeile sichtbar.
Die Übersicht zeigt Ereignisnamen, Mess-IDs und wiederholte Parameterschlüssel. Im Vergleich stehen nur Unterschiede: Ein fehlender Schlüssel ist etwas anderes als ein Schlüssel mit leerem Wert. Verschiedene Ereignistypen enthalten naturgemäß unterschiedliche Parameter; eine Abweichung allein belegt deshalb keinen Trackingfehler. Wiederholte Schlüssel bleiben in ihrer ursprünglichen Reihenfolge erhalten. Das Werkzeug behauptet nicht, welches Vorkommen der Empfänger verwendet.
Werte werden einmal dekodiert und als Text dargestellt, auch wenn sie wie HTML aussehen. Die optionale CSV enthält die dekodierten Werte und ist nicht anonymisiert. Damit hilft der Analyser beim Untersuchen einer unerwarteten Seitenadresse oder eines Parameters, ist aber kein vollständiger Detektor für personenbezogene Daten. Ein unauffälliges Ergebnis belegt keine personenbezugsfreie Implementierung.
Kein eingefügter Request wird erneut abgespielt oder hochgeladen. Das Werkzeug beschreibt die Eingabe, nicht deren Annahme durch Google. Die tatsächliche Erfassung lässt sich gegebenenfalls über Google DebugView prüfen. Die Querydekodierung folgt den URL-Formkodierungsregeln; gepackte Artikelsegmente werden nur heuristisch aufgeschlüsselt. Für JSON-Nutzdaten des Measurement Protocol ist der separate Validator vorgesehen.
Passend dazu