English
 Deutsch
 Polski
Tutorial: Znajdowanie danych osobowych w ścieżkach stron GA4 i ich usuwanie

Spis treści
Dane osobowe nie trafiają do usługi analitycznej wskutek decyzji. Trafiają tam, bo formularz wysyła metodą GET zamiast POST, bo odnośnik do resetu hasła niesie adres albo bo pole wyszukiwania wpisuje wpisaną treść do adresu.
Nic w interfejsie tego nie zgłasza. Ścieżka strony to zwykły wymiar, a ścieżka z adresem pocztowym wygląda na liście czterech tysięcy jak każda inna. Znalezienie jej kosztuje jedno zapytanie i sześć wzorców; pozbycie się jej kosztuje dwa osobne działania, bo wyciek i zapisany zasób to różne zadania.
Co w ścieżce strony jest daną osobową
Przypadki oczywiste to adresy pocztowe i numery telefonów. Mniej oczywiste sprawiają więcej kłopotu, bo w ogóle nie zostają rozpoznane jako osobowe.
Numer zamówienia jest daną osobową, gdy tylko da się go rozwiązać do osoby w innym systemie – a zwykle się da. Token do resetu hasła nie jest daną osobową, lecz tajemnicą, a tajemnica w raporcie analitycznym stoi otworem dla każdego z prawem odczytu usługi. Wyrażenie wyszukiwane jest daną osobową, gdy tylko ludzie wpisują w pole własne nazwisko albo adres – w sklepie z wyszukiwaniem zamówień codziennie.
Wszystkie łączy droga: przychodzą adresem URL, a adres dociera do GA4 w całości. Wszystko za znakiem zapytania staje się częścią wymiaru strony, a fragment za krzyżykiem jest jedyną częścią, która nigdy nie opuszcza przeglądarki.
Pobranie ścieżek stron z usługi
Data API zwraca te same wymiary co raporty, bez ich ograniczeń liczby wierszy. Jedno żądanie za długi okres przynosi wszystko, co kiedykolwiek zostało zebrane.
curl -X POST \
  "https://analyticsdata.googleapis.com/v1beta/properties/123456789:runReport" \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "dateRanges":  [{ "startDate": "395daysAgo", "endDate": "today" }],
    "dimensions":  [{ "name": "pagePathPlusQueryString" }],
    "metrics":     [{ "name": "screenPageViews" }],
    "limit": 100000,
    "orderBys": [{ "metric": { "metricName": "screenPageViews" }, "desc": true }]
  }'
O kompletności wyniku rozstrzygają trzy szczegóły. Wymiar musi być tym z ciągiem zapytania – sam pagePath odcina dokładnie tę część, w której dane zwykle siedzą. Okres powinien sięgać tak daleko wstecz, jak usługa przechowuje dane, bo wyciek naprawiony pół roku temu nadal tkwi w zapisanych wierszach. A usługa z wieloma ścieżkami wymaga stronicowania: odpowiedź niesie liczbę wierszy, a wszystko poza limitem wymaga drugiego żądania z przesunięciem.
Słowo o przydziale. API rozlicza znaczniki na usługę i dzień, a zapytanie za czterysta dni ze stoma tysiącami wierszy nie jest darmowe. Przeprowadzać je raz na kwartał ma sens; przeprowadzać w pętli przy budowaniu zużywa dzienny przydział w jedno popołudnie.
Wzorce, których warto szukać
Sześć wzorców obejmuje niemal każde znalezisko i należy je stosować do postaci surowej oraz odkodowanej ścieżki – bo adres przychodzi równie często jako %40 jak jako @.
import re, urllib.parse

MUSTER = {
    "mail":       re.compile(r"[\w.+-]+@[\w-]+\.[\w.]{2,}"),
    "mail_kod":   re.compile(r"[\w.+-]+%40[\w-]+"),
    "telefon":    re.compile(r"(?:\+|00)\d{7,15}|\b0\d{8,13}\b"),
    "schluessel": re.compile(r"[?&](?:token|hash|auth|key|sig|pwd|password)=", re.I),
    "namensfeld": re.compile(r"[?&](?:name|vorname|nachname|first|last|user)=", re.I),
    "suche":      re.compile(r"[?&](?:q|s|search|query)=", re.I),
}

def pruefe(pfad):
    formen = {pfad, urllib.parse.unquote(pfad)}
    return {name for name, m in MUSTER.items() if any(m.search(f) for f in formen)}
Dwa ostatnie wymagają drugiego spojrzenia, zanim cokolwiek zostanie zgłoszone. Parametr o nazwie name niesie często nazwę produktu, a nie osobę, a parametr wyszukiwania jest problemem tylko wtedy, gdy ludzie wpisują tam dane osobowe – rozstrzyga to przeczytanie dwudziestu prawdziwych wartości, a nie nazwa parametru.
Wzorzec telefonu daje najwięcej fałszywych trafień ze wszystkich: numery zamówień, numery artykułów i daty postaci 20260920 pasują do długiego ciągu cyfr. Ograniczenie go do parametrów, w których występuje, zamiast do całej ścieżki, usuwa większość tego.
Redakcja na strumieniu zamiast w tagu
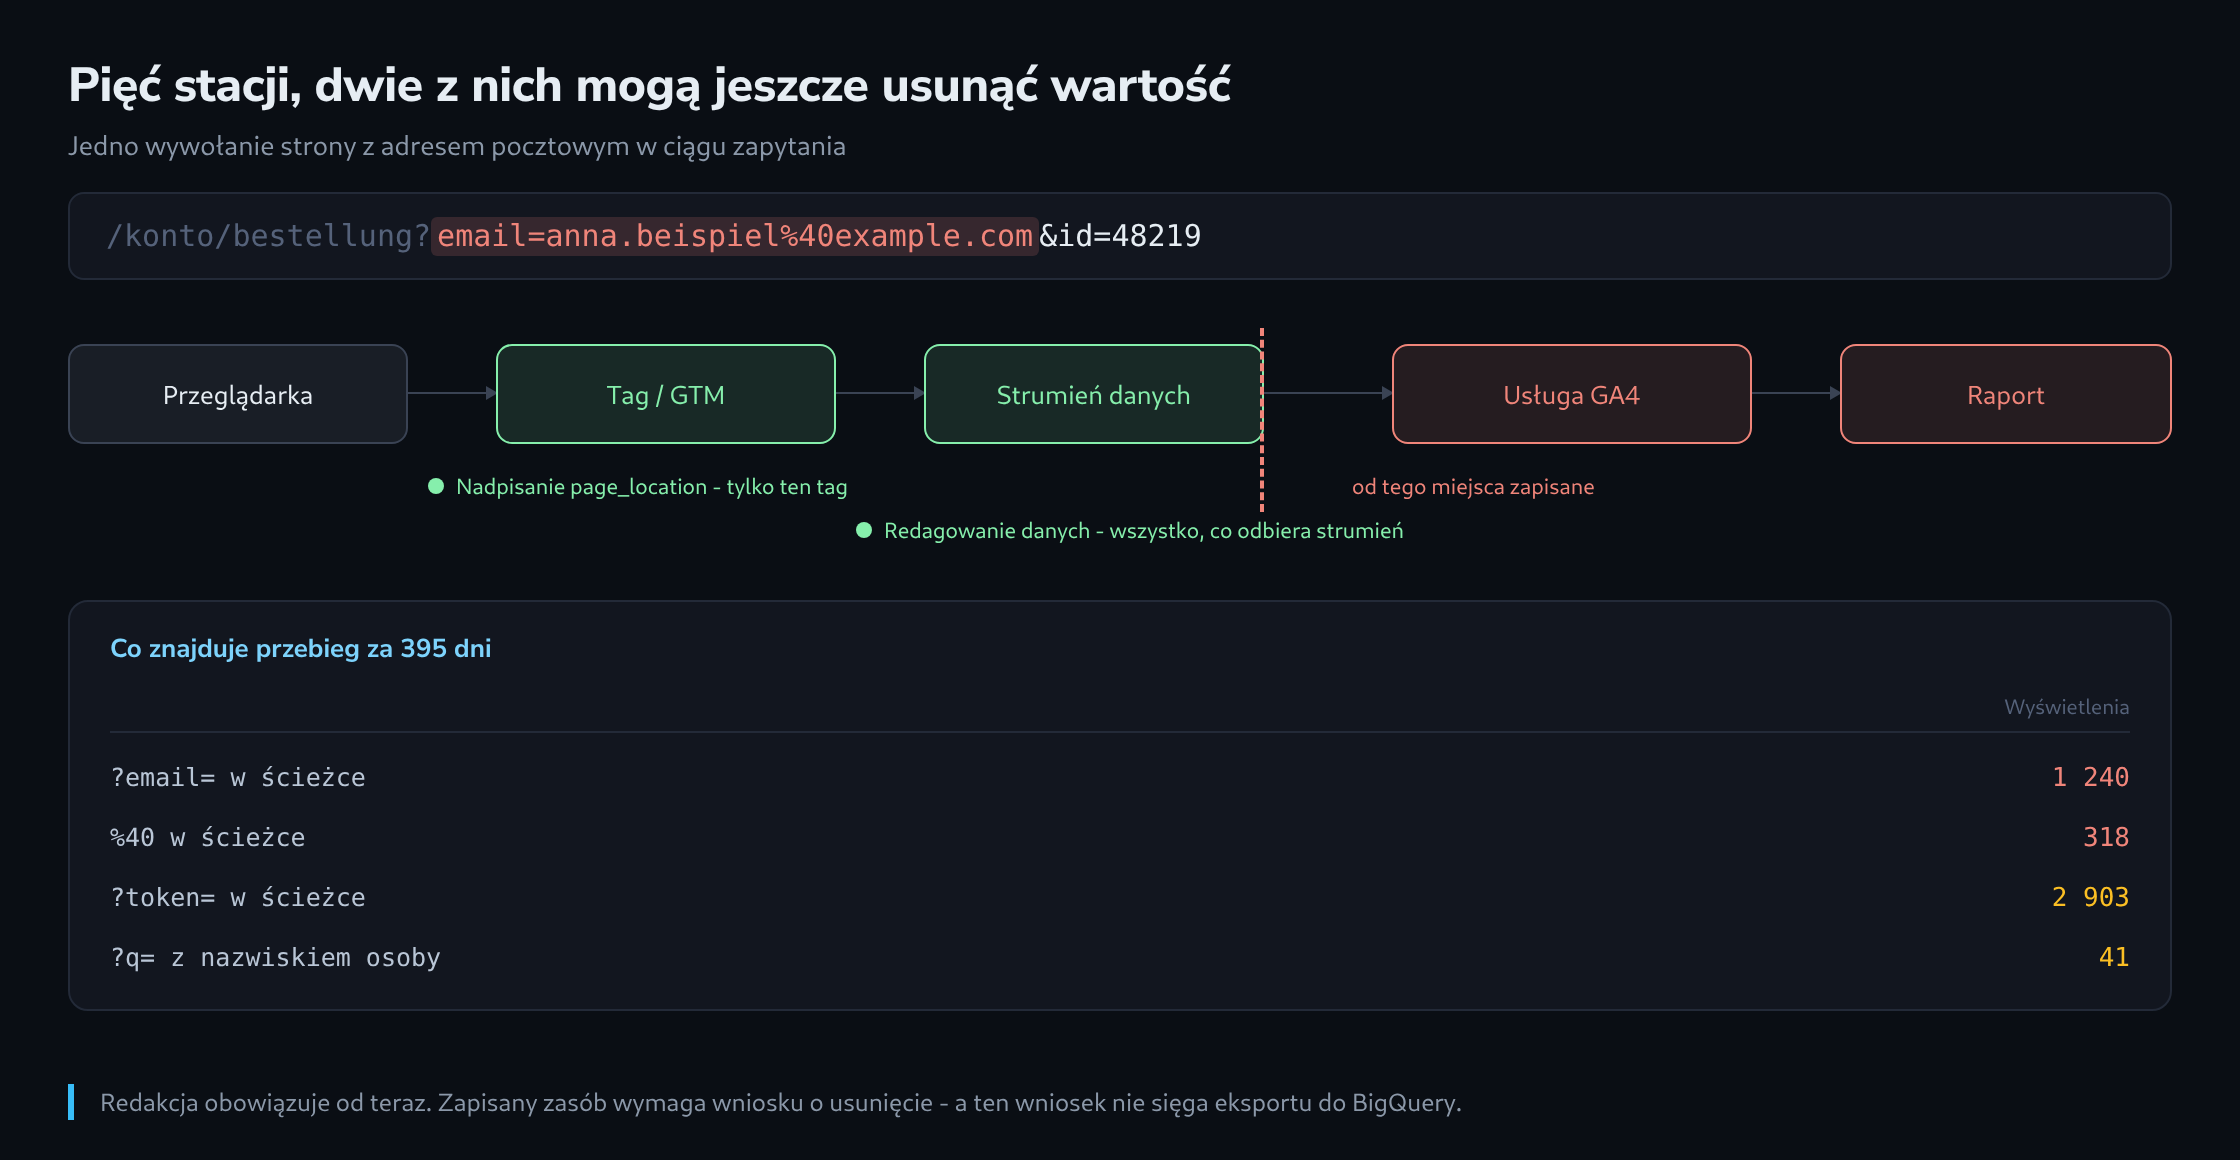
Gdy znaleziska są znane, wyciek zamyka się w najwcześniejszym opanowanym miejscu. GA4 oferuje to na samym strumieniu danych i obowiązuje to dla wszystkiego, co strumień odbiera, niezależnie od tego, który tag wysłał.
Ustawienie siedzi w administracji przy strumieniu internetowym, w ustawieniach tagu, pod nazwą Redagowanie danych. Składa się z dwóch części: automatycznego usuwania wszystkiego, co wygląda jak adres pocztowy, oraz listy nazw parametrów, których wartości zostają zastąpione przed zapisem.
token, hash, auth, key, sig, pwd, password,
email, mail, e-mail, user, username,
phone, tel, mobile,
name, firstname, lastname
Ta lista należy do tego samego miejsca co wyniki przebiegu i powinna być uzupełniana, gdy tylko przebieg znajdzie nowy parametr. Redakcja działa dokładnie: parametr zapisany na jednej stronie inaczej – e_mail zamiast email – przechodzi nietknięty.
Dwie uwagi o umiejscowieniu wobec pozostałych dróg. Nadpisanie page_location w menedżerze tagów też działa i chwyta wcześniej, ale wyłącznie dla trafień tego jednego tagu; drugi tag albo wywołanie gtag wpisane na stałe w motyw je omija. Czyszczenie w kontenerze serwerowym jest drogą najmocniejszą i jedyną chroniącą także przekazanie do platform reklamowych – to osobna praca z własnym artykułem. Ustawienie strumienia jest tym, które kosztuje dziesięć minut i obejmuje wszystko.
Już zapisany zasób
Redakcja obowiązuje dla trafień od tej chwili. Nie zmienia nic w wierszach leżących już w usłudze – a właśnie one liczą się dla pytania o ochronę danych.
Usuwa je wniosek o usunięcie danych, w administracji na poziomie usługi. Właściwy typ kasuje wybrane parametry we wszystkich zdarzeniach, a adres strony jest jednym z tych parametrów.
Trzy właściwości tego trybu warto poznać przed uruchomieniem. Ma okres oczekiwania liczony w dniach, w którym da się go wycofać – to zamierzone i pożyteczne. Raz uruchomiony, potrzebuje do około dwóch miesięcy na pełne zastosowanie. I jest nieodwracalny: wymiar strony z tego okresu przepada potem także dla ścieżek nieszkodliwych, jeżeli wniosek obejmował cały parametr.
Czego wniosek nie dotyka, to eksport do BigQuery. Dane wyeksportowane przed usunięciem leżą w zbiorze, nad którym usługa nie ma już władzy, i tam trzeba je usunąć osobno – instrukcją UPDATE na każdej tabeli dziennej, jak poniżej, instrukcją DELETE albo przez zbudowanie tabeli na nowo, za ten sam okres.
FOR t IN (
  SELECT table_name
  FROM `projekt`.analytics_123456789.INFORMATION_SCHEMA.TABLES
  WHERE table_name BETWEEN 'events_20260101' AND 'events_20260920')
DO
EXECUTE IMMEDIATE FORMAT(r"""
UPDATE `projekt.analytics_123456789.%s`
SET event_params = ARRAY(
      SELECT AS STRUCT
        p.key,
        IF(p.key = 'page_location',
           STRUCT(REGEXP_REPLACE(p.value.string_value,
                  r'([?&](?:email|token|phone)=)[^&]*', r'\1[entfernt]')
                  AS string_value, p.value.int_value,
                  p.value.float_value, p.value.double_value),
           p.value) AS value
      FROM UNNEST(event_params) AS p)
WHERE TRUE""", t.table_name);
END FOR;
Czego przebieg nie widzi
Trzy miejsca niosą ten sam rodzaj danych i w tym raporcie się nie pojawiają.
Pierwszym są parametry zdarzeń poza adresem strony. Pomiar formularza wysyłający wpisaną wartość jako parametr odkłada ją do wymiaru niestandardowego, a powyższy przebieg nigdy tam nie zagląda. To samo zapytanie Data API z wymiarem niestandardowym zamiast ścieżki strony ją znajduje, i takie zapytanie warto wykonać raz dla każdego zgłoszonego wymiaru.
Drugim jest pole identyfikatora użytkownika. Usługa mająca odbierać identyfikator użytkownika, a dostająca zamiast tego adres pocztowy, to naruszenie podręcznikowe i w raportach niewidoczne, bo w większości z nich pole to w ogóle nie występuje. Sprawdzenie jest takie jak wszędzie: obejrzeć prawdziwe wartości, a nie nazwę pola.
Trzecim jest wszystko, co dom już opuściło. Jeżeli trafienia szły także do platformy reklamowej, redakcja w GA4 nie zmienia nic w kopii, która tam dotarła – a ta platforma ma własną drogę usuwania. Listę odbiorców warto spisać przed pierwszym wnioskiem o usunięcie, bo sam wniosek jej nie wytwarza.
Pytania i odpowiedzi
Czy ten sam wyciek może trafić do usługi także przez referrer?
Tak. Gdy odnośnik prowadzi ze strony z danymi w adresie na inną stronę tej samej witryny, przeglądarka przy zwykłym ustawieniu domyślnym przekazuje pełny adres jako referrer, a GA4 zapisuje go w parametrze page_referrer następnej strony. Przebieg warto więc powtórzyć z wymiarem pageReferrer zamiast ścieżki strony, a wniosek o usunięcie obejmujący tylko adres strony zostawia tę kopię nietkniętą. Obce serwery dostają przez referrer przy tym samym ustawieniu tylko pochodzenie strony, dopóki strona nie ustawi luźniejszej zasady Referrer-Policy.
Czy wystarczy przestawić formularz z GET na POST?
Dla wycieku w tym miejscu tak, dla reszty nie. Przy POST pola są przesyłane w treści żądania zamiast w adresie, więc nie docierają ani do GA4, ani do logu dostępu serwera, ani do historii przeglądarki.
Decydująca jest strona, która pojawia się potem. Jeśli serwer po wysłaniu przekierowuje na adres bez danych, ten adres pozostaje czysty, a odświeżenie nie wysyła formularza po raz drugi. Jeśli natomiast przekierowanie dopisuje wpisane dane z powrotem do adresu, na przykład jako potwierdzenie na stronie z podziękowaniem, wyciek wraca, tylko o jedną stronę później.
Przestawienie nie rusza wierszy już zapisanych; zostają, dopóki nie obejmie ich wniosek o usunięcie danych. Dla pola wyszukiwania POST zwykle nie jest rozwiązaniem, bo stron wyników nie da się wtedy linkować. Tam zostaje GET, a ochronę zapewniają redakcja i przeczytanie prawdziwych wartości, jak opisuje artykuł.
Czy GA4 zapisuje wyszukiwane wyrażenia jeszcze gdzieś poza ścieżką strony?
Tak, gdy tylko w pomiarze zaawansowanym włączone jest wyszukiwanie w witrynie. GA4 odczytuje wtedy parametr wyszukiwania z adresu i oprócz odsłony wysyła zdarzenie view_search_results, którego parametr search_term niesie wyrażenie po raz drugi. Przebieg z artykułu tej kopii nie widzi, bo odpytuje wyłącznie wymiar strony.
To samo zapytanie Data API z wymiarem searchTerm zamiast pagePathPlusQueryString ją zwraca, a do zwróconych wartości należy zastosować te same wzorce. Wniosek o usunięcie obejmujący tylko adres strony zostawia search_term nietknięty. To, czy wyrażenia są danymi osobowymi, również tutaj rozstrzyga przeczytanie prawdziwych wartości, a nie nazwa parametru.
Czy dane w BigQuery znikają od razu po oczyszczeniu?
Nie od razu. BigQuery przechowuje stan sprzed każdej zmiany na potrzeby podróży w czasie, domyślnie przez siedem dni, w których da się go nadal odpytać przez FOR SYSTEM_TIME AS OF, a potem przez kolejne siedem dni jako fail-safe, z którego przywrócić go może już tylko wsparcie Google. Okno podróży w czasie da się dla zbioru danych skrócić do minimum dwóch dni; migawki, kopie z zaplanowanych zapytań i tabele w innych projektach wymagają osobnego oczyszczenia.
Kontrola w praktyce: porównanie wielu żądań Collect
Analizator parametrów GA4 może teraz badać kilka przeglądarkowych żądań Collect razem. Każdy wiersz zawiera jeden adres lub ciąg query/body zakodowany jak parametry URL. Jeżeli parametry należą do wspólnego adresu żądania POST, osobne pole wspólnych parametrów pokazuje ten kontekst w każdym wierszu.
Przegląd przedstawia nazwy zdarzeń, identyfikatory pomiaru i powtarzające się klucze. Porównanie pokazuje tylko różnice: brak klucza różni się od klucza z pustą wartością. Różne typy zdarzeń naturalnie zawierają różne parametry, więc sama różnica nie dowodzi błędu pomiaru. Powtórzone klucze zachowują pierwotną kolejność. Narzędzie nie twierdzi, które wystąpienie wykorzystuje odbiorca.
Wartości są dekodowane raz i wyświetlane jako tekst, również gdy przypominają HTML. Opcjonalny plik CSV zawiera zdekodowane wartości i nie jest anonimizowany. Analizator pomaga więc sprawdzić nieoczekiwany adres strony lub parametr, ale nie jest kompletnym detektorem danych osobowych. Brak widocznego problemu nie dowodzi, że wdrożenie nie zawiera takich danych.
Wklejone żądania nie są odtwarzane ani wysyłane. Narzędzie opisuje wejście, a nie przyjęcie danych przez Google. Rzeczywisty pomiar można w odpowiednich przypadkach sprawdzić w Google DebugView. Dekodowanie query opiera się na regułach kodowania formularzowego URL; spakowane segmenty produktów są interpretowane heurystycznie. Dla JSON Measurement Protocol przeznaczony jest osobny walidator.
Powiązane artykuły