

 English
 Deutsch
 Polski
robots.txt: wybór reguł i interpretacja próby dwudziestu domen

Management Summary
Plik robots.txt zawiera zasady dostępu dla współpracujących programów wyszukiwania i AI odwiedzających witrynę. Reguły mogą różnić się według programu i części strony, dlatego pojedynczy wiersz nie opisuje całej polityki. Artykuł wyjaśnia nakładające się instrukcje i ograniczenia porównania dwudziestu domen. Pomaga to ocenić dostępność treści dla konkretnego automatycznego odwiedzającego. Reguły nie zabezpieczają poufnych stron ani nie dowodzą rzeczywistego zachowania robotów.
Spis treści
robots.txt przekazuje instrukcje współpracującym crawlerom, czyli programom automatycznie pobierającym strony. Ocena wymaga rozdzielenia trzech kwestii: wyniku pobrania pliku, pasujących grup crawlera i najbardziej szczegółowej reguły ścieżki. Pierwsza pasująca linia nie wygrywa automatycznie, a powtórzonych pasujących grup nie wolno po prostu pominąć.
Historyczny test z 6 września 2026 r. obejmował dwadzieścia domen, osiem identyfikatorów i osiem ścieżek. Ponowna analiza archiwum i analizatora ujawnia ważne ograniczenia: zapisana macierz jest dawnym wynikiem narzędzia, a nie dowodem rzeczywistego zachowania crawlerów lub blokady całej witryny.
Wybór odpowiednich reguł
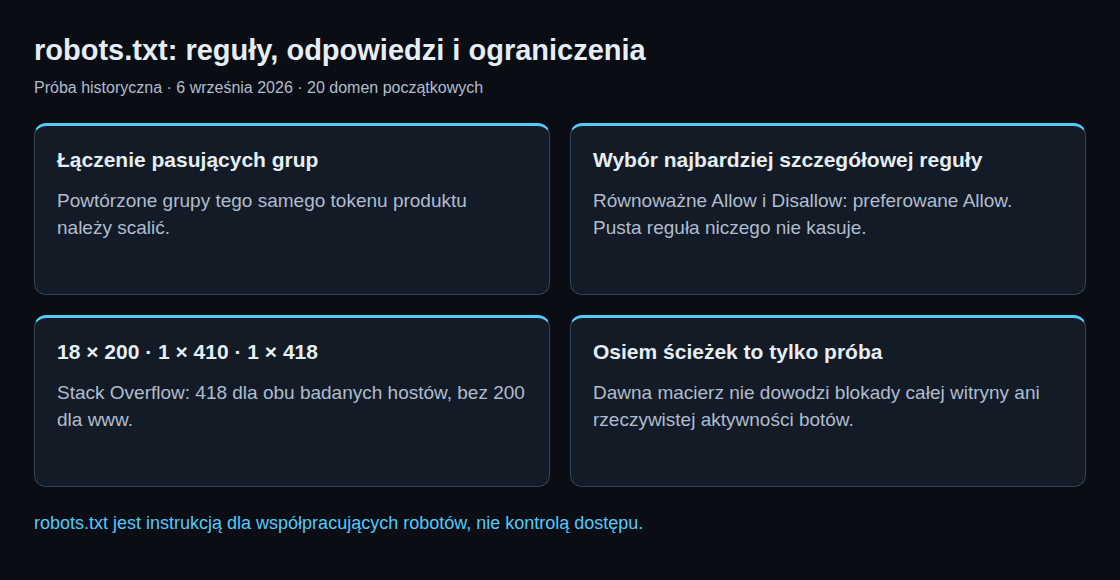
RFC 9309 porównuje token produktu crawlera bez rozróżniania wielkości liter i wymaga połączenia wielu pasujących grup. Google dodatkowo opisuje wybór najbardziej szczegółowego pasującego identyfikatora; powtórzone grupy dla tego identyfikatora zostają scalone. Grupa szczegółowa nie jest łączona z grupą zastępczą *. Sam najdłuższy prefiks dowolnego nagłówka HTTP User-Agent nie opisuje całego standardu.
Wśród odpowiednich reguł wygrywa najbardziej szczegółowa pasująca ścieżka. Porównanie zaczyna się od początku ścieżki i porównuje bajty, zwane oktetami, zamiast jedynie liczyć widoczne znaki. Zapisy procentowe, takie jak %62 oznaczające literę b, wymagają przed porównaniem ujednolicenia zgodnie z regułami protokołu. Przy równoważnych Allow i Disallow preferowane jest Allow. Ścieżki są normalnie porównywane z uwzględnieniem wielkości liter. * oznacza zero lub więcej znaków, a $ koniec.
Puste Disallow: jest ignorowane. Nie usuwa innego zakazu z odpowiednich reguł. Poniższy samodzielny przykład dopuszcza /private/help.html, ale blokuje inne ścieżki zaczynające się od /private/, w tym /private/report.html:
User-agent: ExampleBot
Disallow: /private/
Disallow:

User-agent: ExampleBot
Allow: /private/help.html$
Druga grupa ExampleBot wnosi wyjątek. Parser zachowujący tylko pierwszą grupę daje błędny wynik. Puste linie lub komentarze między kolejnymi deklaracjami user-agent nie mogą przypadkowo odłączać późniejszych reguł.
Co rzeczywiście pokazuje historyczny przebieg
Archiwum zawiera osiemnaście odpowiedzi HTTP 200, jedną 410 z heise.de i jedną 418 ze stackoverflow.com. Szesnaście adresów początkowych miało przekierowania. Dodatkowy test www.heise.de zwrócił 200; test www.stackoverflow.com również zwrócił 418. Dla Stack Overflow zapisano 113 bajtów, a nie pustą treść. Nie ustala to intencji operatora ani nie dowodzi błędu konfiguracji przekierowań.
Dawna macierz oznaczyła wszystkie osiem ścieżek testowych jako zabronione dla GPTBot i CCBot w sześciu domenach, ClaudeBot w pięciu oraz Google-Extended, PerplexityBot i Applebot-Extended po cztery. Liczby opisują zapisany wynik narzędzia. Osiem ścieżek nie dowodzi blokady każdego URL-a witryny, a opisane niżej błędy parsera uniemożliwiają uznanie dawnych klasyfikacji za niezależnie potwierdzoną politykę dostawców.
Czternaście domen nie miało takiego wyniku osiem-z-ośmiu dla żadnego z sześciu identyfikatorów. Dwanaście nie miało żadnej zabronionej ścieżki testowej dla żadnego z nich. To różne liczby: google.com i microsoft.com miały częściowe ograniczenia w zapisanym wyniku. Pierwotny diagram mieszał te kategorie.
Podsumowanie podaje do 105 grup w głównych testach i 28 275 bajtów dla największego pliku. Liczba grup zależy od parsera. Zwracana lista map witryn była ograniczona do dwudziestu pozycji, więc zapisana wartość dwadzieścia nie dowodzi dokładnie dwudziestu deklaracji. Znacznik kolejności bajtów również nie identyfikuje użytego edytora.
Najpierw interpretacja statusu pobrania
Po udanym pobraniu znaczenie mają reguły możliwe do odczytania. RFC 9309 pozwala na crawling przy niedostępnym robots.txt, na przykład po odpowiedzi 4xx. To zezwolenie w ramach protokołu, nie dowód fizycznego nieistnienia pliku. Błędy sieci i serwera wymagają natomiast założenia całkowitego zakazu, z uwzględnieniem pamięci podręcznej i długotrwałych awarii. Trzydzieści dni to w standardzie przykład dłuższego okresu, a nie uniwersalny zegar.
Google dokumentuje własny przebieg: błędy serwera początkowo zatrzymują crawling na dwanaście godzin; późniejsze zachowanie zależy od ostatniej poprawnej kopii i ogólnej dostępności witryny. Google traktuje 429 inaczej niż pozostałe 4xx. Pojedynczy kod statusu nie określa więc zachowania niezależnie od czasu, pamięci i implementacji.
Host, schemat i port wyznaczają zakres. Przekierowanie robots.txt może prowadzić do innego hosta, a odczytane tam reguły nadal obowiązują dla pierwotnego adresu. Zapora powinna udostępniać właściwą odpowiedź robots.txt uprawnionym crawlerom. Plik nie zastępuje uwierzytelniania ani innych kontroli dostępu.
Sześć identyfikatorów nie oznacza sześciu crawlerów treningowych
GPTBot i ClaudeBot dotyczą zbierania danych do rozwoju modeli ich dostawców. CCBot tworzy otwarte archiwum WWW Common Crawl. PerplexityBot według dostawcy służy odkrywaniu stron w wyszukiwaniu, a nie treningowi modeli bazowych. Oddzielne roboty wyszukiwania lub pobrania inicjowane przez użytkownika mogą podlegać innym zasadom.
Google-Extended nie ma osobnego agenta HTTP. Token kontroluje określone zastosowania treningowe i grounding w Gemini, bez zmiany obecności lub pozycji w Google Search. Applebot-Extended także nie crawluje samodzielnie; steruje użyciem danych Applebota do treningu modeli bazowych. Żaden z tokenów nie kontroluje zbiorczo wszystkich funkcji AI ani każdego żądania.
Ograniczenia podlinkowanej macierzy
Macierz crawlerów robots.txt pokazuje do ośmiu identyfikatorów wobec dwunastu ścieżek i wskazuje zwycięską linię. Sprawdzona implementacja zachowuje jednak tylko jedną pasującą grupę, błędnie rozpoznaje część granic grup z pustymi liniami, nie zapewnia wymaganej normalizacji procentowej i może pokazywać dozwolone komórki po błędzie sieciowym. Ogólna obsługa 4xx nie odtwarza również zachowania Google dla 429. To konkretne ograniczenia, a nie kwestie pozostawione bez rozstrzygnięcia przez RFC.
Historyczne podsumowania nie zawierają kompletnych plików reguł. Poprawionej dawnej oceny nie da się odtworzyć wyłącznie z tych podsumowań. Bieżący test wymaga rzeczywistego pliku, statusu, łańcucha przekierowań, właściwych tokenów i reprezentatywnych ścieżek, porównanych z dokumentacją danego crawlera.
Pytania i odpowiedzi
Czy Disallow usuwa adres z wyszukiwarki?
Nie zapewnia tego niezawodnie. Crawling i indeksowanie to osobne procesy. Google musi pobrać stronę, aby odczytać meta noindex lub X-Robots-Tag. Prywatna treść wymaga kontroli dostępu, nie tylko instrukcji crawlowania.
Czy strona błędu HTML ze statusem 200 oznacza brak reguł?
Niekoniecznie. Google próbuje odczytać prawidłowe reguły i pomija inne linie. Status, typ treści i zawartość wymagają sprawdzenia. Otoczka HTML nie zastępuje poprawnego pliku tekstowego UTF-8.
Czy Crawl-delay działa uniwersalnie?
Nie. Pole znajduje się poza podstawowym protokołem, a obsługa jest różna. Google go nie obsługuje; Anthropic dokumentuje obsługę. Limity i sposoby sterowania wymagają sprawdzenia dla właściwego dostawcy.
Czy zmiany działają natychmiast?
Niekoniecznie. Zapisane kopie robots.txt i przetwarzanie u dostawcy wprowadzają opóźnienie. RFC zasadniczo odradza używanie kopii przez ponad dwadzieścia cztery godziny, chyba że plik jest nieosiągalny. Test parsera nie dowodzi, że crawler już pobrał nową wersję.
Powiązane artykuły


