

 English
 Deutsch
 Polski
Struktura zamiast indeksu czytelności: co da się zmierzyć bez renderowania

Management Summary
Narzędzia czytelności przedstawiają w liczbach cechy takie jak długość zdań czy układ nagłówków. W artykułach internetowych pomagają wskazać fragmenty do przeglądu, ale nie mierzą zrozumienia, poprawności ani całego doświadczenia czytania. Analiza kodu źródłowego może pomijać listy, ukryte treści lub materiał dodany później. Wartość takich wyników polega na wspieraniu decyzji redakcyjnych. Nadal najważniejsze są jasne wyjaśnienia, odpowiednie przykłady i rzeczywista postać strony.
Spis treści
Pojedynczy indeks czytelności nie określa, czy tekst jest zrozumiały, poprawny i przydatny. Długość zdań może wskazać fragmenty wymagające uwagi; terminologia, przykłady, wiedza wstępna i rozumowanie wymagają oceny redakcyjnej. Formalnie poprawna struktura HTML nie zastępuje takiej oceny.
Analiza bez renderowania, czyli bez budowania i wyświetlania strony w przeglądarce, nadal dostarcza wskazówek: znaczników nagłówków, wybranych akapitów i rozmiaru otrzymanego HTML. Najważniejsze jest ustalenie, jaki fragment bada konkretne narzędzie.
HTML serwera nie jest widokiem czytnika ekranu
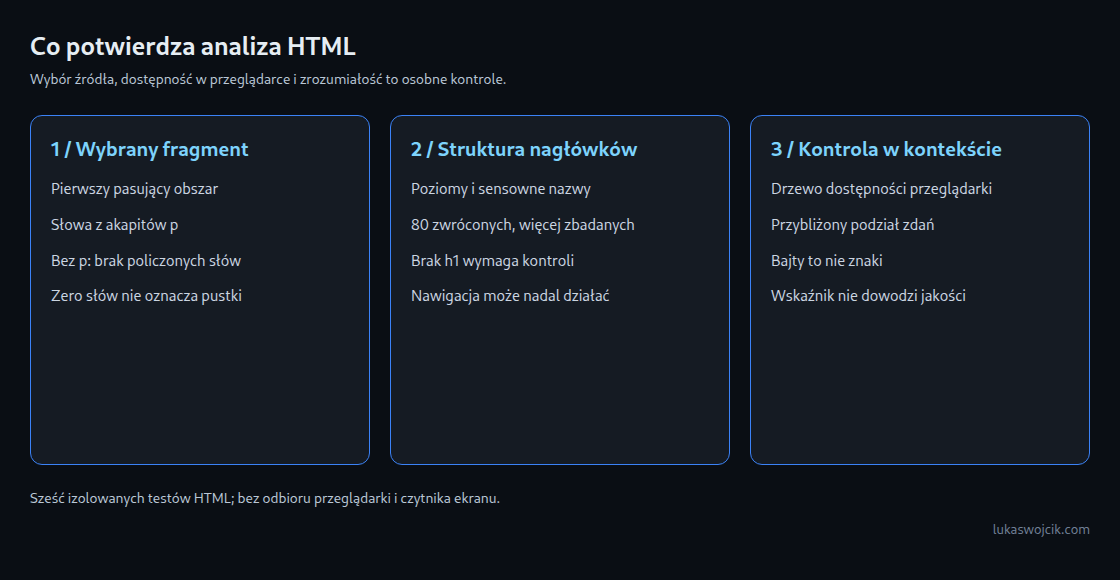
Zwykłe pobranie HTTP nie obejmuje późniejszych zmian JavaScriptu. Czytnik ekranu zazwyczaj korzysta z informacji o dostępności udostępnianych przez przeglądarkę i wyprowadzanych z DOM, czyli aktualnej struktury elementów strony w przeglądarce. Nagłówki utworzone dynamicznie mogą być tam obecne. Terminowość udostępnienia treści, sensowne nazwy i obsługa elementów wymagają testu przeglądarki oraz technologii asystującej.
Różnią się również crawlery. Google może renderować JavaScript, z ograniczeniami i w osobnym etapie przetwarzania. Jedno pobranie bez JavaScriptu nie reprezentuje więc każdej wyszukiwarki ani generatora podglądu. Główna treść dostarczana przez serwer ułatwia dostęp klientom bez skryptów, ale nie zastępuje testu.
Co liczy inspektor
Inspektor struktury i czytelności strony w implementacji sprawdzonej 25 października 2026 najpierw wybiera obszar główny: na przykład pierwszy main albo pierwszy article, gdy nie ma main. Oczyszczony body jest używany dopiero bez pasującego obszaru. Nagłówki poza tym wyborem mogą zniknąć z wyniku, mimo obecności w całym dokumencie.
Słowa i zdania pochodzą wyłącznie z odpowiednich akapitów p po usunięciu kodu. Tekst list, komórek tabel i nagłówków poza takimi akapitami nie dostarcza słów do tej liczby. Prosty test z nagłówkiem i widoczną listą daje zatem zero policzonych słów. Nie dowodzi to pustej strony ani aplikacji tworzącej całą treść po stronie klienta.
Inspektor nie analizuje widoczności CSS. Ukryte akapity mogą zostać policzone, natomiast zawartość noscript jest usuwana. Ucięty HTML oznacza dodatkowo niepełne źródło. Interpretacja musi uwzględniać te zasady wyboru.
Ocena nagłówków
Opisowy nagłówek główny i spójne poziomy podrzędne ułatwiają orientację. Przejście bezpośrednio z h1 do h3 uzasadnia kontrolę hierarchii. Powrót z h3 do h2 może prawidłowo rozpoczynać kolejny dział na wcześniejszym poziomie.
Brak h1 nie niszczy automatycznie nawigacji po nagłówkach. Nagłówki takie jak h2 nadal mogą służyć do przechodzenia po stronie. Tytuł dokumentu, nazwane obszary i dostępne nazwy stanowią dodatkowe punkty orientacyjne. Sama liczba nagłówków nie dowodzi użycia wyłącznie do układu graficznego ani złej zrozumiałości.
Inspektor zwraca najwyżej 80 nagłówków, ale wewnętrznie analizuje także kolejne rozpoznane nagłówki. Izolowany test rozpoznał 91 i zwrócił 80. Lista 80 wpisów nie jest więc pełną liczbą elementów. Pusta treść tekstowa elementu wymaga również sprawdzenia dostępnej nazwy, zanim powstanie wniosek o nienazwanej sekcji.
Miara tekstu nie jest miarą transferu
Wskaźnik porównuje znaki z wybranych akapitów z bajtami dostępnego HTML. To różne jednostki i różne zakresy. Wynik nie określa rzeczywistego udziału widocznego tekstu ani całego transferu sieciowego. Kompresja, kodowanie znaków i osobno pobierane zasoby wpływają na inne pomiary.
Przy zerowej liczbie znaków wyrażenie „bajty na znak tekstu” nie jest określone. Wysoki wynik może wynikać ze skryptów, osadzonych danych lub pominiętych obszarów tekstu. Porównania wymagają jednakowych reguł wyboru i podobnych typów stron.
Długość zdań jako wskazówka
Kropka może oznaczać skrót, liczbę albo koniec zdania. Obecne reguły rozpoznają część typowych skrótów i zapisów liczb, lecz nie wyznaczają niezawodnie każdej granicy zdania. W teście „Der Wert lag bei 12. Danach folgte Text.” pozostało jednym policzonym zdaniem. Ogólne zapewnienie o rzadkości takich błędów wymagałoby ocenionego zbioru tekstów.
Długie fragmenty wymagają lektury w kontekście: nadmiernie zagnieżdżone rozumowanie, brak przykładu lub niejasny termin mogą mieć większe znaczenie niż liczba słów. Spójne dłuższe wyjaśnienie może być lepsze od kilku krótkich, niepowiązanych zdań.
Pytania i odpowiedzi
Czy puste alt zawsze jest błędem?
Nie. Obraz czysto dekoracyjny może prawidłowo mieć alt="". Inspektor odróżnia brak atrybutu od istniejącej pustej wartości, ale nie ocenia trafności alternatywy. Obraz informacyjny wymaga odpowiedniego tekstu alternatywnego.
Czy grep i sort sprawdzają hierarchię nagłówków?
Zliczanie posortowanych znaczników otwierających gubi kolejność dokumentu i tekst nagłówków. Nie powstaje z tego drzewo nagłówków. Kontrola struktury wymaga uporządkowanych elementów z poziomami i nazwami, a następnie sprawdzenia wyrenderowanego dokumentu.
Co rzeczywiście podnosi jakość artykułu?
Jasne terminy, odpowiednie przykłady, spójna kolejność i poprawne informacje. Miary techniczne pomagają wybierać fragmenty do kontroli; zrozumiałość zależy od konkretnego tekstu i docelowych odbiorców.
Powiązane artykuły


