English
 Deutsch
KI-Agenten in der Webanalyse: Wie agentischer Traffic GA4 verzerrt und sich serverseitig trennen lässt

Inhalt
- Drei Klassen von KI-Besuchen
- Der neue AI-Assistant-Kanal in GA4: was er misst und was nicht
- Die blinde Stelle: agentische Browser im Datensatz
- Agenten-Identität: vom User-Agent zur kryptografischen Signatur
- Architektur: Klassifikation vor dem Tracking
- Implementierung: von der Anfrage bis zur BigQuery-Auswertung
- WebMCP: Agenten-Interaktionen als saubere Events messen
- Datenhygiene: Hostname-Allowlist und serverseitige Events
- Checkliste für die nächsten 30 Tage
- Fazit
- Fragen und Antworten
- Quellen
KI-Agenten sind 2026 vom Experiment zum messbaren Traffic-Faktor geworden – und die meisten Analytics-Setups zählen sie schlicht als Menschen. Agenten rufen Seiten auf, scrollen, füllen Formulare aus und legen Produkte in den Warenkorb. Im GA4-Bericht erscheint das als ganz normale Sitzung mit Chrome-Browser, häufig als „Direct“, manchmal sogar als organischer Traffic.
Die Größenordnung ist nicht mehr vernachlässigbar. Laut HUMAN Security wuchs der Traffic von KI-Agenten und agentischen Browsern 2025 um 7.851 % gegenüber dem Vorjahr. Im August-2026-Benchmark legte agentischer Traffic erneut um 27 % zu und erreichte einen neuen Höchststand.
Gleichzeitig hat Google im Mai 2026 einen eigenen Kanal „AI Assistant“ in GA4 eingeführt. Das klingt nach Lösung, misst aber nur einen Ausschnitt. Dieser Beitrag zeigt, welche Arten von KI-Besuchen es gibt, welche davon GA4 tatsächlich erkennt und wie sich agentischer Traffic serverseitig klassifizieren und sauber in die Auswertung übernehmen lässt – mit konkreten Code-Beispielen.
Drei Klassen von KI-Besuchen
„KI-Traffic“ ist kein einheitliches Phänomen, sondern zerfällt technisch in drei Klassen mit völlig unterschiedlichem Messverhalten. Wer sie in einen Topf wirft, bekommt weder saubere Nutzerzahlen noch eine belastbare Aussage zum Wert von KI als Kanal.
| Klasse | Beispiele | Führt JavaScript aus | Erscheint in GA4 | Erkennbar über |
|---|---|---|---|---|
| KI-vermittelte Menschen | Klick auf eine Quelle in ChatGPT, Gemini, Claude, Perplexity | ja | ja, oft im Kanal „AI Assistant“ | Referrer, UTM-Parameter |
| Serverseitige Abrufe im Nutzerauftrag | ChatGPT-User, Claude-User, Perplexity-User | meist nein | nein | User-Agent, IP-Listen, Server-Logs |
| Agentische Browser | Perplexity Comet, ChatGPT Agent, Chrome Auto Browse, Google-Agent | ja | ja, als normale Sitzung | schwierig: teils User-Agent-Token, teils Signaturen, teils gar nicht |
Dazu kommen klassische Trainings- und Such-Crawler wie GPTBot oder OAI-SearchBot. Diese Crawler führen in der Regel kein JavaScript aus und tauchen daher nur in Logs auf, nicht im Tag-basierten Tracking.
Das eigentliche Problem ist die dritte Klasse. Agentische Browser führen das Tracking-Skript aus, setzen Cookies, lösen Events aus – und verhalten sich dabei nicht wie ein Mensch. Genau diese Sitzungen verändern Conversion-Raten, Absprungverhalten und Funnel-Analysen, ohne als Agent markiert zu sein.
Der neue AI-Assistant-Kanal in GA4: was er misst und was nicht
Der Kanal „AI Assistant“ erfasst ausschließlich Klicks von Menschen mit erkennbarem Referrer – also nur die erste der drei Klassen. Laut Googles Release Notes vom 13. Mai 2026 setzt GA4 das Medium auf „ai-assistant“, sobald der Referrer zu einem bekannten KI-Assistenten passt. Diese Besuche landen in der Default Channel Group als „AI Assistant“, die Kampagne heißt „(ai-assistant)“.
Ergänzend gibt es seit dem 11. Juni 2026 die Dimension Source Group. Die Dimension fasst Quellwerte zusammen und enthält laut Google bereits Gruppierungen für ChatGPT (OpenAI) und Perplexity – rückwirkend befüllt, also auch für historische Zeiträume nutzbar.
Drei Lücken bleiben trotzdem:
- Fehlender Referrer. Übergänge aus nativen Apps in den Browser liefern häufig keinen Referrer. Solche Besuche fallen in „Direct“, obwohl ein KI-Assistent der Auslöser war. Ein Teil wird durch UTM-Parameter gerettet, etwa
utm_source=chatgpt.com, den ChatGPT an viele Links anhängt. - KI-Funktionen innerhalb von Google. Klicks aus AI Overviews oder dem AI Mode kommen vom Google-Referrer und bleiben damit Teil von „Organic Search“. Der neue Kanal trennt sie nicht ab.
- Agenten statt Menschen. Ein agentischer Browser, der im Auftrag eines Nutzers eine Produktseite öffnet, hat oft gar keinen Referrer oder einen beliebigen. Der Kanal sagt über diese Sitzungen nichts aus – sie stecken unerkannt in allen Kanälen.
Für eine erste Einordnung ist der Kanal trotzdem wertvoll: Der Bericht zeigt, welche Inhalte in KI-Antworten als Quelle verlinkt werden und wie gut dieser Traffic im Vergleich zu Organic konvertiert.
Die blinde Stelle: agentische Browser im Datensatz
Agentische Browser basieren auf Chromium, führen das Tracking normal aus und geben sich standardmäßig als gewöhnliches Chrome aus. Die IAB-Bot-Liste, auf die sich GA4 bei der Bot-Filterung stützt, greift hier nicht, wie Snowplow analysiert hat. Seer Interactive beobachtete in einem Test sogar, dass OpenAIs Agent in GA4 als Bing/organic auftauchte.
Der Markt hat sich 2026 spürbar sortiert:
- Perplexity Comet war im August 2026 laut HUMAN mit 40,7 % die größte Einzelquelle agentischen Traffics.
- OpenAI hat den eigenständigen Browser ChatGPT Atlas am 9. August 2026 eingestellt. ChatGPT Agent, Codex und Atlas zusammen kamen im August auf rund 31 % des agentischen Traffics; Atlas kann darin nur bis zur Einstellung am 9. August beigetragen haben.
- Chrome Auto Browse läuft seit dem 28. Januar 2026 direkt im meistgenutzten Browser. Laut Übersicht von nohacks ist die Funktion weiterhin auf die USA und auf zahlende Google-AI-Pro- und -Ultra-Abos beschränkt. Für DACH-Seiten ist der Effekt daher noch gering, die Reichweite ist aber angelegt.
Zusätzlich blockiert Comet laut TAGGRS standardmäßig Werbung und Tracker. Ein Teil der agentischen Sitzungen fehlt dann komplett, ein anderer Teil wird voll gezählt – eine doppelte Verzerrung, die sich ohne serverseitige Daten nicht auflösen lässt.
Typische Symptome im Datensatz:
- steigende Sitzungen bei stagnierenden Käufen oder Leads
- mehr „Direct“-Traffic auf tiefen Produkt- und Suchseiten ohne erkennbare Kampagne
- Formularstarts und Warenkorb-Events ohne Abschluss, gehäuft auf Desktop-Chrome
- auffällig gleichmäßige Abstände zwischen Events innerhalb einer Sitzung
Wie gering der direkte Umsatzanteil noch ist, zeigt eine weitere HUMAN-Zahl: 2,3 % der agentischen Aktivität fanden 2025 auf Checkout-Seiten statt. Der Großteil der Agenten recherchiert, vergleicht und bricht ab – und drückt damit genau die Kennzahlen, auf denen Optimierungsentscheidungen basieren.
Agenten-Identität: vom User-Agent zur kryptografischen Signatur
Verlässlich erkennbar ist ein Agent nur, wenn er sich selbst ausweist – und 2026 entsteht dafür erstmals ein belastbarer Standard. Die Erkennung läuft heute auf drei Ebenen, die sich in ihrer Vertrauenswürdigkeit deutlich unterscheiden.
1. User-Agent-Token. Am einfachsten, aber fälschbar. Google hat am 20. März 2026 den Fetcher Google-Agent dokumentiert. Laut Google-Dokumentation enthält sein User-Agent das Token compatible; Google-Agent innerhalb eines ansonsten normalen Chrome-Strings. Als nutzerausgelöster Abruf ignoriert Google-Agent die robots.txt.
2. IP-Bereiche und Reverse DNS. Deutlich robuster. Google veröffentlicht die Adressen von Google-Agent in einer eigenen Datei user-triggered-agents.json. Laut PPC Land lösen von Google betriebene Abrufe per Reverse DNS auf google-proxy-***-***-***-***.google.com auf. Die Prüfung erfolgt zweistufig: Reverse-Lookup der IP, dann Forward-Lookup des Hostnamens zurück auf dieselbe IP.
3. Web Bot Auth. Der neue Ansatz signiert jede Anfrage kryptografisch auf Basis von RFC 9421 (HTTP Message Signatures). Die IETF-Arbeitsgruppe webbotauth ist gechartert, das Protokolldokument ist aber noch ein Internet-Draft. Eine signierte Anfrage trägt drei zusätzliche Header, laut Contextbolt etwa so:
Signature-Agent: "https://chatgpt.com"
Signature-Input: sig1=("@authority" "signature-agent");
  created=1786951400; expires=1786951700;
  keyid="poqkLGiymh_W0uP6PZFw-dvez3QJT5SolqXBCW38r0U";
  alg="ed25519"; tag="web-bot-auth"
Signature: sig1=:jP4kZG2h9xQvT1mN...:
Der Server holt den öffentlichen Schlüssel vom Ursprung aus Signature-Agent unter /.well-known/http-message-signatures-directory, sucht den passenden keyid und prüft die Signatur sowie das Zeitfenster aus created und expires. Ein gefälschter User-Agent besteht diese Prüfung nicht.
| Betreiber | Signature-Agent | Stand |
|---|---|---|
| ChatGPT (Cloud-Browser) | https://chatgpt.com | signiert, Schlüssel am Standardpfad veröffentlicht |
| Google-Agent | https://agent.bot.goog | experimentell, nur ein Teil der Anfragen |
| Cloudflare Verified Bots | je Betreiber | Web Bot Auth als eine von zwei akzeptierten Nachweisformen |
| AWS WAF Bot Control | je Betreiber | unterstützt seit 21. November 2025 |
Stand laut Contextbolt, Protokoll-Draft in Revision 02 vom 18. August 2026.
Für die meisten Websites lohnt sich keine Eigenimplementierung der Signaturprüfung. Sinnvoller ist es, die Klassifikation eines CDN oder einer WAF zu übernehmen und deren Ergebnis als Header an die Anwendung weiterzureichen. Genau darauf baut die folgende Architektur auf.
Architektur: Klassifikation vor dem Tracking
Die Trennung gelingt nur, wenn die Klasse eines Besuchs feststeht, bevor das Tracking-Skript auslöst. Nachträgliche Filter in GA4 kommen zu spät, weil ihnen die serverseitigen Signale fehlen: Signaturen, IP-Herkunft, Reverse DNS.
Drei Prinzipien tragen die Architektur:
- Verifizieren am Rand. CDN oder WAF prüfen Web Bot Auth, IP-Listen und Reverse DNS und reichen das Ergebnis als Header weiter.
- Einmal klassifizieren. Der Webserver vergibt pro Anfrage genau eine Klasse. Verifizierte Identität hat Vorrang vor der Selbstauskunft per User-Agent.
- Markieren statt löschen. Agenten-Sitzungen bleiben in den Daten, tragen aber eine eigene Dimension. So bleibt der Agenten-Kanal selbst analysierbar.
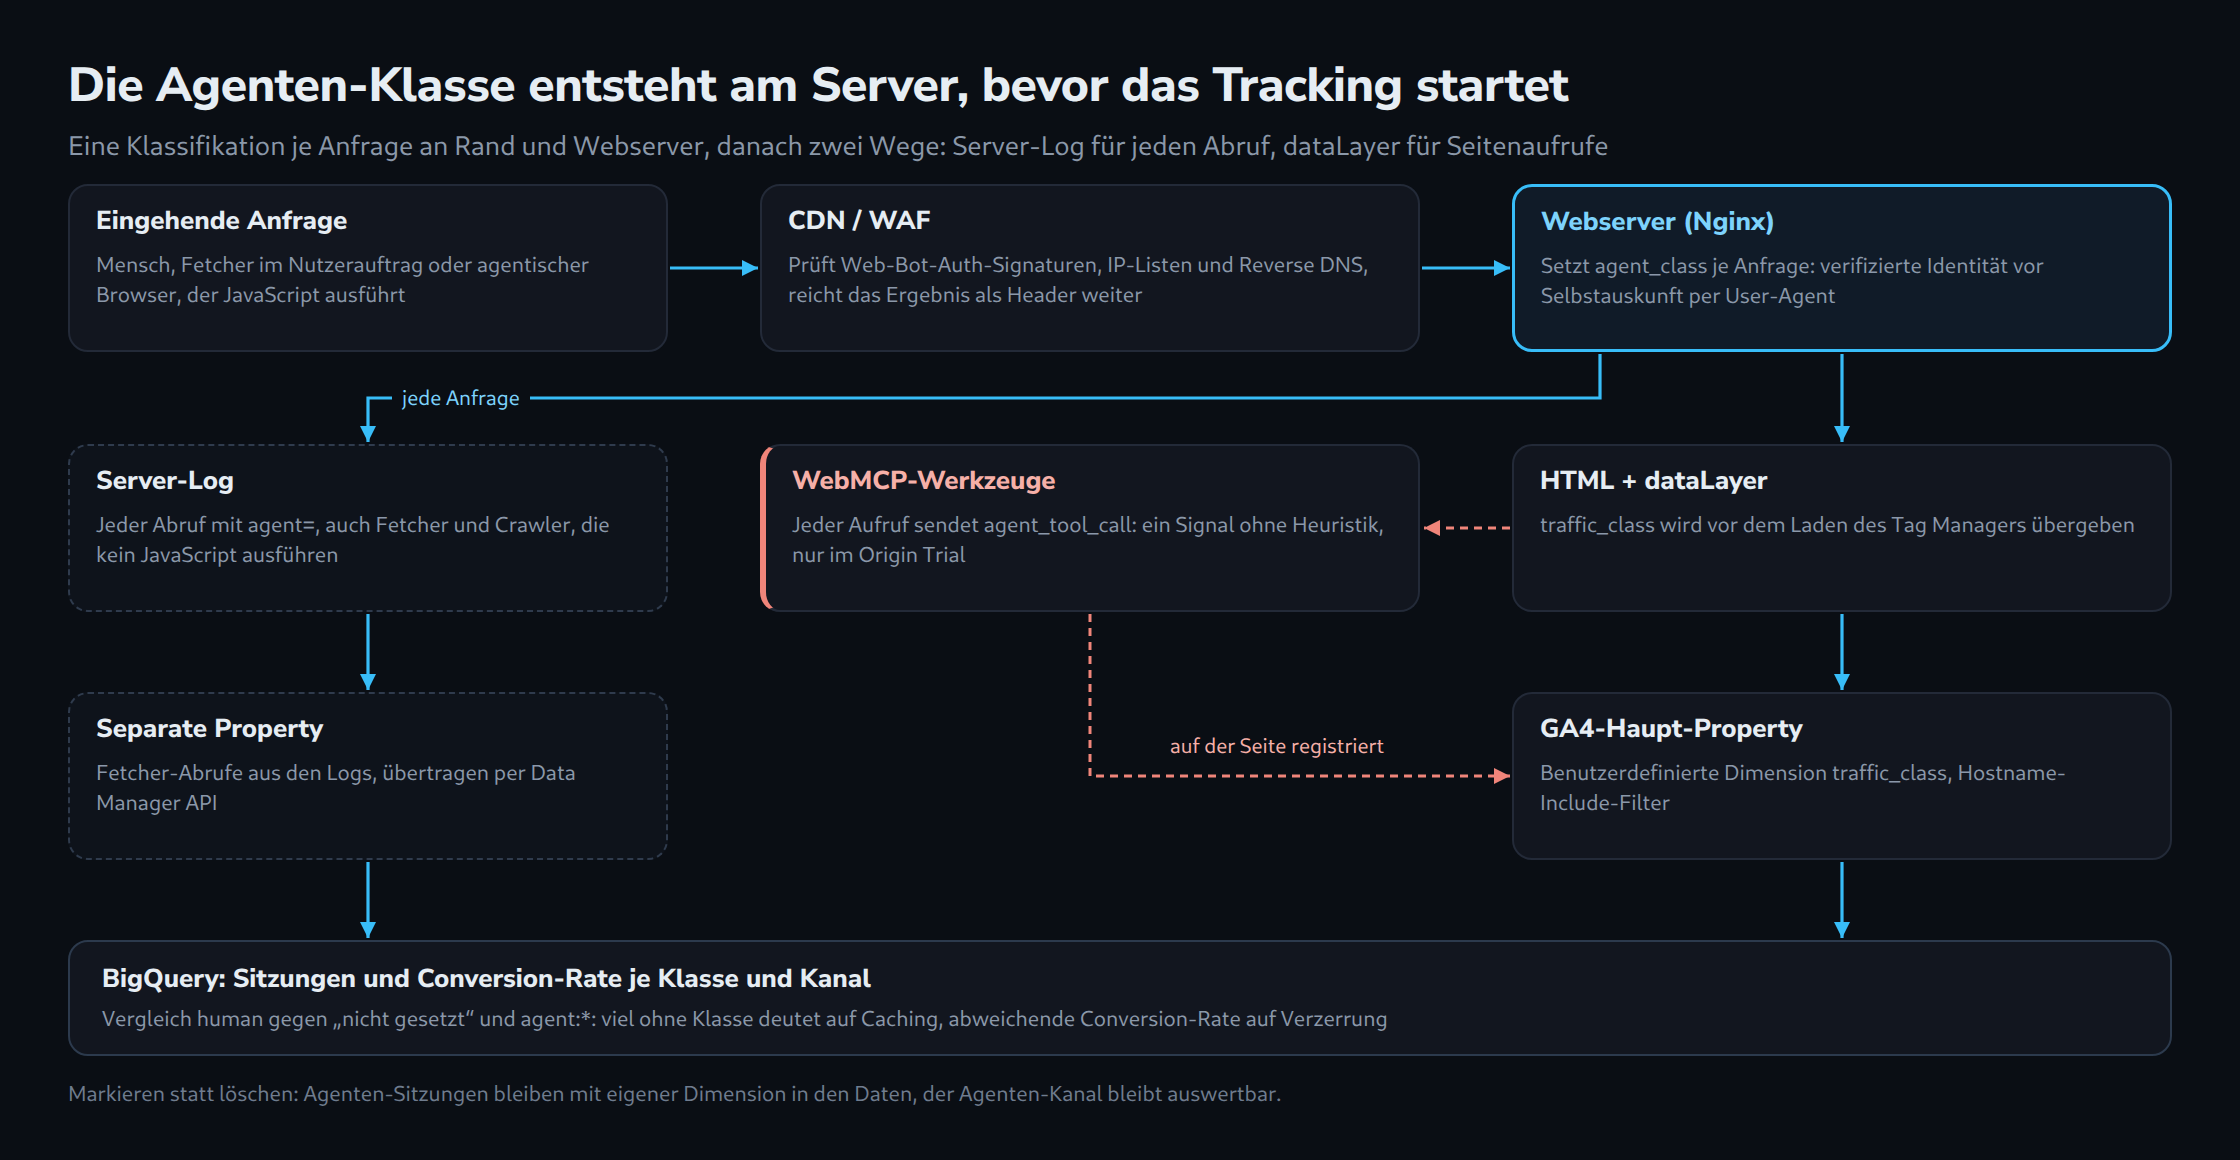
Der Server-Log erfasst alle Abrufe, auch solche ohne JavaScript. GA4 erhält nur Seitenaufrufe – dann aber mit Klasse und optional mit WebMCP-Events als eindeutigem Agenten-Signal.
Implementierung: von der Anfrage bis zur BigQuery-Auswertung
Die Umsetzung besteht aus vier Bausteinen: Klassifikation am Webserver, Logging, Übergabe an das Tracking und Auswertung. Die Beispiele nutzen Nginx, PHP, GA4 und BigQuery, das Prinzip lässt sich auf jeden Stack übertragen.
1. Klassifikation in Nginx
Zwei Quellen fließen zusammen: ein vom CDN gesetzter Header mit verifiziertem Ergebnis (hier X-Verified-Agent, etwa per Transform Rule) und eine einfache User-Agent-Erkennung als Fallback. Das verifizierte Ergebnis hat Vorrang.
# Fallback: Selbstauskunft per User-Agent (fälschbar, daher nur zweite Wahl)
map $http_user_agent $ua_agent_class {
    default                                          "";
    ~*Google-Agent                                   "agent:google";
    ~*ChatGPT-User                                   "fetcher:openai";
    ~*Claude-User                                    "fetcher:anthropic";
    ~*Perplexity-User                                "fetcher:perplexity";
    ~*(GPTBot|OAI-SearchBot|ClaudeBot|PerplexityBot) "crawler";
}

# Verifiziertes CDN-Ergebnis hat Vorrang vor dem User-Agent, sonst "human"
map "$http_x_verified_agent|$ua_agent_class" $agent_class {
    default                "human";
    "~^(?<v>[^|]+)\|"       "$v";
    "~^\|(?<u>.+)$"         "unverified:$u";
}

log_format analytics '$remote_addr [$time_local] "$request" $status '
                     '"$http_referer" "$http_user_agent" agent=$agent_class';

server {
    access_log /var/log/nginx/access.log analytics;

    location ~ \.php$ {
        fastcgi_param AGENT_CLASS $agent_class;
        # ... restliche FastCGI-Konfiguration
    }
}
Wichtig: Der Header X-Verified-Agent muss am Ursprung von Anfragen, die nicht über das CDN kommen, entfernt oder ignoriert werden. Sonst kann jeder Client sich selbst als verifiziert ausgeben.
2. Server-Logs als zweite Wahrheit
Fetcher und Crawler führen kein JavaScript aus und fehlen daher in GA4 vollständig. Das Log-Format oben macht sie sichtbar:
grep -o 'agent=[^ ]*' /var/log/nginx/access.log | sort | uniq -c | sort -rnDas Ergebnis zeigt, wie oft KI-Systeme Inhalte im Auftrag von Nutzern abrufen, ohne dass je eine Sitzung entsteht. Für Content-Seiten ist das oft die aufschlussreichste Zahl überhaupt.
3. Übergabe an den dataLayer
Die Klasse wird serverseitig in die Seite geschrieben und vor dem Laden des Tag Managers in den dataLayer übergeben:
<?php $trafficClass = $_SERVER['AGENT_CLASS'] ?? 'human'; ?>
<script>
  window.dataLayer = window.dataLayer || [];
  window.dataLayer.push({
    traffic_class: <?= json_encode($trafficClass) ?>
  });
</script>
Bei Full-Page-Caching würde die Klasse des ersten Besuchers für alle ausgeliefert. Saubere Alternativen: die Klasse per Edge-Logik in den HTML-Stream einsetzen, den Cache nach $agent_class variieren oder die Klasse erst im serverseitigen Tag Manager aus dem Request-Header lesen.
4. GA4-Konfiguration
traffic_classim Google-Tag als Event-Parameter mitsenden (in GTM als dataLayer-Variable).- In GA4 unter Verwaltung → Benutzerdefinierte Definitionen eine Dimension mit Bereich „Ereignis“ und Parameter
traffic_classanlegen. - Benutzerdefinierte Dimensionen wirken nicht rückwirkend. Je früher die Einrichtung, desto länger die Vergleichsbasis.
5. Auswertung in BigQuery
Die Abfrage berechnet Sitzungen und Conversion-Rate je Traffic-Klasse und Kanal. Projekt- und Dataset-Namen sind anzupassen.
WITH events AS (
  SELECT
    CONCAT(user_pseudo_id, '-', CAST(
      (SELECT value.int_value FROM UNNEST(event_params) WHERE key = 'ga_session_id') AS STRING
    )) AS session_key,
    (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'traffic_class') AS traffic_class,
    session_traffic_source_last_click.cross_channel_campaign.default_channel_group AS channel,
    event_name
  FROM `mein-projekt.analytics_123456789.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260901' AND '20260930'
),
sessions AS (
  SELECT
    session_key,
    COALESCE(MAX(traffic_class), 'nicht gesetzt') AS traffic_class,
    MAX(channel) AS channel,
    COUNTIF(event_name = 'purchase') > 0 AS converted
  FROM events
  GROUP BY session_key
)
SELECT
  traffic_class,
  channel,
  COUNT(*) AS sessions,
  ROUND(100 * COUNTIF(converted) / COUNT(*), 2) AS conversion_rate_pct
FROM sessions
GROUP BY traffic_class, channel
ORDER BY sessions DESC;
Aufschlussreich ist vor allem der Vergleich „human“ gegen „nicht gesetzt“: Ein großer Anteil ohne Klasse deutet auf Caching-Probleme oder blockierte Skripte hin, eine deutlich abweichende Conversion-Rate bei „agent:*“ bestätigt den Verzerrungseffekt.
WebMCP: Agenten-Interaktionen als saubere Events messen
WebMCP dreht das Messproblem um: Statt Agenten nachträglich zu erraten, bietet die Website ihnen definierte Funktionen an – und jeder Aufruf ist per Definition ein Agenten-Event. Die Website registriert dazu Werkzeuge mit Name, Beschreibung und JSON-Schema, die ein Agent im Browser direkt aufrufen kann.
Der Stand im Oktober 2026 laut mcpplaygroundonline und chudi.dev:
- W3C-Community-Group-Entwurf, noch nicht auf dem Standardisierungspfad
- öffentlicher Origin Trial in Chrome von Version 149 bis 156
- Die API ist von
navigator.modelContextnachdocument.modelContextumgezogen. Chrome 150 hat die alte Schreibweise als veraltet markiert, viele Tutorials zeigen noch die alte. - lokales Testen über
chrome://flags/#enable-webmcp-testing
Für Analytics ist WebMCP deshalb interessant, weil sich die Messung direkt im Handler verankern lässt:
const mc = document.modelContext ?? navigator.modelContext;

if (mc) {
  await mc.registerTool({
    name: 'search_products',
    description: 'Durchsucht den Produktkatalog nach Stichwort und optionaler Preisobergrenze.',
    inputSchema: {
      type: 'object',
      properties: {
        query: { type: 'string' },
        max_price: { type: 'number' }
      },
      required: ['query']
    },
    async execute({ query, max_price }) {
      window.dataLayer = window.dataLayer || [];
      window.dataLayer.push({
        event: 'agent_tool_call',
        tool_name: 'search_products',
        traffic_class: 'agent:webmcp'
      });

      const params = new URLSearchParams({ q: query });
      if (max_price) params.set('max', String(max_price));
      const data = await (await fetch('/api/search?' + params)).json();

      return { content: [{ type: 'text', text: JSON.stringify(data.items) }] };
    }
  });
}
Das Event agent_tool_call liefert ein Signal ohne Heuristik: welche Funktionen Agenten nutzen, wie oft und mit welchem Ergebnis im weiteren Verlauf der Sitzung. Eingabewerte gehören dabei nicht ungeprüft ins Tracking, da Agenten Suchbegriffe oder Formulardaten ihrer Nutzer weiterreichen können.
Solange WebMCP nur im Origin Trial läuft, ist es ein Zusatzsignal für frühe Erkenntnisse, kein Ersatz für die serverseitige Klassifikation. Da sich die API bereits einmal geändert hat, empfiehlt sich eine Kapselung in einer eigenen Hilfsfunktion.
Datenhygiene: Hostname-Allowlist und serverseitige Events
Zwei GA4-Neuerungen aus 2026 gehören in jedes Setup, das agentischen Traffic ernst nimmt: der Include-Filter für Hostnamen und die Data Manager API. Beide sind laut Google Release Notes bereits verfügbar.
Hostname-Include-Filter (seit 21. September 2026). Bisher ließen sich Hostnamen nur ausschließen, was bei jeder neuen Spam-Quelle Pflege erforderte. Jetzt lässt sich eine Allowlist der eigenen Domains definieren. Zwei Details sind entscheidend:
- Events ohne Hostnamen werden automatisch verworfen. Serverseitige Setups, die keinen Seitenkontext mitsenden, verlieren so unbemerkt Daten. Der Filter sollte daher zuerst im Status „Test“ laufen und erst nach Abgleich aktiviert werden.
- Events über das Measurement Protocol werden vom Filter nicht erfasst. Das
api_secretbleibt damit der einzige Schutz dieser Schnittstelle und gehört ausschließlich auf den Server.
Data Manager API (seit 7. Mai 2026). Die API ist eine Alternative zum Measurement Protocol für empfohlene und benutzerdefinierte Events direkt an Web- und App-Datenstreams. Für das Thema dieses Beitrags bietet sie einen sauberen Weg, Abrufe von Fetchern aus den Server-Logs als eigene Events zu übertragen – idealerweise in eine separate Property, damit menschliche Kennzahlen unberührt bleiben.
Das Ergebnis ist eine klare Trennung: Die Haupt-Property misst Menschen und markierte Agenten-Sitzungen, eine zweite Property oder ein BigQuery-Dataset bündelt reine Maschinenabrufe.
Checkliste für die nächsten 30 Tage
Die folgenden Schritte bauen aufeinander auf und lassen sich in einem Monat umsetzen.
- Kanal „AI Assistant“ und Dimension „Source Group“ in GA4 prüfen und als Vergleichssegment speichern
- Server-Logs um eine Agenten-Klasse erweitern und eine Woche Basisdaten sammeln
- Prüfen, ob CDN oder WAF verifizierte Bots und Web-Bot-Auth-Signaturen auswerten, und das Ergebnis als Header weiterreichen
traffic_classin dataLayer und Google-Tag aufnehmen, Caching-Verhalten testen- Benutzerdefinierte Dimension
traffic_classin GA4 registrieren - Hostname-Include-Filter im Status „Test“ anlegen, nach Abgleich aktivieren
- BigQuery-Abfrage einrichten und Conversion-Raten je Klasse vergleichen
- Für eine zentrale Funktion (Suche, Verfügbarkeit, Kontaktanfrage) ein WebMCP-Werkzeug im Origin Trial testen
Fazit
Die zentrale Kennzahl 2026 ist nicht mehr „Wie viel KI-Traffic gibt es?“, sondern „Welcher Anteil der Sitzungen stammt überhaupt von Menschen?“. Der neue AI-Assistant-Kanal beantwortet nur die erste Frage, und auch die nur für Klicks mit Referrer.
Agentische Browser führen Tracking aus, ohne sich als Agent zu erkennen zu geben. Belastbar wird die Trennung erst über serverseitige Klassifikation, idealerweise auf Basis verifizierter Identitäten aus Web Bot Auth, IP-Listen und CDN-Auswertung. Diese Klasse gehört als eigene Dimension ins Tracking, nicht als nachträglicher Filter.
WebMCP zeigt, wohin die Entwicklung geht: Websites, die Agenten bewusst Funktionen anbieten, bekommen im Gegenzug saubere Messpunkte. Bis das Standard ist, entscheidet die eigene Infrastruktur darüber, ob Analytics-Daten noch menschliches Verhalten abbilden.
Fragen und Antworten
Warum lassen sich agentische Sitzungen nicht nachträglich in GA4 herausfiltern?
Weil GA4 nur sieht, was das Tag sendet. Ein agentischer Browser liefert dieselben Daten wie ein gewöhnliches Chrome: denselben Browser, oft keinen oder einen beliebigen Referrer und normal ausgelöste Events. Die IAB-Bot-Liste, auf die sich die Bot-Filterung von GA4 stützt, erkennt solche Browser nicht.
Die Merkmale, die einen Agenten tatsächlich verraten, hängen an der einzelnen HTTP-Anfrage: die Signatur aus Web Bot Auth, die Herkunft aus einer veröffentlichten IP-Liste und der zweistufige Abgleich per Reverse DNS. Diese Prüfungen laufen am CDN oder am Webserver. Erst wenn das Prüfergebnis als traffic_class mit der Seite ausgeliefert wird, hat GA4 ein Merkmal, nach dem sich trennen lässt. Da benutzerdefinierte Dimensionen nicht rückwirkend wirken, gilt die Trennung zudem erst ab dem Tag der Einrichtung.
Warum trägt eine Klasse aus dem User-Agent in Nginx das Präfix „unverified:“?
Weil der User-Agent eine Selbstauskunft ist und sich beliebig fälschen lässt. Das Präfix hält in Logs und Berichten auseinander, welche Klassen ein CDN geprüft hat und welche nur behauptet sind. Auch ein echter Google-Agent kann unter unverified:agent:google erscheinen, wenn CDN oder WAF seine Anfrage nicht verifiziert haben, zumal Google-Agent bisher nur einen Teil seiner Anfragen signiert.
Was geschieht mit der Klasse, wenn ein Seitencache oder ein CDN die Seite ausliefert?
Ohne Vorkehrung erhalten alle Besucher die Klasse dessen, der die Seite zuerst abgerufen hat. Der PHP-Teil schreibt traffic_class fest ins HTML. Liegt diese Fassung im Cache, bekommt jeder spätere Aufruf denselben Wert, ob Mensch oder Agent.
Drei Wege halten die Klasse richtig:
- Cache nach Klasse variieren.
$agent_classwird Teil des Cache-Schlüssels. Da die Klasse nur wenige Werte annimmt, entstehen je Seite nur wenige Fassungen. - Klasse am Rand einsetzen. Edge-Logik schreibt den Wert erst beim Ausliefern in das gecachte HTML, der Cache selbst bleibt einheitlich.
- Klasse im serverseitigen Tag Manager lesen. Das HTML trägt dann keine Klasse, der Server-Container liest sie aus dem Header der eingehenden Messanfrage. Das setzt voraus, dass auch diese Anfrage über das klassifizierende CDN läuft.
Unabhängig davon ist das Server-Log nur vollständig, wenn die Anfragen den Webserver erreichen. Liefert ein vorgelagertes CDN eine Seite aus dem eigenen Cache aus, sieht Nginx diesen Abruf nicht. Dann gehören die Logs des CDN mit in die Auswertung.
Quellen
- Google Analytics: What’s new (Release Notes 2026)
- Google: Liste der nutzerausgelösten Fetcher (Google-Agent)
- HUMAN: 2026 State of AI Traffic & Cyberthreat Benchmark Report
- HUMAN: State of Agentic Traffic, August 2026
- HUMAN: Key Findings 2025
- Snowplow: Agentic Browsing Is Here
- Seer Interactive: The New Analytics Blind Spot
- TAGGRS: The impact of AI Browsers on user tracking
- Wikipedia: ChatGPT Atlas
- nohacks: The Agentic Browser Landscape in 2026
- PPC Land: Google-Agent joins the crawler list
- Contextbolt: Web Bot Auth
- IETF Draft: HTTP Message Signatures for automated traffic
- mcpplaygroundonline: WebMCP in 2026
- chudi.dev: What Is WebMCP?
Passend dazu