English
 Deutsch
 Polski
Welche AI-Modelle passen zu Deutsch, Englisch und Polnisch?

Inhalt
Ein Modell kann in Englisch überzeugend arbeiten und bei polnischer Flexion oder deutscher Fachterminologie deutlich mehr Korrekturen benötigen. Eine allgemeine Modellrangliste beantwortet deshalb keine dreisprachige Redaktionsfrage. Der Vergleich betrachtet die am 6. Oktober 2026 dokumentierten GPT-, Claude- und Gemini-Kandidaten neben DeepSeek V4.1 Flash und Qwen3.8-27B.
Mehrsprachig ist keine Qualitätsgarantie
OpenAI und Anthropic dokumentieren mehrsprachige Fähigkeiten. Daraus folgt keine belegte Rangfolge für Deutsch, Englisch und Polnisch. Auch ein offener Checkpoint mit guten allgemeinen Ergebnissen benötigt eigene Sprachprüfungen. Der ausgewählte Qwen- oder DeepSeek-Checkpoint, die Runtime und die Quantisierung bleiben Teil des Prüfgegenstands. [1, 3, 7, 8]
Die Aufgaben unterscheiden sich
| Sprache | Prüfmaterial | Abnahmekriterium |
|---|---|---|
| DE | Technische Erklärung und kurze FAQ | Terminologie, klare Bezüge, neutraler Stil |
| EN | Produktbeschreibung und Zusammenfassung | Präzision, idiomatische Sprache, keine Zusätze |
| PL | Fachtext und lokalisiertes UI | Flexion, Wortwahl und natürliche Satzstruktur |
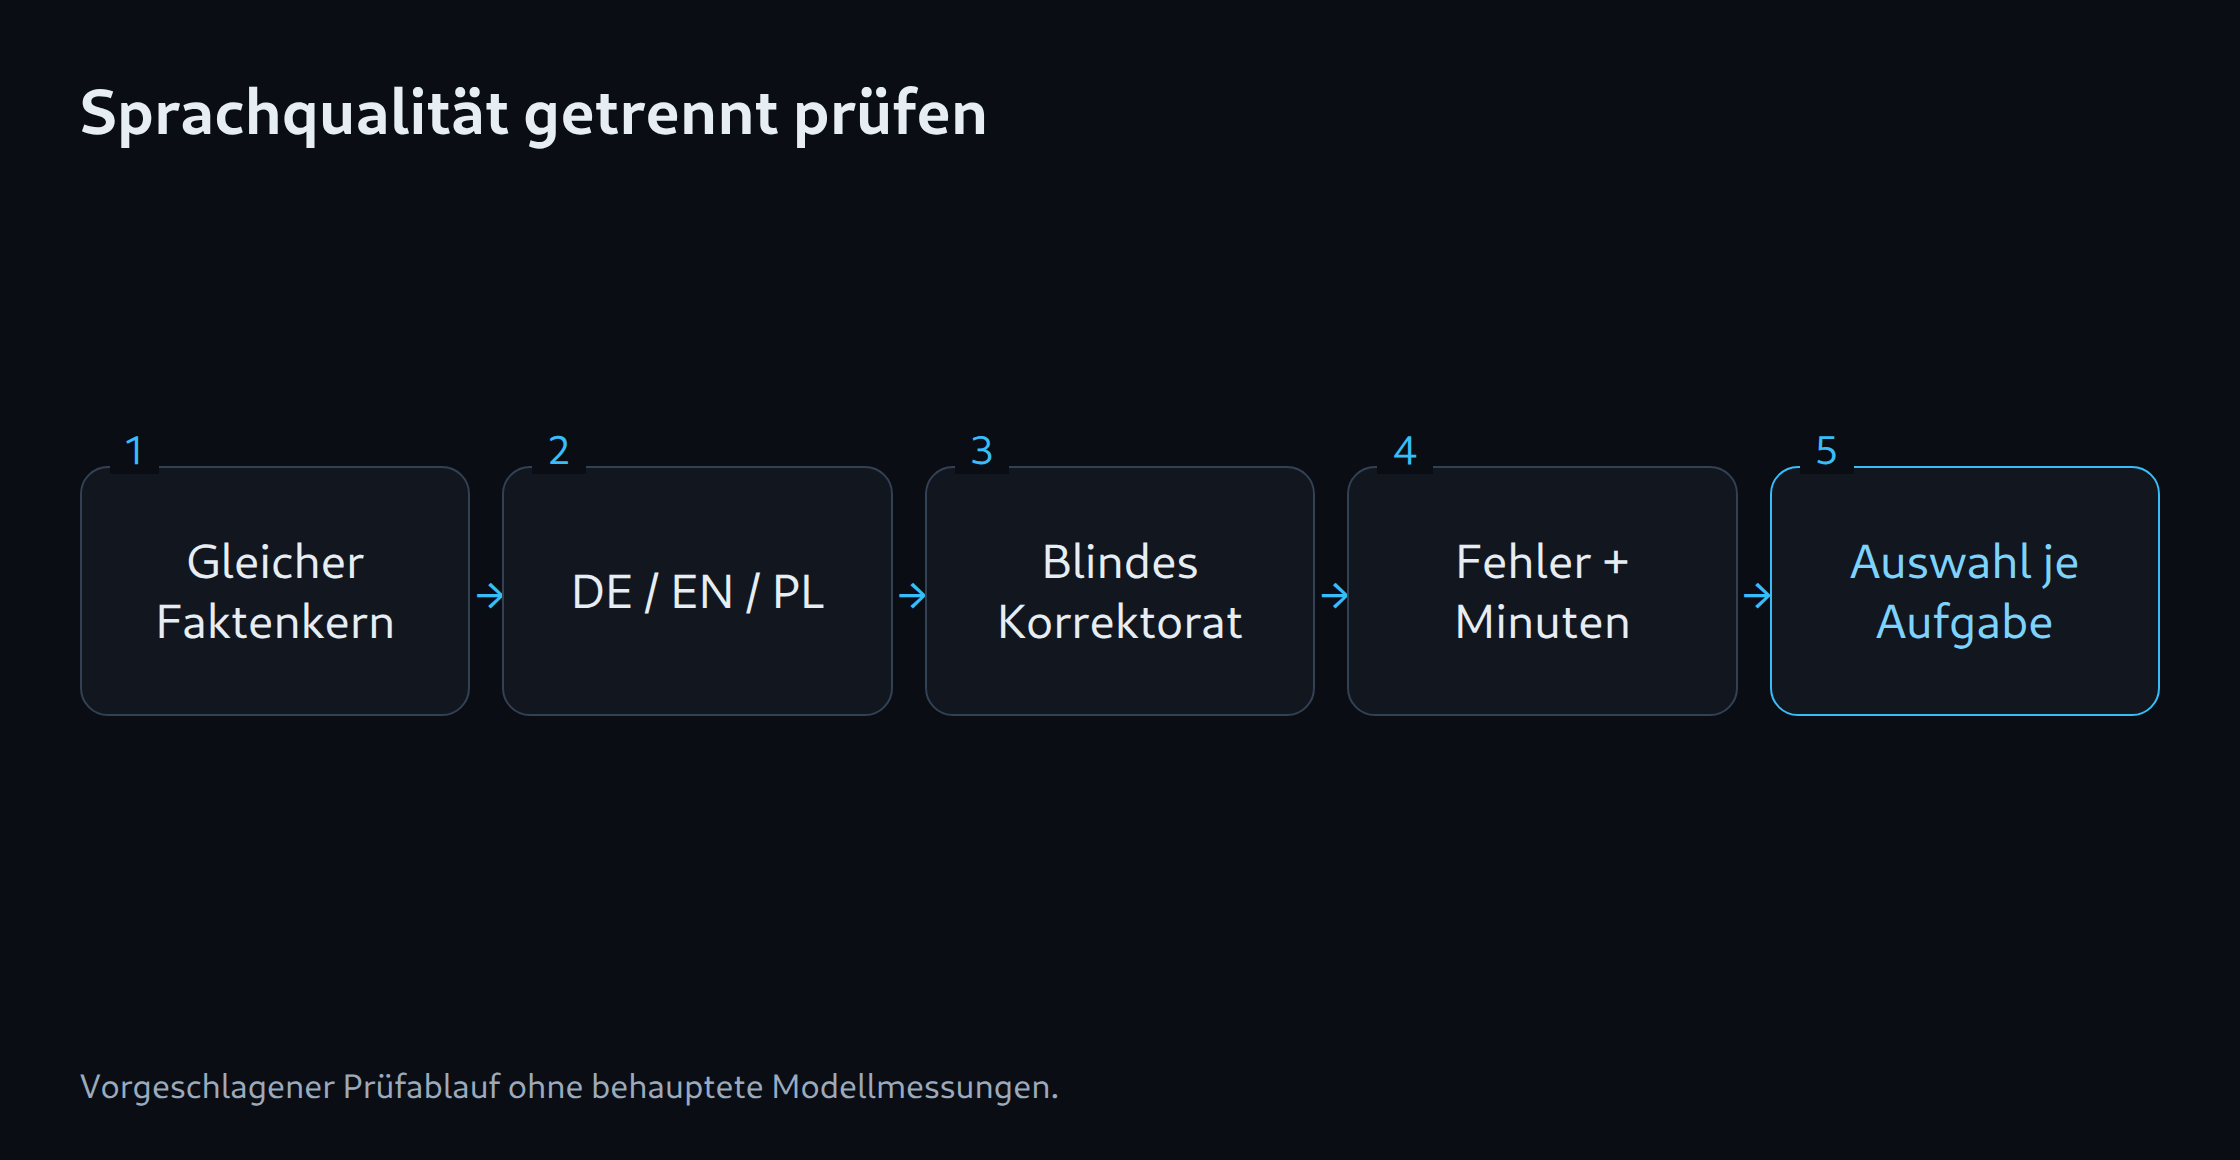
| DE / EN / PL | Gleicher Faktenkern | Identische Zahlen, Einschränkungen und Aussagen |
Ein Vergleich ohne englischen Vorsprung
Ein redaktioneller Test umfasst beispielsweise zwölf Aufgaben je Sprache. Die Zahl ist ein vorgeschlagener Testumfang, keine durchgeführte Messung. Jede Aufgabe besitzt eine Faktenliste, erlaubte Fachbegriffe und eine Zielgruppe. Ein Teil entsteht direkt in der Zielsprache; ein anderer Teil übersetzt denselben Ausgangstext. Dadurch lassen sich Sprachproduktion und Übersetzungsqualität getrennt bewerten.
Bewertet werden Bedeutungsfehler, fehlende Einschränkungen, Grammatik, Terminologie und unnötige Ergänzungen. Eine glatte Formulierung erhält keinen Bonus, wenn eine Zahl oder eine Unsicherheit verschwindet. Korrekturminuten sind zusätzlich hilfreich, weil ein brauchbarer Ausgangstext weniger redaktionellen Aufwand verursachen kann als eine glänzende, aber unzuverlässige Antwort.
Cloud und lokale Varianten fair vergleichen
GPT-6.1 Sol, Claude Sonnet 5.5 und Gemini 3.8 Flash bilden eine praktikable Cloud-Vorauswahl. Astra und Opus ergänzen schwierige Aufgaben. Auf der offenen Seite ist ein passender Qwen-Checkpoint ein Kandidat für lokale Redaktionsarbeit; DeepSeek ergänzt den Vergleich über eine geeignete API oder ausreichend ausgestattete Infrastruktur. Diese Zuordnung ist eine Einsatzhypothese und kein Sprachqualitätssieger.
Für lokale Tests werden Kontext, Chatvorlage und Quantisierung festgehalten. Ein Wechsel von Q8 auf Q4 erzeugt einen neuen Testzustand. Ollama ist dabei das Ausführungswerkzeug; die dokumentierten Speicher- und Laufzeitbedingungen sind von der Modellqualität zu trennen. [9]
Die Auswahl pro Aufgabe
Eine dreisprachige Redaktion muss kein einziges Modell für sämtliche Inhalte festlegen. Ein günstiger Kandidat kann kurze strukturierte Ausgaben übernehmen, während schwierige Texte einen zweiten Prüfschritt erhalten. Die Entscheidung stützt sich auf Fehler je Sprache und Korrekturaufwand. Unterschiede bleiben sichtbar, statt in einem Gesamtmittelwert zu verschwinden.
Passende Werkzeuge
Fragen und Antworten
Belegt ein englischer Benchmark polnische Sprachqualität?
Ein englischer Benchmark deckt andere Aufgaben und Sprachmerkmale ab. Polnische Flexion, Terminologie und Bedeutungsgenauigkeit benötigen eigene Prüfmaterialien.
Sollten alle drei Sprachen dasselbe Modell verwenden?
Ein gemeinsames Modell vereinfacht Abläufe. Unterschiedliche Modelle sind ebenfalls tragfähig, wenn Faktenabgleich, Terminologie und Qualitätsgrenzen einheitlich bleiben.
Quellen
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
Quellen geprüft: 6. Oktober 2026.
Passend dazu