

 English
 Deutsch
 Polski
Tutorial: Znajdowanie danych osobowych w ścieżkach stron GA4 i ich usuwanie

Management Summary
Adresy stron i wyszukiwane hasła mogą nieświadomie przekazywać dane osobowe do Google Analytics 4, na przykład gdy witryna umieszcza informacje identyfikujące w linkach. Tworzy to problem prywatności w statystykach odwiedzin. Poprawienie wysyłanych danych zatrzymuje dalsze zbieranie, lecz zapisane wcześniej informacje wymagają osobnego działania. Automatyczne usuwanie obejmuje tylko część przypadków, a eksporty potrzebują własnego oczyszczenia. Zapobieganie i kasowanie historii rozwiązują zatem różne części problemu.
Spis treści
- 1. Ustalenie wartości i dróg transmisji
- 2. Celowe odpytywanie dostępnych raportów
- 3. Wykrywanie wskazówek i ocena kontekstu
- 4. Zatrzymanie kolejnych transmisji u źródła
- 5. Historia GA4: rodzaje usuwania i wyjątki
- 6. Osobna obsługa BigQuery i pozostałych kopii
- 7. Porównanie żądań Collect bez ponownego wysyłania
- Pytania i odpowiedzi
- Źródła i dokumentacja techniczna
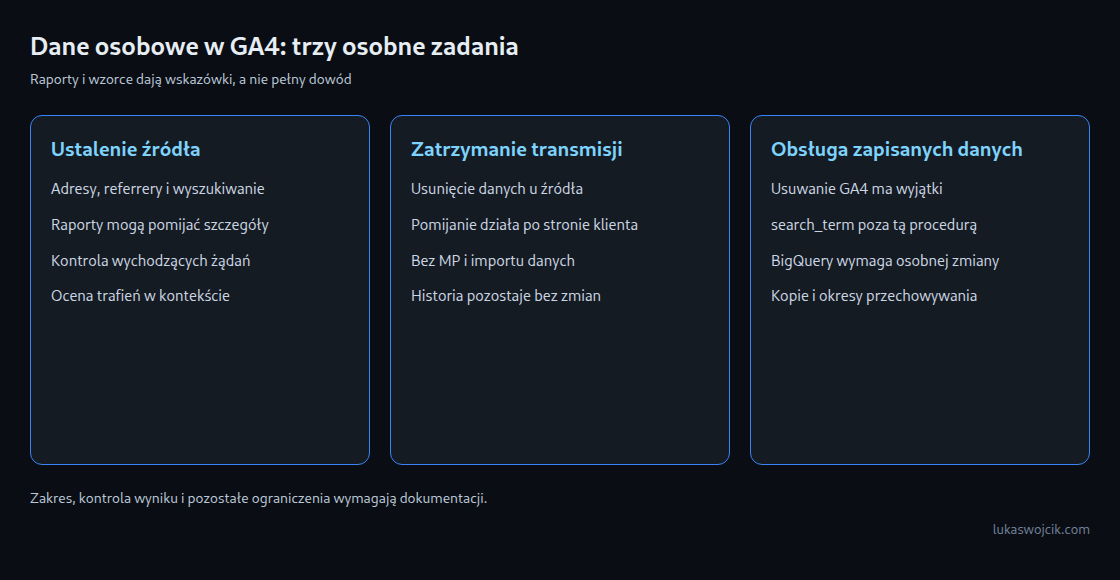
Adres e-mail w ścieżce URL, wyszukiwana fraza z numerem telefonu albo powiązany z osobą numer zamówienia mogą trafić do GA4 razem ze zdarzeniem. Takie ustalenie wymaga dwóch oddzielnych działań: zatrzymania kolejnych transmisji oraz obsługi zapisanych danych. Zmiana tagu nie oczyszcza historycznych raportów.
Poniższa procedura zaczyna się od inwentaryzacji, następnie ogranicza zbieranie danych i dopiero potem rozpatruje usuwanie. Pojedynczy raport ani wyrażenie regularne nie dowodzą braku danych osobowych.
1. Ustalenie wartości i dróg transmisji
Adresy e-mail i prywatne numery telefonów to oczywiste przykłady. Numer zamówienia lub token resetowania hasła również może wskazywać osobę po połączeniu z dostępnymi dodatkowymi informacjami. Token jest ponadto sekretem. Nazwanie wartości pseudonimową albo zastosowanie funkcji skrótu nie usuwa automatycznie powiązania z osobą. PII oznacza personally identifiable information, czyli informacje pozwalające identyfikować osobę. Zasady Google dotyczące PII i prawne pojęcie danych osobowych nie są identyczne.
Badanie obejmuje pełne adresy stron, ścieżki, parametry zapytania, referrery, tytuły stron, wyszukiwane frazy i niestandardowe parametry zdarzeń. Domyślne page_location w GA4 pomija fragment URL po #. JavaScript lub inna implementacja nadal może jawnie przesłać fragment. Fragment nie stanowi więc bezpiecznego miejsca przechowywania sekretów.
Rejestr ustaleń wymaga źródła, parametru, okresu, miejsc docelowych i oczyszczonego przykładu. Pełne tokeny ani adresy nie powinny trafiać do zgłoszeń, szeroko dostępnych arkuszy lub publicznych analizatorów. Ujawnione tokeny dostępu albo resetowania wymagają także unieważnienia; późniejsze usunięcie z raportów nie wystarcza.
2. Celowe odpytywanie dostępnych raportów
Data API udostępnia dane raportowe, a nie kompletny zbiór surowych danych. pageLocation zawiera adres strony z hostem i zapytaniem, a pagePathPlusQueryString ścieżkę z zapytaniem. Samo pagePath pomija parametry zapytania. Oddzielne zapytania z pageReferrer i searchTerm obejmują inne możliwe miejsca występowania danych. Wysłanie niestandardowego parametru nie tworzy automatycznie wymiaru niestandardowego dostępnego w raportach.
Przykład stanowi treść JSON uwierzytelnionego żądania POST do https://analyticsdata.googleapis.com/v1beta/properties/PROPERTY_ID:runReport. Potrzebne są numeryczny identyfikator usługi, dostęp do odczytu oraz odpowiedni zakres OAuth, na przykład analytics.readonly. Stały okres jest przykładowy i wymaga dopasowania do badanego incydentu.
{
  "dateRanges": [
    {
      "startDate": "2026-10-01",
      "endDate": "2026-10-07"
    }
  ],
  "dimensions": [
    {
      "name": "pageLocation"
    }
  ],
  "metrics": [
    {
      "name": "eventCount"
    }
  ],
  "orderBys": [
    {
      "dimension": {
        "dimensionName": "pageLocation",
        "orderType": "ALPHANUMERIC"
      }
    }
  ],
  "limit": "10000",
  "offset": "0",
  "returnPropertyQuota": true
}
eventCount liczy zdarzenia; odsłony nie byłyby odpowiednią metryką dla osobnego zapytania o wyszukiwane frazy. Kolejne strony wyników powstają przez ustawienie offset na liczbę już odczytanych wierszy aż do osiągnięcia zgłoszonego rowCount. Sortowanie alfabetyczne i stały okres ułatwiają stronicowanie, ale spóźnione dane nadal mogą zmienić wyniki. API dopuszcza najwyżej 250 000 wierszy na żądanie; limity wykorzystania nadal obowiązują.
Kontrola odpowiedzi obejmuje dataLossFromOtherRow, samplingMetadatas, dataTruncationReasons i subjectToThresholding. Ostatnia flaga oznacza stosowanie progów, niekoniecznie rzeczywiste pominięcie wierszy. Pobranie kolejnych stron nie odtwarza wartości połączonych w „(other)”, uciętych danych ani niedostępnej historii. Nawet brak ostrzeżeń w metadanych nie stanowi pełnego dowodu zgodności przetwarzania.
3. Wykrywanie wskazówek i ocena kontekstu
Kodowanie procentowe zapisuje znaki URL jako kody; na przykład %40 oznacza @. Dekodowanie zamienia te kody z powrotem na znaki. Przykład w Pythonie sprawdza tekst pierwotny i maksymalnie dwie dodatkowe rundy dekodowania procentowego. Analiza zapytania uwzględnia powtórzone i puste parametry oraz zakodowane nazwy kluczy. Sprawdzenie fragmentu opisuje wyłącznie tekst wejściowy, bez potwierdzenia rzeczywistego przesłania do GA4.
import re
from urllib.parse import parse_qsl, unquote, urlsplit

EMAIL = re.compile(r"[A-Z0-9.!#$%&'*+/=?^_`{|}~-]+@[A-Z0-9-]+(?:\.[A-Z0-9-]+)+", re.I)
FIELDS = {
    "secret_field": {"token", "hash", "auth", "key", "sig", "pwd", "password"},
    "name_field": {"name", "vorname", "nachname", "firstname", "lastname", "user"},
    "phone_field": {"phone", "tel", "mobile", "telephone"},
    "search_field": {"q", "s", "search", "query"},
}


def scan_url(text):
    if not isinstance(text, str):
        raise TypeError("text must be a string")
    if len(text) > 16384:
        return {"input_too_long"}
    flags = set()
    if re.search(r"%(?![0-9a-fA-F]{2})", text):
        flags.add("invalid_percent_encoding")
    forms = [text]
    for _ in range(2):
        decoded = unquote(forms[-1])
        if decoded == forms[-1]:
            break
        forms.append(decoded)
    if unquote(forms[-1]) != forms[-1]:
        flags.add("further_encoding")
    for form in forms:
        if EMAIL.search(form):
            flags.add("email_like")
        try:
            parts = urlsplit(form)
            if parts.username is not None or parts.password is not None:
                flags.add("url_credentials")
            # Fragment query syntax is inspected too, without claiming collection.
            queries = [parts.query, parts.fragment.partition("?")[2] or parts.fragment]
            for query in queries:
                for key, value in parse_qsl(query, keep_blank_values=True, max_num_fields=1000):
                    for label, names in FIELDS.items():
                        if key.casefold() in names:
                            flags.add(label)
                    if EMAIL.search(value):
                        flags.add("email_like")
        except ValueError:
            flags.add("url_parse_error")
    return flags
Funkcja zwraca kategorie zamiast surowych wartości. email_like oznacza wzorzec podobny do adresu e-mail, a secret_field podejrzaną nazwę klucza. phone_field nie potwierdza poprawnego numeru telefonu ani związku z osobą. Wyszukiwanie produktu lub name=product również może wywołać wskazówkę do sprawdzenia. Liczba 20260920 nie jest automatycznie klasyfikowana jako numer telefonu.
Ograniczenia obejmują nieznane nazwy parametrów, numery identyfikujące osoby w ścieżkach, szczególne przypadki Unicode, głębsze kodowanie i zaszyfrowaną treść. Odkodowane separatory mogą powodować dodatkowe fałszywe alarmy. input_too_long, url_parse_error i further_encoding wymagają osobnego badania. Pusty wynik oznacza wyłącznie brak rozpoznania przez te ograniczone reguły. Próbki pomagają ocenić kontekst, ale nie zastępują kontroli wszystkich istotnych źródeł.
4. Zatrzymanie kolejnych transmisji u źródła
URL bez wrażliwych wartości chroni szerzej niż późniejsze poprawienie pola analitycznego. Gdy formularz wymaga danych osobowych, POST zapobiega typowemu umieszczeniu pól formularza w zapytaniu URL. POST nie wyklucza jednak śledzenia formularza, logowania treści żądania, problematycznych przekierowań ani późniejszego adresu z tymi samymi wartościami.
Odpowiednia implementacja zbiera dozwolone pola o określonym celu i oczyszcza adres strony, referrer, tytuł oraz swobodny tekst przed wysłaniem. Tagowanie po stronie serwera może dodać kontrolę przed przekazaniem danych dalej. Żądania przeglądarki już wysłane do innych odbiorców oraz bezpośrednie drogi omijające kontener serwerowy pozostają poza taką kontrolą.
Pomijanie danych strumienia WWW w GA4 stanowi dodatkową warstwę. Rozpoznawanie e-maili działa na zasadzie najlepszej możliwej próby; wartości wskazanych kluczy zapytania są zastępowane znacznikiem w udokumentowanych parametrach URL, między innymi page_location i page_referrer. Przetwarzanie odbywa się po stronie klienta. Funkcja nie obejmuje Measurement Protocol, importu danych ani nagłówków HTTP. Ustawienie nie oczyszcza wartości historycznych.
Kontrolowane testy wykorzystują wyłącznie fikcyjne wartości, na przykład test@example.invalid. Rozstrzygające jest wychodzące żądanie po zastosowaniu wszystkich reguł tagów: pierwsze otwarcie, nawigacja, wyszukiwanie wewnętrzne, zakończenie formularza i każda droga transmisji. Poprawny podgląd nie dowodzi jeszcze poprawnego przesyłania w działającej witrynie.
5. Historia GA4: rodzaje usuwania i wyjątki
Administracja udostępnia prośby o usunięcie danych dla obsługiwanych parametrów i okresów. Daty odpowiadają strefie czasowej usługi. Dla parametrów zbieranych automatycznie dokumentacja wymaga szerokiego typu „Usuń wszystkie parametry ze wszystkich zdarzeń”; pozornie precyzyjny wybór samego page_location nie stanowi ogólnego zamiennika. Dodatkowa rejestracja wymiaru niestandardowego nie omija ograniczenia.
Istotna granica: Google wymienia search_term wprost na liście parametrów, których ten mechanizm nie usuwa. Obowiązują również inne udokumentowane wyjątki. Incydent z wyszukiwanymi frazami nie jest rozwiązany tylko dlatego, że zakończyła się prośba dotycząca innych parametrów. Konkretny przypadek wymaga odpowiedniego dodatkowego rozwiązania, w razie potrzeby z udziałem pomocy Google.
Mechanizm dotyczy wartości tekstowych, a nie liczbowych wartości parametrów, i zachowuje liczbę zdarzeń. Obsługiwane wartości otrzymują oznaczenie usunięcia; szeroki typ może objąć także nazwę zdarzenia. Usuwanie powiązane z User-ID ma osobną ścieżkę. Usunięcie parametrów nie oznacza zatem usunięcia całych zdarzeń ani wszystkich danych osobowych objętych danym przypadkiem.
Prośbę można anulować przez siedem dni. Całe przetwarzanie może trwać od siedmiu do 63 dni, a dane muszą być starsze niż dwanaście dni. Opcjonalny filtr zawierania porównuje tekst bez rozróżniania wielkości liter. Podgląd i tymczasowe wyłączenie z raportów nie potwierdzają zakończenia usuwania. Zakres, status oraz skutki dla raportów wymagają dokumentacji.
6. Osobna obsługa BigQuery i pozostałych kopii
Prośba o usunięcie danych z GA4 nie zastępuje oczyszczenia wcześniejszych eksportów. Poniższa inwentaryzacja liczy wystąpienia parametrów i typy wartości w jednej konkretnej tabeli bez ujawniania wartości. Projekt, zbiór danych, data i klucze wymagają dopasowania do rzeczywistych ustaleń.
-- Review one closed daily table; no modification is performed.
DECLARE target_keys ARRAY<STRING> DEFAULT
  ['page_location', 'page_referrer', 'search_term'];

SELECT
  p.key,
  COUNT(*) AS parameter_occurrences,
  COUNTIF(p.value.string_value IS NOT NULL) AS text_values,
  COUNTIF(p.value.int_value IS NOT NULL
       OR p.value.float_value IS NOT NULL
       OR p.value.double_value IS NOT NULL) AS numeric_values
FROM `project_id.analytics_123456789.events_20261001`,
UNNEST(event_params) AS p
WHERE p.key IN UNNEST(target_keys)
GROUP BY p.key
ORDER BY p.key;
Jeżeli pełne usunięcie tych trzech parametrów jest uzasadnione, następny przykład przedstawia ograniczony sposób wykonania. Przy apply_change = FALSE wykonywane jest tylko zliczenie objętych zdarzeń. Przełączenie na TRUE usuwa wszystkie wpisy wybranych kluczy z tej tabeli, również nieszkodliwe wartości. To destrukcyjna zmiana bieżącej tabeli, a nie precyzyjne maskowanie poszczególnych adresów e-mail.
-- Example for a confirmed full removal of selected parameter values.
-- Project, dataset, table and key list require case-specific review.
DECLARE apply_change BOOL DEFAULT FALSE;
DECLARE target_keys ARRAY<STRING> DEFAULT
  ['page_location', 'page_referrer', 'search_term'];

SELECT COUNT(*) AS affected_events
FROM `project_id.analytics_123456789.events_20261001`
WHERE EXISTS (
  SELECT 1 FROM UNNEST(event_params) AS p
  WHERE p.key IN UNNEST(target_keys)
);

IF apply_change THEN
  UPDATE `project_id.analytics_123456789.events_20261001`
  SET event_params = ARRAY(
    SELECT AS STRUCT p.*
    FROM UNNEST(event_params) AS p WITH OFFSET AS position
    WHERE p.key IS NULL OR p.key NOT IN UNNEST(target_keys)
    ORDER BY position
  )
  WHERE EXISTS (
    SELECT 1 FROM UNNEST(event_params) AS p
    WHERE p.key IN UNNEST(target_keys)
  );
END IF;
Pozostałe parametry, także ewentualne klucze NULL, zachowują wartości i kolejność. Lista kluczy docelowych nie może zawierać NULL. Inne tabele, user_properties, identyfikatory użytkowników, pozostałe pola zdarzeń i dalsze eksporty pozostają bez zmian. Przed zmianą odizolowana tabela testowa powinna potwierdzić cel, uprawnienia, oczekiwaną liczbę oraz skutki; po zmianie następuje ponowna inwentaryzacja. Aktywne lub spóźnione eksporty mogą ponownie dopisać dane i wymagają osobnej kontroli.
BigQuery zachowuje wcześniejsze wersje przez Time Travel: domyślnie siedem dni, z możliwością ustawienia od dwóch do siedmiu dni. Następnie obowiązuje siedmiodniowy okres fail-safe. Bezpośrednie odpytywanie tych danych nie jest dostępne; odtworzenie wymaga udokumentowanej procedury wsparcia. Migawki, kopie, pobrane pliki i inne systemy mają oddzielne cykle życia. Pusty wynik bieżącego zapytania nie dowodzi natychmiastowego fizycznego usunięcia wszystkich kopii.
7. Porównanie żądań Collect bez ponownego wysyłania
GA4 Parameter Analyser rozdziela pełne adresy Collect lub wiersze żądań zakodowane jak zapytanie URL. Wspólne parametry adresu POST można umieścić w osobnym polu. Kilka wierszy umożliwia porównanie nazw zdarzeń, identyfikatorów pomiaru, powtórzonych kluczy oraz brakujących i pustych wartości.
Funkcja analizy wykonuje jedno dekodowanie procentowe, zastępuje plusy zgodnie z kodowaniem formularzy i wyświetla wyniki jako tekst. Funkcja nie wysyła ponownie wklejonych żądań. JSON Measurement Protocol jest innym formatem; złożone wartości produktów są rozdzielane tylko heurystycznie. Eksport CSV nie stanowi anonimizacji. Do badania nadal odpowiednie są przykłady oczyszczone lub całkowicie fikcyjne; widok parametrów nie potwierdza odbioru przez GA4 ani pełnej kontroli PII.
Pytania i odpowiedzi
Czy wystarcza usunięcie jednego parametru zapytania?
Wyłącznie dla tego konkretnego miejsca. Ścieżki, referrery, tytuły, wyszukiwanie, inne parametry i dalsze drogi transmisji mogą zawierać tę samą wartość. Zmiana dotyczy ponadto tylko przyszłych transmisji.
Czy Referrer-Policy zapobiega każdemu ujawnieniu?
Przy strict-origin-when-cross-origin żądania w tej samej origin nadal mogą zawierać URL jako referrer. Przy zmianie origin zwykle przekazywana jest tylko origin, a przy przejściu z HTTPS na HTTP referrer jest pomijany. Origin oznacza protokół, host i port, a nie po prostu tę samą witrynę. Inne polityki i jawnie ustawiane parametry analityczne wymagają osobnej kontroli.
Czy zamaskowany adres jest automatycznie anonimowy?
Maskowanie może ograniczyć ilość informacji. Pozostałe identyfikatory, dodatkowe informacje i kontekst przetwarzania nadal określają możliwość identyfikacji. Zastąpienie wartości zapytania nie dowodzi ogólnej anonimowości.
Kiedy techniczna obsługa incydentu jest zakończona?
Po ustaleniu źródeł, kontroli przyszłych transmisji, zakończeniu dostępnych sposobów usuwania oraz udokumentowaniu pozostałych kopii i ograniczeń technicznych. Brak dopasowań wyrażenia regularnego albo jeden oczyszczony raport nie wystarczają do potwierdzenia tych warunków.
Źródła i dokumentacja techniczna
- GA4: usuwanie danych przed wysłaniem
- GA4: prośby o usunięcie danych
- Data API: runReport
- Data API: ResponseMetaData
- Data API: wymiary i wskaźniki
- GA4: odsłony
- BigQuery: Time Travel
- RODO: artykuł 4
- TSUE: C-604/22
- Google Analytics: PII
- Python: urllib.parse
- BigQuery: DML
- Chrome: Referrer-Policy
- GA4 Parameter Analyser: JavaScript
- GA4: zbieranie danych
- GA4: DebugView
- WHATWG: kodowanie URL danych formularzy
Powiązane artykuły


