

 English
 Deutsch
 Polski
Tutorial: Ustalenie konwencji nazw GTM i wprowadzenie jej w istniejącym kontenerze

Management Summary
Konwencja nazw nadaje elementom Google Tag Managera spójne, zrozumiałe oznaczenia. W rozbudowanym pomiarze ułatwia rozpoznanie zadania każdego elementu oraz pracę zespołu przy utrzymaniu i przeglądzie. Zmiana nazw w istniejących ustawieniach nie jest jednak tylko porządkiem językowym: inne elementy mogą odwoływać się do tych nazw i zmienić działanie. Zapisane powiązanie starych i nowych określeń zachowuje kontekst oraz pomaga przeprowadzić zmianę bez utraty znaczenia dotychczasowej konfiguracji.
Spis treści
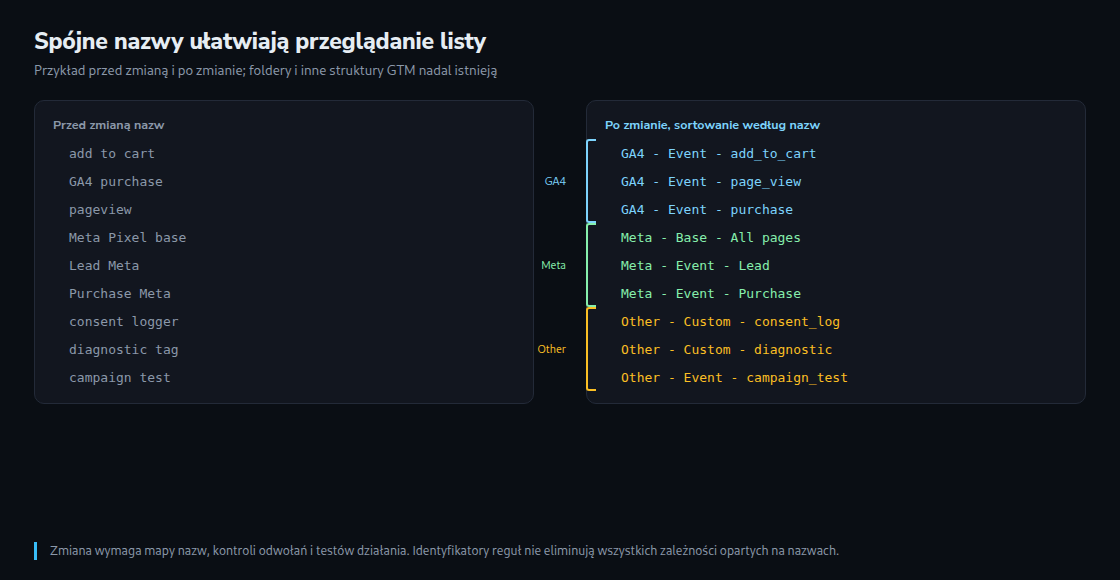
Spójna konwencja nazw ułatwia przeglądanie, wyszukiwanie i kontrolę dużego kontenera Google Tag Manager. Nazwy uzupełniają foldery, typy elementów i interfejs obszaru roboczego. Pierwsze słowo nie jest jedynym sposobem porządkowania kontenera. Dobra migracja wyjaśnia cel elementów i zachowuje dotychczasowe działanie pomiaru.
Mały, jednoznaczny schemat
Jeden z możliwych schematów przewiduje trzy człony dla tagów oraz dwa dla reguł i zmiennych zdefiniowanych przez użytkownika. To decyzja projektu, a nie wymaganie GTM. Poniższy przykład stosuje wspólne angielskie przedrostki we wszystkich wersjach językowych, aby jeden skrypt pasował do wszystkich przykładów.
GA4 - Event - add_to_cart
Meta - Event - purchase
Ads - Linker - All pages

CE - add_to_cart
PV - checkout
Click - header_cta

DLV - ecommerce.items
JS - item_list
Const - GA4 measurement ID
LT - country_code
CE oznacza tutaj Custom Event (zdarzenie niestandardowe), PV — Page View (odsłona strony), DLV — Data Layer Variable (zmienna warstwy danych), a LT — Lookup Table (tabela przypisania wartości). JS oznacza w tej konwencji niestandardową zmienną JavaScript. Znaczenie skrótów wymaga dokumentacji; GTM nie ustala na tej podstawie typu elementu.
Jednolity separator to - . Przy sortowaniu alfabetycznym nazwy ze wspólnym przedrostkiem znajdują się obok siebie. Mieszane separatory zmniejszają spójność, ale nie niszczą sortowania. Ostatni człon powinien zachowywać istotny identyfikator techniczny, na przykład add_to_cart. Zmienna niezwiązana z tym zdarzeniem nie musi zawierać takiej nazwy.
Platforma na początku pasuje do pracy organizowanej według systemu docelowego. Przy wielu witrynach ważniejsza może być nazwa witryny; skrypt wymaga wtedy odpowiednich reguł. Nazwa wyświetlana nie wybiera szablonu tagu ani wysyłanego zdarzenia. Dawna nazwa „GA4 Config” nie jest zatem wiarygodnym określeniem aktualnego typu szablonu. Zmiany interfejsu Google z 2026 r. również przemawiają przeciwko stałym założeniom o układzie menu.
Kontrola dokładniejsza niż sprawdzenie przedrostka
Pełny eksport wybranego obszaru roboczego stanowi punkt odniesienia. Eksport częściowy może pomijać zależności i nie potwierdza pełnego stanu kontenera. ContainerVersion zawiera więcej niż trzy tablice; ten skrypt celowo sprawdza wyłącznie tagi, reguły i zmienne zdefiniowane przez użytkownika.
Poniższy przykład dla Pythona 3 zapisuje się jako naming-audit.py. Dozwolony przedrostek nie wystarcza: nazwa GA4 - nie przechodzi kontroli z powodu brakujących członów. Skrypt odczytuje eksport z interfejsu zawierający containerVersion albo bezpośrednią odpowiedź API typu ContainerVersion. Błędy wejścia zwracają kod 2, niezgodne nazwy — kod 1, a zakończona kontrola nazw bez zastrzeżeń — kod 0.
import json
import re
import sys
from pathlib import Path

# Project convention, not a Google requirement.
PREFIXES = {
    "tag": {"GA4", "Google", "Meta", "Ads", "LinkedIn", "TikTok", "Other"},
    "trigger": {"CE", "PV", "Click", "Form", "Timer", "Visible", "Other"},
    "variable": {"DLV", "JS", "Const", "LT", "URL", "Cookie", "Other"},
}
SEGMENTS = {"tag": 3, "trigger": 2, "variable": 2}
REF = re.compile(r"\{\{([^{}]+)\}\}")


def audit(document):
    if not isinstance(document, dict):
        raise ValueError("Expected a JSON object")
    version = document.get("containerVersion", document)
    if not isinstance(version, dict) or not version.get("containerId"):
        raise ValueError("Expected a container version with containerId")
    report = {"counts": {}, "violations": [], "references": []}
    for kind, allowed in PREFIXES.items():
        entities = version.get(kind, [])
        if not isinstance(entities, list):
            raise ValueError(f"{kind}: expected an array")
        report["counts"][kind] = len(entities)
        for index, entity in enumerate(entities):
            if not isinstance(entity, dict):
                raise ValueError(f"{kind}[{index}]: expected an object")
            name = entity.get("name")
            parts = name.split(" - ") if isinstance(name, str) else []
            valid = (len(parts) == SEGMENTS[kind]
                     and parts[0] in allowed
                     and all(part and part == part.strip()
                             and not any(ord(c) < 32 for c in part)
                             for part in parts))
            if not valid:
                report["violations"].append({
                    "kind": kind, "id": entity.get(kind + "Id"),
                    "index": index, "name": name,
                })

    def walk(value, path):
        if isinstance(value, dict):
            for key, child in value.items():
                walk(child, path + [key])
        elif isinstance(value, list):
            for index, child in enumerate(value):
                walk(child, path + [index])
        elif isinstance(value, str):
            for match in REF.finditer(value):
                report["references"].append({
                    "path": path, "kind": "braces", "name": match.group(1)
                })
            if path and path[-1] == "tagName":
                report["references"].append({
                    "path": path, "kind": "tagName", "name": value
                })
    walk(version, [])
    return report


def main():
    if len(sys.argv) != 2:
        print("Usage: python3 naming-audit.py export.json", file=sys.stderr)
        return 2
    try:
        document = json.loads(Path(sys.argv[1]).read_text(encoding="utf-8-sig"))
        report = audit(document)
    except (OSError, UnicodeError, ValueError) as exc:
        print(f"Input error: {exc}", file=sys.stderr)
        return 2
    print(json.dumps(report, ensure_ascii=False, indent=2))
    return 1 if report["violations"] else 0


if __name__ == "__main__":
sys.exit(main())python3 naming-audit.py export.json > naming-report.jsonRaport JSON zawiera wszystkie niezgodne nazwy i potencjalne odwołania wraz ze ścieżką do pola. Dekodowanie JSON przed wyszukiwaniem pozwala znaleźć również klamry zapisane sekwencjami ucieczki. Nie ma ograniczenia do pierwszych 30 wyników. Skan obejmuje ciągi {{...}} i pola tagName; dosłowne klamry, notatki i nazwy składane dynamicznie nadal wymagają interpretacji. To nie jest parser GTM ani dowód poprawności wszystkich zależności.
Kontrola nazw nie rozstrzyga też, czy element „DLV” rzeczywiście jest zmienną warstwy danych, czy tag pozostaje potrzebny ani czy kampania działa. Takie pytania należą do przeglądu merytorycznego. Stara data, nieznana nazwa lub wstrzymany tag to sygnał do sprawdzenia, a nie automatyczna decyzja o usunięciu.
Odwołania wymagają osobnej kontroli
Przypisania reguł korzystają z pól takich jak firingTriggerId i blockingTriggerId. Nie oznacza to, że każda zmiana nazwy tagu pozostaje bez konsekwencji. Odwołania sekwencji pod setupTag[].tagName i teardownTag[].tagName również wymagają kontroli w rzeczywistym eksporcie; sama nazwa pola nie zastępuje sprawdzenia wskazanego celu. Nazwy wyświetlane tagów mogą ponadto trafiać do metadanych monitorowania.
Odwołania do zmiennych zawierają nazwy w podwójnych klamrach, także w niestandardowym HTML i JavaScript. Nie należy zakładać, że zmiana w interfejsie, aktualizacja przez API i import edytowanego JSON-a identycznie aktualizują wszystkie odwołania. Proponowany proces zapisuje dla każdego elementu wiersz zawierający typ, ID, starą i nową nazwę, wykonuje zmianę w oddzielnym obszarze roboczym, a następnie sprawdza wynikowy eksport. Automatyczne aktualizacje odwołań wymagają potwierdzenia w tym wyniku.
Lista odwołań przed zmianą i po zmianie pomaga, lecz nie wystarcza. Niezmieniona stara nazwa może nadal prowadzić do błędu, a zamierzona różnica może być poprawna. Porównanie merytoryczne obejmuje także warunki reguł, parametry tagów, sekwencje tagów, ustawienia zgody, stan wstrzymania i kod. Globalne wyszukiwanie i zastępowanie może zmienić wysyłane wartości lub dowolny kod, dlatego nie jest odpowiednią metodą zmiany nazw.
Migracja i odbiór
- Zapisanie pełnego eksportu początkowego, identyfikatora kontenera oraz wersji lub obszaru roboczego.
- Uzgodnienie przedrostków, znaczenia członów i wyjątków oraz utworzenie mapy zmian opartej na ID.
- Oddzielenie zmiany nazw od usuwania elementów i zmian funkcjonalnych, najlepiej w osobnym obszarze roboczym.
- Rozwiązanie konfliktów po synchronizacji zmian z innych obszarów oraz ponowienie odpowiednich porównań.
- Przegląd pełnego eksportu wynikowego i test zmienionych tagów, reguł, zmiennych oraz sekwencji w trybie Preview.
- Zapisanie zaakceptowanych zmian w opisie wersji przed publikacją.
Podgląd uruchamia wersję roboczą na połączonej witrynie; testowe tagi nadal mogą wysyłać rzeczywiste żądania. Środowisko testowe i odpowiednie cele testowe zapobiegają mieszaniu testu nazw z pomiarem produkcyjnym. Sam status uruchomienia nie dowodzi poprawnych danych w systemie docelowym. Kontrola obejmuje oczekiwane wartości parametrów i żądania sieciowe.
Osobny obszar roboczy ułatwia przegląd i wycofanie zmiany, lecz wersje kontenera tworzą jedną historię. Przywrócenie starszej wersji może cofnąć także późniejsze, niezależne zmiany. Plan powrotu wymaga więc uwzględnienia zależności tak samo jak migracja.
Pytania i odpowiedzi
Czy kontrola obejmuje zmienne wbudowane?
Nie. Zmienne wbudowane, na przykład Page URL, są zarządzane osobno od zmiennych użytkownika i występują w wersji pod builtInVariable. Reguły nazw nie zmieniają nazw tych standardowych elementów. Odwołania do zmiennych wbudowanych mogą jednak pojawić się w raporcie.
Czy kontrola może działać automatycznie?
Metoda API accounts.containers.versions.live zwraca opublikowaną ContainerVersion bezpośrednio i akceptuje zakres tagmanager.readonly. Wymagane są włączenie API, autoryzacja OAuth oraz dostęp do właściwego konta lub kontenera; konto usługi jest jedną z obsługiwanych możliwości. Uprawnienia odczytu pozwalają uniknąć zbędnego prawa zapisu, ale nadal potrzebne jest właściwe postępowanie z eksportami i danymi dostępowymi.
Wersja opublikowana nie obejmuje niedokończonych zmian z obszarów roboczych. Kontrola obszaru wymaga odpowiednich metod listowania elementów, wraz ze wszystkimi stronami wyników, albo pełnego eksportu obszaru. Comiesięczny audyt jest opcjonalnym rytmem; przy egzekwowaniu konwencji często bardziej przydatna jest kontrola przed każdą publikacją.
Gdzie powinna znajdować się dokumentacja konwencji?
Utrzymywany dokument zespołowy połączony z notatkami kontenera oraz odpowiednimi notatkami elementów i wersji jest łatwiejszy w zarządzaniu niż sztuczny tag, który nigdy nie może się uruchomić. Wyjątki należą do tej samej dokumentacji i konfiguracji skryptu. Tag notatkowy spoza schematu nazw powodowałby inaczej zastrzeżenie przy każdym audycie.
Źródła
- Google Tag Manager: foldery
- Google Tag Manager: eksport i import kontenerów
- Google Tag Manager API: zasób Tag, SetupTag i TeardownTag
- Google Tag Manager: tagi niestandardowe
- Google Tag Manager: niestandardowe typy zmiennych dla witryn
- Google Tag Manager: obszary robocze
- Google Tag Manager: podgląd i diagnoza kontenerów
- Google Tag Manager API: zasób ContainerVersion
- Google Tag Manager API: versions.live
- Google Tag Manager API: autoryzacja
- Google Tag Manager API: zasób Container
- Google Tag Manager: zapowiedź zmian Google Tag i Tag Managera
- Google Tag Manager: zmiany Google Tag i Tag Managera, 20 sierpnia 2026
- Google Tag Manager API: tags.list i strony wyników
Powiązane artykuły


