English
 Deutsch
 Polski
gzip, Brotli i zstd: czym naprawdę kompresuje dwadzieścia dużych stron

Spis treści
Strona, która dociera do przeglądarki, zwykle nie jest tą stroną, która leży na serwerze, lecz jej spakowaną wersją – a rozpakowanie dzieje się tak wcześnie, że dalej nic już tego nie zauważa.
Który sposób pakuje, uzgadniane jest między przeglądarką a serwerem przy każdym pojedynczym zapytaniu. W obiegu są trzy, a pomiar na dwudziestu dużych stronach głównych pokazuje, że jeden wykonuje prawie całą pracę.
Rozstrzygają to dwie linijki nagłówka
Przeglądarka zaczyna od listy. Jej zapytanie niesie linijkę o nazwie Accept-Encoding, a w niej stoi wszystko, co przeglądarka potrafi rozpakować – dziś zwykle gzip, deflate, br, zstd.
Serwer wybiera z tej listy jeden sposób, pakuje odpowiedź i podaje swój wybór w linijce o nazwie Content-Encoding. Gdy nie wybiera nic, tej linijki po prostu brakuje, a treść podróżuje dokładnie tak, jak leży na dysku.
Jeszcze jedna linijka liczy się wszędzie tam, gdzie po drodze siedzi pamięć podręczna. Vary: Accept-Encoding mówi tej pamięci, że odpowiedź zależy od pytania – żeby spakowana kopia nigdy nie trafiła do programu, który nie umie jej rozpakować.
Nic w tej wymianie nie jest stałym ustawieniem po którejkolwiek stronie. Prowadzona jest od nowa dla każdego pliku, za każdym razem.
Trzy sposoby
gzip jest najstarszy i najbezpieczniejszy. Od dziesięcioleci tkwi w każdej przeglądarce i każdym narzędziu wiersza poleceń, i nigdzie nikt go nie odmawia.
br, skrót od Brotli, jest młodszy i ogólnie pakuje tekst ciaśniej niż gzip, przy porównywalnej prędkości odczytu. Przeglądarki oferują go wyłącznie przez HTTPS.
zstd jest jeszcze młodszy. Jego argumentem jest tempo, nie gęstość: pakuje i rozpakowuje szybciej przy podobnym stosunku, co liczy się przede wszystkim tam, gdzie pakowanie odbywa się na świeżo przy każdym pojedynczym zapytaniu.
deflate stoi na liście głównie z przyzwyczajenia. To ten sam algorytm co gzip w innym opakowaniu i bywa oferowany znacznie częściej, niż kiedykolwiek używany.
Co naprawdę wysyła dwadzieścia stron głównych
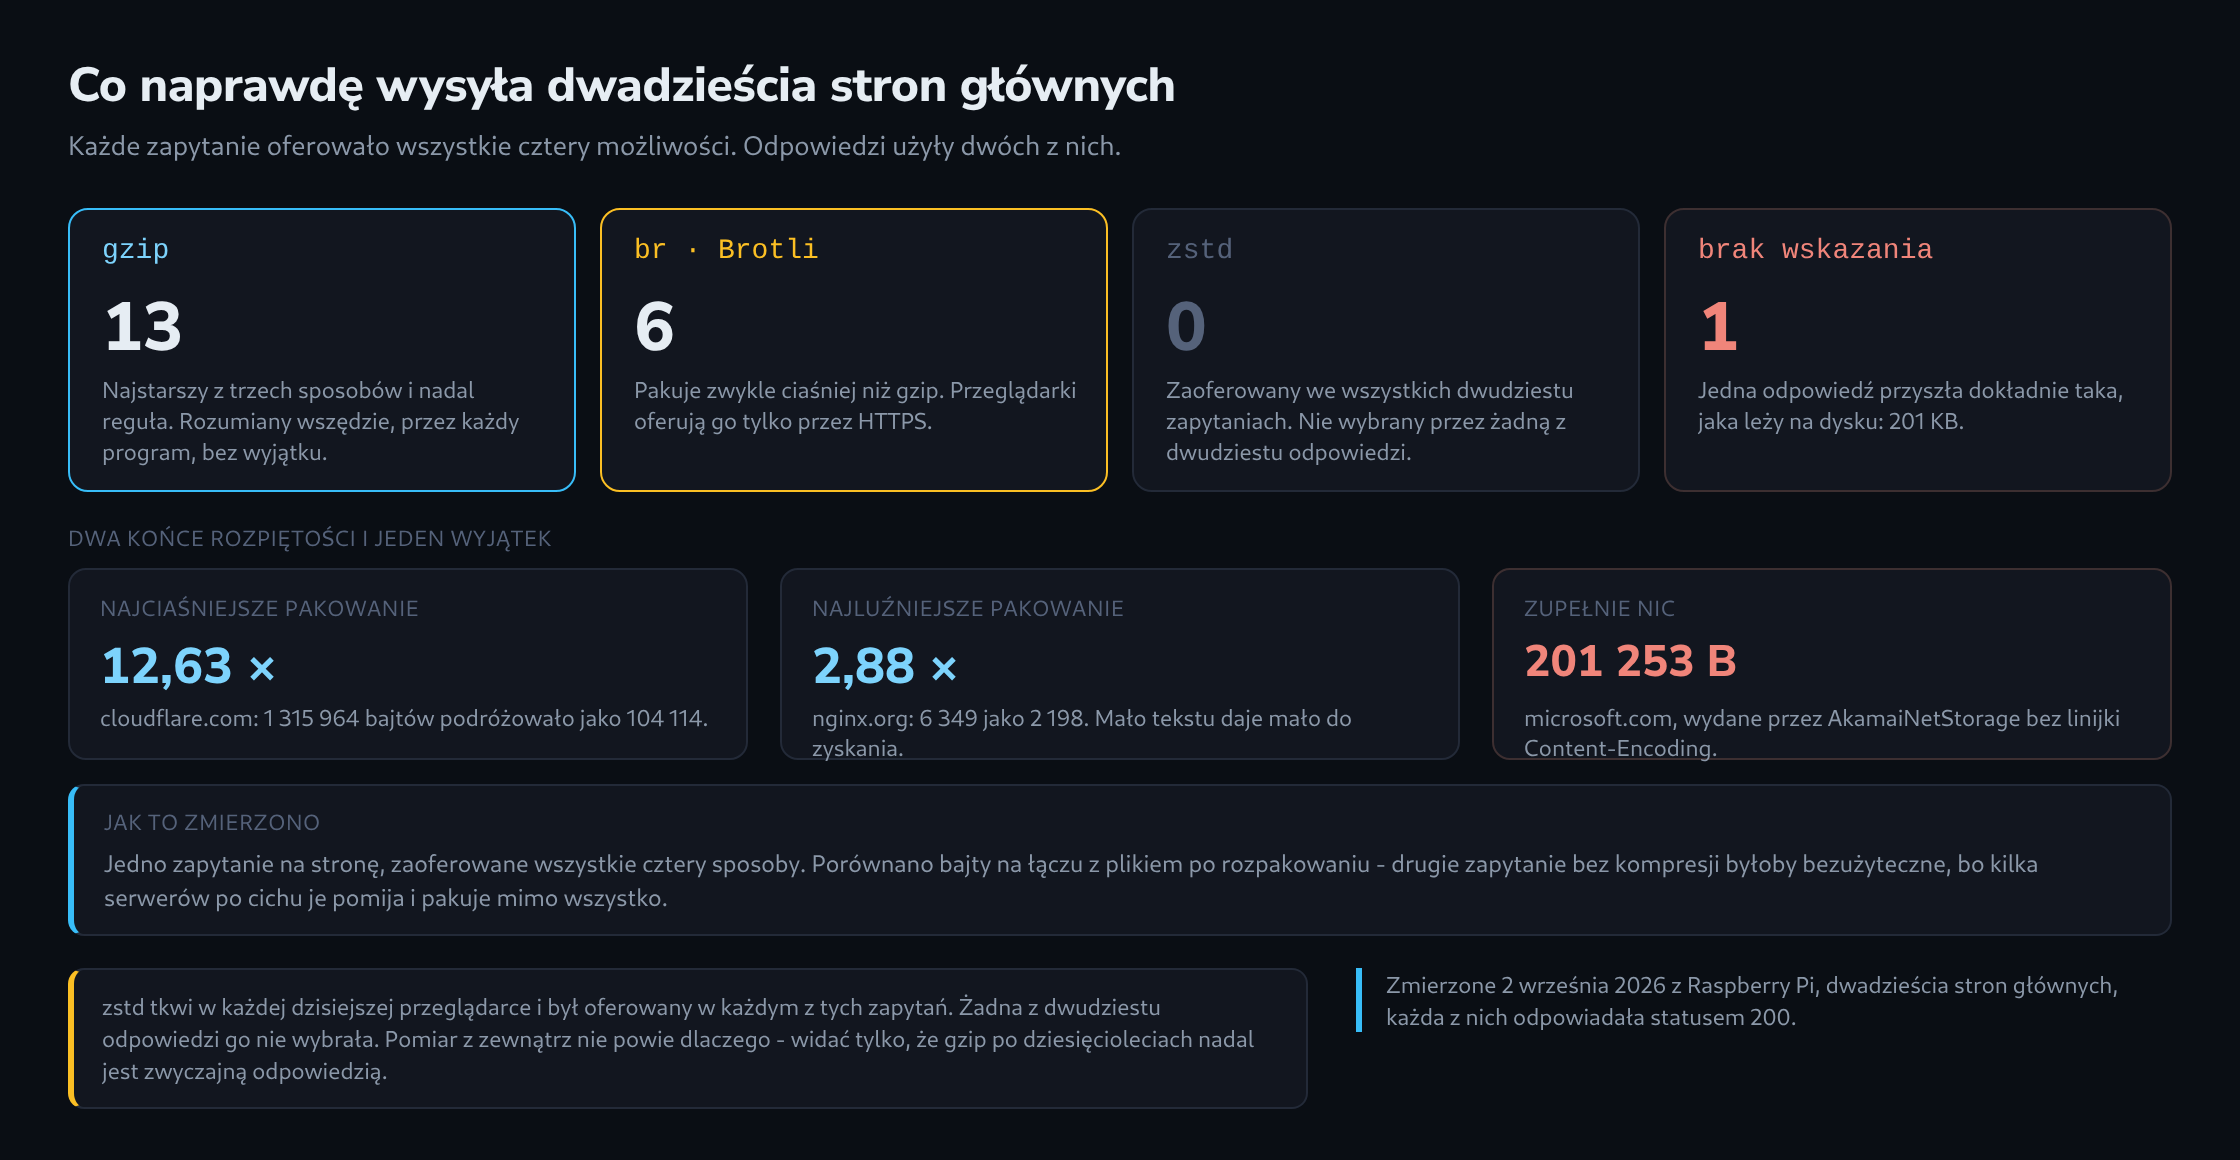
Dwadzieścia dużych stron zapytano 2 września 2026 po jednym razie, każde zapytanie z wszystkimi czterema sposobami w ofercie. Wszystkie dwadzieścia odpowiedziały statusem 200.
Trzynaście odpowiedziało przez gzip: Wikipedia, GitHub, BBC, New York Times, Apple, Spiegel, Heise, python.org, debian.org, kernel.org, gnu.org, nginx.org i postgresql.org.
Sześć odpowiedziało przez br: cloudflare.com, mozilla.org, w3.org, zeit.de, tagesschau.de i php.net.
Jedna odpowiedziała zupełnie niczym.
A zstd, zaoferowany we wszystkich dwudziestu zapytaniach, nie został wybrany przez żadne. Dlaczego, z zewnątrz nie widać. Widać, że gzip po trzech dziesięcioleciach pozostaje zwyczajną odpowiedzią.
Ile to naprawdę oszczędza
Zmierzone stosunki sięgają od 2,88 do 12,63.
Najciaśniej spakowała cloudflare.com: 1 315 964 bajtów znaczników podróżowało jako 104 114. Najluźniej nginx.org z wynikiem 2,88, i nie jest to porażka – strona jest krótka i prosta, a mały plik niesie po prostu mniej powtórzeń, z których dałoby się czerpać.
Rozmiar zatem pomaga. Duże strony złożone przez zestaw narzędzi pakują się znacznie lepiej niż małe pisane ręcznie, bo kompresja żyje z powtórzeń, a strona wygenerowana jest ich pełna.
Brotli też nie wygrywa sam z siebie. tagesschau.de osiągnęła z nim 11,99, podczas gdy zeit.de tym samym sposobem doszła do 3,38. To, co jest pakowane, liczy się bardziej niż czym.
Ta jedna, która nie wysyła nic
microsoft.com dała jedyną odpowiedź bez linijki Content-Encoding: 201 253 bajtów HTML, dokładnie tak jak zapisane.
Odpowiedź podaje swoje pochodzenie dostatecznie wyraźnie – server: AkamaiNetStorage, nagie content-length, żadnego vary. Kompresja usunęłaby z tego jakieś dziewięć dziesiątych.
Trzeba to powiedzieć dokładnie, bo jeden pomiar to jeden pomiar: to, co dotarło tutaj, o tej godzinie, tą drogą, było nieskompresowane. Inny węzeł albo inna droga odpowie być może inaczej. Odpowiedź i tak była prawdziwa, a 201 KB przeszło przez łącze.
Błąd pomiaru, który wymyśla wynik
Pozornie prosty sposób obliczenia współczynnika to wysłać dwa zapytania: jedno z Accept-Encoding: identity, a drugie z wszystkimi sposobami kompresji w ofercie. Następnie dzieli się rozmiar pierwszej odpowiedzi przez rozmiar drugiej.
Ta metoda dała tutaj pozornie jednoznaczny, ale błędny wynik. python.org zwróciła oba razy 11 672 bajty, czyli stosunek dokładnie 1,00. Sugeruje to, że strona w ogóle nie kompresuje odpowiedzi.
Wrażenie myli. Serwer pominął prośbę o brak kompresji i mimo to wysłał gzip, więc oba razy chodziło o rozmiar spakowany. Zmierzona poprawnie python.org pakuje 52 820 bajtów do 11 672 – stosunek 4,52.
Droga, której nie da się zmylić, potrzebuje tylko jednego zapytania: policzyć bajty docierające na łączu i porównać je z plikiem po rozpakowaniu. Obie liczby pochodzą z tej samej odpowiedzi, więc żaden serwer nie dostaje okazji, by odpowiedzieć inaczej na drugie pytanie.
Pytania i odpowiedzi
Czy kompresja opłaca się także przy obrazach i plikach czcionek?
Raczej nie. JPEG, PNG, WebP i WOFF2 są już skompresowane same w sobie, a gzip czy Brotli nie znajdują w nich prawie żadnych powtórzeń, z których dałoby się czerpać; czasem plik nawet nieco rośnie. Serwery ograniczają więc kompresję zwykle do formatów tekstowych, takich jak HTML, CSS, JavaScript, JSON i SVG.
Czy Brotli kosztuje serwer więcej czasu obliczeń niż gzip?
To zależy od poziomu. Brotli zna poziomy jakości od 0 do 11, a najwyższe pakują wyraźnie wolniej niż gzip. Przy odpowiedziach powstających od nowa przy każdym zapytaniu, na przykład przy HTML z WordPressa, zwykle stosowane są więc poziomy średnie, przy których nakład czasu jest zbliżony do gzip, a wynik i tak jest mocniej skompresowany.
Przy plikach statycznych rachunek wygląda inaczej. CSS i JavaScript da się spakować raz, przy wdrożeniu, na najwyższym poziomie i położyć jako gotowy plik obok oryginału; serwer wydaje wtedy już tylko pasującą wersję. Wolny poziom kosztuje czas jeden raz, a nie przy każdym pobraniu. Argument tempa, którym przekonuje zstd, dotyczy właśnie przypadku odwrotnego: pakowania przy każdym zapytaniu.
Czy kompresja przez HTTPS stanowi zagrożenie dla bezpieczeństwa?
W jednym, wąsko określonym przypadku. Atak BREACH wykorzystuje to, że skompresowana odpowiedź staje się krótsza, gdy tekst wstrzyknięty przez atakującego pokrywa się z sekretem w tej samej odpowiedzi. Potrzebne są jednocześnie trzy rzeczy: sekret w treści odpowiedzi, na przykład token CSRF, dane od atakującego, które pojawiają się z powrotem w tej samej odpowiedzi, oraz możliwość wywołania bardzo wielu zapytań i obserwowania długości zaszyfrowanych odpowiedzi.
Typowa obrona zostawia kompresję włączoną, a usuwa jeden z warunków: tokeny maskowane inaczej przy każdym wydaniu strony albo brak niefiltrowanego odbijania danych wejściowych na stronach z sekretami. Kompresji na poziomie TLS, w którą celował starszy atak CRIME, w TLS 1.3 już nie ma; nie ma ona nic wspólnego z Content-Encoding.
Jak wygląda pomiar jednym zapytaniem w wierszu poleceń?
Najprościej za pomocą curl bez automatycznego rozpakowywania: zapytanie oferuje wyłącznie gzip, a odpowiedź trafia do pliku dokładnie w takiej postaci, w jakiej przeszła przez łącze.
curl -s -D - -H "Accept-Encoding: gzip" -o strona.gz https://example.com/
Wypisane nagłówki pokazują, czy serwer rzeczywiście ustawił Content-Encoding: gzip. Następnie wc -c < strona.gz podaje rozmiar spakowanej treści w postaci przesłanej, a gzip -dc strona.gz | wc -c rozmiar po rozpakowaniu; stosunek obu liczb to szukana wartość. Obie pochodzą z tej samej odpowiedzi i właśnie o to chodzi.
Jeśli brakuje linijki Content-Encoding, plik w ogóle nie jest spakowany, a gzip kończy pracę komunikatem o błędzie. To także jest wynik, przypadek microsoft.com. Dla Brotli obowiązuje to samo z br w ofercie i programem brotli do rozpakowania, o ile jest zainstalowany.
Powiązane artykuły